Crawled – currently not indexed: ko tas nozīmē un kā to novērst

Google apmeklēja jūsu URL, to izlasīja un atstāja ārpus meklēšanas. Lūk, kā noteikt, kuras lapas ir pelnījušas otru iespēju, un ko Google iesaka darīt, lai tās atgrieztos indeksā.
Crawled – currently not indexed (pārmeklēta, pašlaik nav indeksēta) nozīmē, ka Googlebot ielādēja jūsu lapu un nolēma to nepievienot Google indeksam, tāpēc tā nevar parādīties meklēšanā. Pārskata Page indexing palīdzībā tas izskaidrots šādi: lapa tika pārmeklēta, bet netika indeksēta, un tā "nākotnē var tikt indeksēta, bet var arī netikt".
Cēlonis parasti ir pati lapa, nevis tehnisks bloķējums. Tālāk uzzināsiet, kā katram URL izlemt, vai lapu labot, atzīmēt ar noindex vai dzēst, un cik ilgi pēc Google datiem aizņem labojums. Pārskats jums ir jauns? Sāciet ar šo Google Search Console ceļvedi.
Ko nozīmē "Crawled – currently not indexed"?
Šis statuss nozīmē, ka Google pārmeklēja lapu un nolēma to neindeksēt. Nekas nebloķēja Googlebot: Google pagaidām nolēma lapu neiekļaut. Pareizi izprast statusu palīdz divas atšķirības.
Pārmeklēta un indeksēta
Pārmeklēšana ir lapas lejupielāde, ko veic Googlebot. Indeksēšana ir lapas saglabāšana Google sistēmā, lai tā varētu parādīties meklējumos. Lapu var pārmeklēt daudzas reizes, bet tā tik un tā var nekad netikt indeksēta.
Rīka URL Inspection palīdzībā teikts, ka lapas kvalitātei jābūt "pietiekami augstai, lai attaisnotu indeksēšanu", un rīka tiešraides tests šo statusu vispār nevar pārbaudīt.
Ar ko tas atšķiras no "Discovered – currently not indexed"
Discovered – currently not indexed (atklāta, pašlaik nav indeksēta) ir vienu soli agrāk: Google atrada URL, bet atlika pārmeklēšanu, lai nepārslogotu jūsu vietni, tāpēc pēdējās pārmeklēšanas datums ir tukšs.
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| Vai Google pārmeklēja? | Nē | Jā |
| Pēdējās pārmeklēšanas datums | Tukšs | Norādīts datums |
| Parastais iemesls | Pārmeklēšana atlikta, lai nepārslogotu vietni | Google izlasīja lapu un to izlaida |
| Vispirms skatieties uz | Pārmeklēšanas jaudu ļoti lielās vietnēs | Satura kvalitāti, dublikātiem, canonical |
Google arī norāda: "Tas, ka lapa nav indeksēta, ne vienmēr ir slikti." Lapām ar noindex, robots.txt bloķētiem URL, dublikātiem un 404 lapām bez aizstājēja ir jāpaliek ārpus indeksa.
Kāpēc Google pārmeklē lapas, bet tās neindeksē
Indeksēšanai ir kvalitātes latiņa, kuras pārmeklēšanai nav. Google pārmeklēšanas budžeta ceļvedī teikts, ka pieprasījums pēc pārmeklēšanas pieaug līdz ar jūsu satura vērtību un unikalitāti.
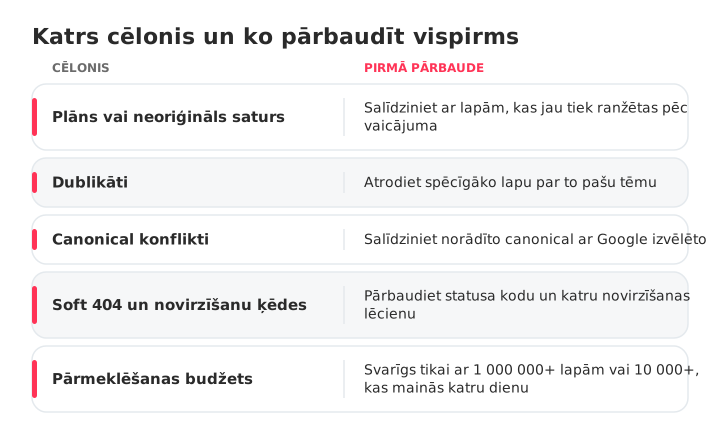
Lielākā daļa skarto URL atbilst kādam no šiem cēloņiem, un katram ir sava pirmā pārbaude:
- Plāns vai neoriģināls saturs: lapa atkārto to, kas jau tiek ranžēts.
- Dublikāti: tagu arhīvi, kārtoti URL, divi raksti par vienu tēmu. Lūk, kā atklāt un novērst atslēgvārdu kanibalizāciju.
- Canonical konflikti: salīdziniet savu norādīto canonical ar to, ko izvēlējās Google. Kad Google izvēlas citu URL, lapa parasti pāriet uz Alternate page with proper canonical tag vai dublikāta statusu.
- Soft 404 un novirzīšanu ķēdes: Google norāda, ka soft 404 izšķiež pārmeklēšanas budžetu.
- Pārmeklēšanas budžets: tas ir svarīgs vietnēm ar vairāk nekā 1 000 000 lapu, kas mainās katru nedēļu, vai vairāk nekā 10 000, kas mainās katru dienu. Lielākajai daļai vietņu tas nav cēlonis.
Latiņa pacēlās divos datētos soļos. 2022. gada 18. augustā Google paziņoja par noderīga satura atjauninājumu – visas vietnes signālu – un norādīja, ka nenoderīga satura noņemšana var palīdzēt pārējai vietnei. 2024. gada 5. martā Google paziņoja par pamata atjauninājumu, lai rādītu mazāk klikšķu piesaistei radīta satura, kopā ar jaunu surogātpasta politiku pret mērogota satura ļaunprātīgu izmantošanu.
Google noderīga satura vadlīnijās teikts, ka E-E-A-T nav konkrēts ranžēšanas faktors, ka vissvarīgākā ir uzticamība un ka nav ieteicama vārdu skaita. Lapas piepildīšana ar liekvārdību to neizlabos.
Kā GSC atrast un diagnosticēt skartās lapas
Atveriet pārskatu Page indexing (agrāk Coverage), pārbaudiet paraugu un sagrupējiet sarakstu pēc likumsakarībām. Google norāda, ka vietnēm ar mazāk nekā 500 lapām šis pārskats, visticamāk, nav vajadzīgs.
Skarto URL atrašana pārskatā Pages
- Google Search Console atveriet Indexing › Pages.
- Sadaļā "Why pages aren't indexed" noklikšķiniet uz Crawled – currently not indexed.
- Noklikšķiniet uz Export un lejupielādējiet sarakstu.
Pārskatā tiek rādīti līdz 1000 URL piemēriem, ne obligāti visi, tāpēc lielā vietnē eksports ir tikai paraugs.
Lapu pārbaude ar rīku URL Inspection
Pārbaudiet piecus līdz desmit eksportētus URL un apskatiet pēdējās pārmeklēšanas datumu un Google-selected canonical (Google izvēlēto canonical). Ja canonical norāda citur, Google redz dublikātu; ja pārmeklēšanas datums ir mēnešiem vecs, Google, visticamāk, atgriežas reti.
Likumsakarību meklēšana simtos URL
Sakārtojiet eksportu pēc mapes, veidnes un URL parametra, tad saskaitiet katru grupu. Pieņemsim, ka 300 URL sadalās 180 /tag/ lapās, 70 ?sort= URL un 50 rakstos: tie ir trīs lēmumi, nevis 300.
Labot, noindex vai dzēst: izlemiet, ko pelnījis katrs URL
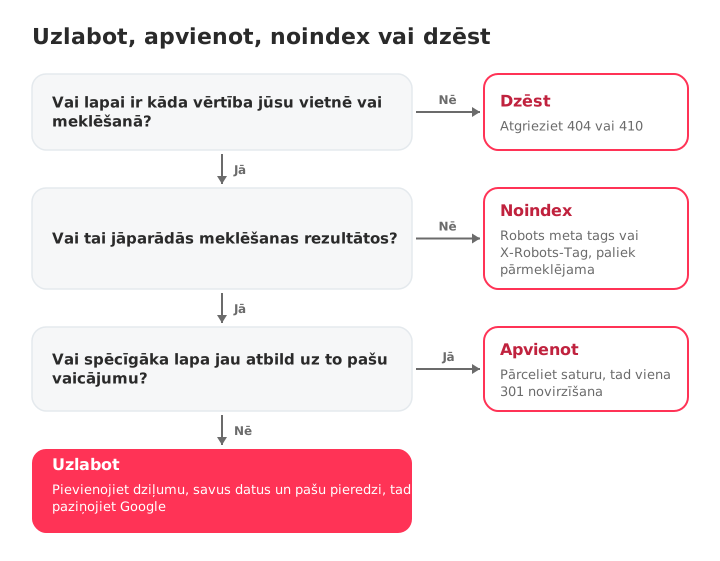
Katrs URL ir pelnījis vienu no četriem iznākumiem. Pajautājiet: vai meklētājs priecātos šeit nonākt, un vai šī ir vienīgā lapa jūsu vietnē, kas atbild uz šo vaicājumu?
| Lapas veids | Piemērs | Lēmums | Kā |
|---|---|---|---|
| Noderīga un unikāla, bet plāna | 300 vārdu ceļvedis par tēmu, kuru pārzināt | Uzlabot | Pievienojiet dziļumu un pašu pieredzētas detaļas |
| Dublē spēcīgāku lapu | Divi raksti par vienu vaicājumu | Apvienot | Pārceliet saturu, tad 301 novirzīšana |
| Noderīga vietnē, ne meklēšanā | Tagu arhīvi, iekšējā meklēšana, pateicības lapas | Noindex | Robots meta tags vai X-Robots-Tag |
| Bez vērtības, bez aizstājēja | Beigušās akcijas, testa lapas | Dzēst | Atgrieziet 404 vai 410 |
Google pārmeklēšanas budžeta ceļvedis apstiprina pēdējās divas rindas: noņemtām lapām atgrieziet 404 vai 410 un apvienojiet dublikātus. 404 Search Console ir sagaidāms lapām, kuras noņēmāt apzināti.
Tieši ar noindex šķirošanā visbiežāk kļūdās:
Ne šādi: noindex tags /tag/ lapās, kamēr robots.txt bloķē /tag/. Googlebot nevar ielādēt lapas, tāpēc tagu nekad neredz.
Bet šādi: /tag/ paliek pārmeklējams un satur noindex kā meta tagu vai X-Robots-Tag galveni.
Saskaņā ar Google noindex dokumentāciju noteikums nedarbojas robots.txt failā, un reti apmeklētās lapās atkārtota pārmeklēšana var ilgt mēnešus. Kad tags ir nolasīts, šie URL pāriet uz Excluded by 'noindex' tag, un tieši to jūs tiem vēlaties.
Kā izlabot indeksēšanas vērtās lapas
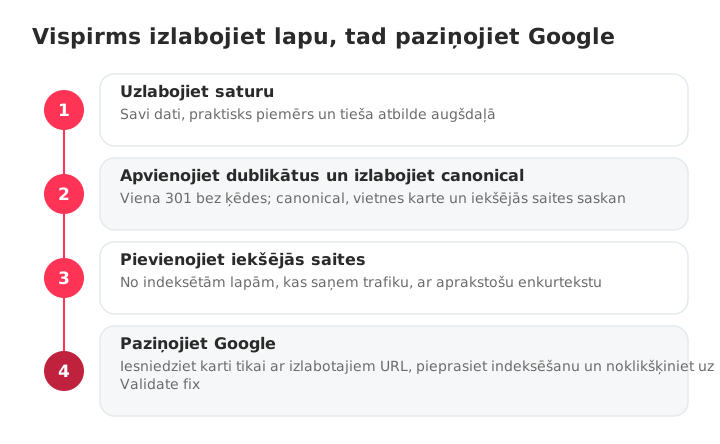
Vispirms padariet lapu indeksēšanas vērtu, tad paziņojiet Google. Pieprasot indeksēt nemainītu lapu, jūs lūdzat Google atkārtot jau pieņemtu lēmumu. Secība:
- Uzlabojiet saturu.
- Apvienojiet dublikātus un izlabojiet canonical.
- Pievienojiet iekšējās saites.
- Iesniedziet mērķtiecīgu vietnes karti un pieprasiet indeksēšanu.
Uzlabojiet satura dziļumu un oriģinalitāti
Pārrakstiet, domājot par vaicājumu, nevis vārdu skaitu: pievienojiet savus datus, ekrānuzņēmumus, praktisku piemēru un tiešu atbildi lapas augšdaļā.
Piemēram, ņemiet plānu 300 vārdu ceļvedi: pievienojiet pašu iegūtu datu kopu un praktisku piemēru, ievietojiet saiti uz to no diviem rakstiem, kas jau saņem trafiku, un tikai tad pievienojiet to mērķtiecīgai vietnes kartei.
Apvienojiet dublikātus un izlabojiet canonical
Kad divi URL aptver vienu un to pašu, paturiet vienu, pārceliet uz to noderīgo saturu un otru novirziet ar 301 tieši uz to, bez ķēdes. Tad pārbaudiet, vai canonical, vietnes karte un iekšējās saites saskan un vai nav palicis kāds nejaušs noindex.
Pievienojiet iekšējās saites no lapām, kuras Google jau novērtē
Uz katru izlaboto lapu ievietojiet saites no indeksētām lapām, kas saņem trafiku, ar aprakstošu enkurtekstu. Jebkurš vietnes rāpuļprogrammas rīks var uzskaitīt bāreņlapas (bez iekšējām saitēm), filtrējot pēc nulles ienākošajām saitēm. Pilna metode ir iekšējo saišu stratēģijas ceļvedī.
Pārbaudiet lapu arī tālrunī un pārskatā Core Web Vitals: bojātu mobilo lapu var ātri izslēgt.
Iesniedziet mērķtiecīgu vietnes karti un pieprasiet indeksēšanu
Izveidojiet vietnes karti tikai ar izlabotajiem URL, iesniedziet to un filtrējiet pēc tās pārskatu Pages, pirms noklikšķināt uz Validate fix. Google to iesaka, lai paātrinātu validāciju. Ja vispirms vajadzīgs jūsu pašreizējais fails, atrodiet savas vietnes karti.
Google ignorē priority un changefreq, tāpēc tā vietā uzturiet precīzu lastmod. Tad rīkā URL Inspection prioritārajiem URL noklikšķiniet uz Request indexing: Google piemēro kvotu un norāda, ka atkārtoti pieprasījumi neko nepaātrina.
Cik ilgā laikā lapa tiek indeksēta pēc labojuma?
Rēķinieties ar laiku no dienas līdz vairākām nedēļām, un indeksēšana nekad nav garantēta. Dažādās lapās Google min dažādus termiņus, tāpēc šeit tie ir blakus:
| Ko jūs izdarījāt | Ko saka Google | Avots |
|---|---|---|
| Lūdzāt Google pārmeklēt atkārtoti | No dažām dienām līdz dažām nedēļām | Ask Google to recrawl |
| Request indexing | Parasti aptuveni diena, līdz nedēļai vai divām, ar dienas limitu | URL Inspection palīdzība |
| Validate fix | Līdz aptuveni divām nedēļām, dažreiz daudz ilgāk | Page indexing palīdzība |
Tie ir Google norādītie termiņi, nevis atkopšanās gadījumi. Pārbaudiet pārskatu Pages katru nedēļu; ja pēc šiem termiņiem izlabotie URL nav mainījušies, atgriezieties pie satura.
Kā novērst, ka jaunas lapas nonāk šajā statusā
Profilakse ir rutīna: pārbaudiet katru lapu pirms publicēšanas un reizi mēnesī pārskatiet Search Console. Pirms publicēšanas pārliecinieties, ka lapa:
- Atbild uz vaicājumu, uz kuru neatbild neviena cita jūsu vietnes lapa.
- Pievieno jūsu pašu datus, piemērus vai pieredzi.
- Satur uz sevi norādošu canonical un nesatur nejaušu noindex.
- Ir vietnes kartē ar precīzu lastmod.
- Ir ar norādītu autoru un, kur piemērojams, strukturētiem datiem.
- Saņem saiti no saistītas, indeksētas lapas.
Reizi mēnesī salīdziniet pārskatu Pages ar iepriekšējo mēnesi; problēma sarakstā paliek 90 dienas pēc tam, kad pazudis tās pēdējais gadījums. Vietnēm ar vairāk nekā tūkstoš lapām vajadzētu sekot arī pārskatam Crawl Stats.
SEOcrawl AI pārvalda tehnisko pusi lielā mērogā. Crawler pārmeklē katru lapu un sniedz Audit Health Score, ar problēmām, kas sadalītas pēc Indexability, Crawlability, On-Page un citām kategorijām. Tā skats Indexation grupē jūsu URL pēc Search Console pārklājuma statusa, lai jūs redzētu, cik no tiem ir statusā "Crawled – currently not indexed", un varētu sekot skaitam laika gaitā.
Starp pārmeklēšanām SEO Monitor brīdina, kad svarīga lapa iegūst noindex, maina canonical, atgriež 404 vai pazūd no vietnes kartes. Tā pati platforma seko jūsu zīmola redzamībai ChatGPT, Claude, Gemini, Perplexity un Copilot, tāpēc SEO un GEO ir vienuviet.
BUJ
Ko nozīmē "Crawled – currently not indexed"?
Tas nozīmē, ka Googlebot ielādēja jūsu lapu un nolēma to nepievienot Google indeksam, tāpēc tā nevar parādīties meklēšanā. Nekas nebloķēja pārmeklēšanu: Google izlasīja lapu un pagaidām nolēma to neiekļaut. Tas nav manuāls sods, un lapa nākotnē var tikt indeksēta, bet var arī netikt.
Vai tas ir tas pats, kas "Discovered – currently not indexed"?
Nē. "Discovered" nozīmē, ka Google zina URL, bet atlika tā pārmeklēšanu, tāpēc pēdējās pārmeklēšanas datums ir tukšs. "Crawled" nozīmē, ka Google jau apmeklēja un izlasīja lapu, bet pēc tam nolēma to neindeksēt. Ja statuss ir Discovered, ļoti lielās vietnēs skatieties uz pārmeklēšanas jaudu; ja Crawled – uz satura kvalitāti, dublikātiem un canonical.
Vai "Crawled – currently not indexed" kaitē manam SEO?
Pats par sevi nē: šis statuss nav sods, un skartā lapa zaudē tikai savu meklēšanas trafiku. Risks ir apjomā, jo lielu nenoderīga satura daļu Google uztver kā visas vietnes signālu. Tagu arhīvs ārpus indeksa neko nemaksā; produkta lapa gan. Ja skaits pieaug ik reizi, kad kaut ko publicējat, uztveriet to kā visas vietnes satura problēmu, nevis kā atsevišķu URL sarakstu.
Cik ilgā laikā lapa tiek indeksēta pēc labojuma?
Rēķinieties ar laiku no dienas līdz vairākām nedēļām, un indeksēšana nekad nav garantēta. Google norāda, ka atkārtota pārmeklēšana aizņem no dažām dienām līdz dažām nedēļām, Request indexing parasti tiek apstrādāts aptuveni dienas laikā, bet var aizņemt nedēļu vai divas, un Validate fix parasti ilgst līdz aptuveni divām nedēļām.
Vai indeksēšanas pieprasījums palīdz?
Tikai pēc tam, kad esat lapu mainījuši. Pieprasot indeksēt nemainītu lapu, jūs lūdzat Google atkārtot jau pieņemtu lēmumu. Pieprasījumiem ir dienas kvota, un Google norāda, ka viena un tā paša URL sūtīšana vairākas reizes neko nepaātrina.
Vai lapas pievienošana XML vietnes kartei palīdz?
Tā palīdz Google atrast URL, nevis to indeksēt. Google iesniegtu vietnes karti sauc par "tikai norādi", un šīs lapas jau ir atrastas un izlasītas. Pēc labojuma vietnes kartes uzdevums ir sagrupēt URL, kurus vēlaties pārbaudīt atkārtoti. Katrā vietnes kartes failā var būt līdz 50 000 URL vai 50 MB.
Kāpēc "Crawled – currently not indexed" validācija neizdevās?
Validācija apstājas, tiklīdz Google grupā atrod vienu vēl nelabotu URL, tāpēc viena atlikusi lapa var izgāzt visu grupu. Izlabojiet katru grupas URL vai sašauriniet grupu, filtrējot pārskatu pēc vietnes kartes, kurā ir tikai izlabotie URL, un validējiet vēlreiz.
Kā SEOcrawl AI palīdz ar lapām, kuras Google pārmeklē, bet neindeksē?
SEOcrawl AI atrod šī statusa cēloņus pašā vietnē. Crawler rāda katra URL veselības rādītāju, HTTP statusa kodu un pārmeklēšanas dziļumu, lai jūs pamanītu lapas, līdz kurām Google grūti nokļūt. Skats Indexation grupē jūsu URL pēc Search Console pārklājuma statusa, un SEO Monitor brīdina, kad svarīga lapa iegūst noindex, maina canonical, atgriež 404 vai pazūd no vietnes kartes.
Autors: David Kaufmann

Pēdējos 10+ gadus esmu pavadījis, pilnībā aizrāvies ar SEO — un, godīgi sakot, es to nevēlētos citādi.
Mana karjera sasniedza jaunu līmeni, kad strādāju par vecāko SEO speciālistu Chess.com — vienā no 100 visapmeklētākajām vietnēm visā internetā. Darbs šādā mērogā, aptverot miljoniem lapu, desmitiem valodu un vienu no konkurētspējīgākajām SERPs, iemācīja man to, ko neviens kurss vai sertifikāts nekad nespētu. Šī pieredze mainīja manu skatījumu uz to, kā patiesībā izskatās izcils SEO — un kļuva par pamatu visam, ko esmu izveidojis kopš tā laika.
No šīs pieredzes es nodibināju SEO Alive — aģentūru zīmoliem, kas nopietni domā par organisko izaugsmi. Mēs neesam šeit, lai pārdotu dashboards un ikmēneša atskaites. Mēs esam šeit, lai veidotu stratēģijas, kas patiešām rada rezultātus, apvienojot labāko no klasiskā SEO ar aizraujošo jauno Generative Engine Optimization (GEO) pasauli — nodrošinot, ka jūsu zīmols parādās ne tikai Google zilajās saitēs, bet arī AI ģenerētajās atbildēs, ko ChatGPT, Perplexity un Google AI Overviews katru dienu piegādā miljoniem cilvēku.
Un tā kā es nevarēju atrast rīku, kas pareizi apstrādātu abas šīs pasaules, es izveidoju to pats — SEOcrawl AI, enterprise SEO intelligence platformu, kas vienuviet apvieno rankings, tehniskos auditus, backlinks uzraudzību, crawl veselību un AI zīmola redzamības izsekošanu. Tā ir platforma, par kuras esamību es vienmēr biju vēlējies.
Atklājiet vairāk šī autora satura

