Pagina scansionata ma attualmente non indicizzata: cosa significa e come risolvere

Google ha visitato il tuo URL, l'ha letto e l'ha lasciato fuori dalla ricerca. Ecco come capire quali pagine meritano una seconda possibilità e cosa indica Google per farle rientrare nell'indice.
Pagina scansionata ma attualmente non indicizzata (nell'interfaccia in inglese, «Crawled – currently not indexed») significa che Googlebot ha recuperato la tua pagina e ha deciso di non aggiungerla all'indice di Google, quindi non può comparire nella ricerca. La guida del rapporto Indicizzazione delle pagine lo spiega così: la pagina è stata scansionata ma non indicizzata, e «potrebbe essere indicizzata o meno in futuro».
La causa di solito è la pagina stessa, non un blocco tecnico. Qui sotto vedrai come decidere, URL per URL, se correggere, applicare noindex o eliminare ogni pagina, e quanto tempo richiede una correzione secondo Google. Sei alle prime armi con il rapporto? Parti da questa guida a Google Search Console.
Cosa significa «Pagina scansionata ma attualmente non indicizzata»?
Lo stato significa che Google ha scansionato la pagina e ha scelto di non indicizzarla. Nulla ha bloccato Googlebot: Google ha deciso di lasciare fuori la pagina, per ora. Due distinzioni ti aiutano a leggere correttamente lo stato.
Scansionata o indicizzata
Scansionare significa che Googlebot scarica una pagina. Indicizzare significa che Google la memorizza perché possa comparire nelle ricerche. Una pagina può essere scansionata molte volte senza mai essere indicizzata.
La guida dello strumento Controllo URL dice che la qualità di una pagina deve essere «abbastanza alta da giustificarne l'indicizzazione», e il test live non è in grado di rilevare questo stato.
In cosa si differenzia da «Rilevata, ma attualmente non indicizzata»
Rilevata, ma attualmente non indicizzata arriva un passo prima: Google ha trovato l'URL ma ha rimandato la scansione per non sovraccaricare il sito, quindi la data dell'ultima scansione è vuota.
| Rilevata, ma attualmente non indicizzata | Pagina scansionata ma attualmente non indicizzata | |
|---|---|---|
| Scansionata da Google? | No | Sì |
| Data dell'ultima scansione | Vuota | Una data |
| Motivo tipico | Scansione rimandata per non sovraccaricare il sito | Google ha letto la pagina e l'ha scartata |
| Cosa controllare per primo | Capacità di scansione, sui siti molto grandi | Qualità dei contenuti, duplicati, canonical |
Google dice anche che «una pagina non indicizzata non è necessariamente un male». Le pagine con noindex, gli URL bloccati nel robots.txt, i duplicati e i 404 senza sostituto devono restare fuori.
Perché Google scansiona pagine senza indicizzarle
L'indicizzazione ha un livello minimo di qualità che la scansione non ha. La guida al crawl budget di Google dice che la domanda di scansione cresce con il valore e l'unicità dei tuoi contenuti.
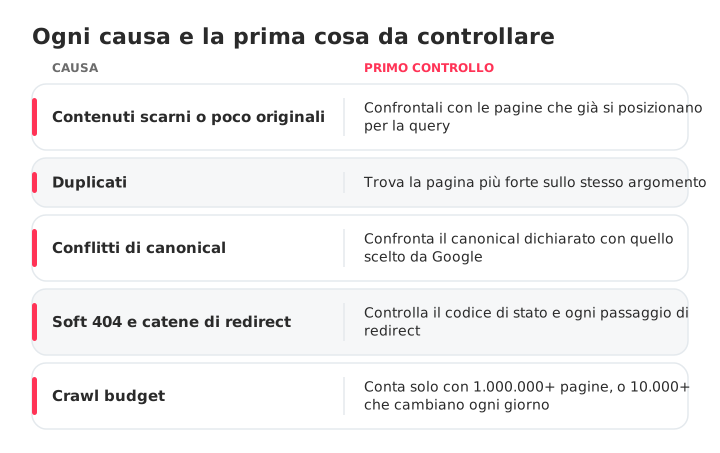
La maggior parte degli URL interessati rientra in una di queste cause, ognuna con il suo primo controllo:
- Contenuti scarni o poco originali: la pagina ripete ciò che già si posiziona.
- Duplicati: archivi dei tag, URL ordinati, due articoli sullo stesso argomento. Ecco come individuare e risolvere la cannibalizzazione delle keyword.
- Conflitti di canonical: confronta il canonical che dichiari con quello selezionato da Google. Quando Google sceglie un altro URL, di solito la pagina passa a Pagina alternativa con tag canonical appropriato o a uno stato di duplicato.
- Soft 404 e catene di redirect: Google dice che i soft 404 sprecano crawl budget.
- Crawl budget: conta per i siti con oltre 1.000.000 di pagine che cambiano ogni settimana o oltre 10.000 che cambiano ogni giorno. Per la maggior parte dei siti non è la causa.
L'asticella si è alzata in due momenti precisi. Il 18 agosto 2022 Google ha annunciato l'aggiornamento dei contenuti utili, un segnale a livello di sito, e ha detto che rimuovere i contenuti poco utili poteva aiutare il resto del sito. Il 5 marzo 2024 Google ha annunciato un core update per mostrare meno contenuti creati per attirare clic, insieme a una nuova norma antispam contro l'abuso di contenuti su larga scala.
Le linee guida sui contenuti utili di Google dicono che l'E-E-A-T non è uno specifico fattore di ranking, che la affidabilità è ciò che conta di più e che non esiste un numero di parole preferito. Allungare la pagina non risolve.
Come trovare e diagnosticare le pagine interessate in GSC
Apri il rapporto Indicizzazione delle pagine (in passato Copertura), controlla un campione e raggruppa l'elenco per schema. Google precisa che i siti con meno di 500 pagine probabilmente non hanno bisogno di questo rapporto.
Trovare gli URL interessati nel rapporto Pagine
- In Google Search Console, vai a Indicizzazione › Pagine.
- In «Perché le pagine non sono indicizzate», fai clic su Pagina scansionata ma attualmente non indicizzata.
- Fai clic su Esporta e scarica l'elenco.
Il rapporto mostra fino a 1.000 URL di esempio, non necessariamente tutti, quindi su un sito grande l'esportazione è un campione.
Controllare le pagine con lo strumento Controllo URL
Controlla da cinque a dieci URL esportati e guarda la data dell'ultima scansione e l'URL canonico selezionato da Google. Un canonical che punta altrove significa che Google vede un duplicato; una data di scansione vecchia di mesi indica che Google ci torna di rado.
Individuare schemi ricorrenti tra centinaia di URL
Ordina l'esportazione per cartella, template e parametro URL, poi conta ogni gruppo. Immagina 300 URL divisi in 180 pagine /tag/, 70 URL con ?sort= e 50 articoli: sono tre decisioni, non 300.
Correggere, noindex o eliminare: decidi cosa merita ogni URL
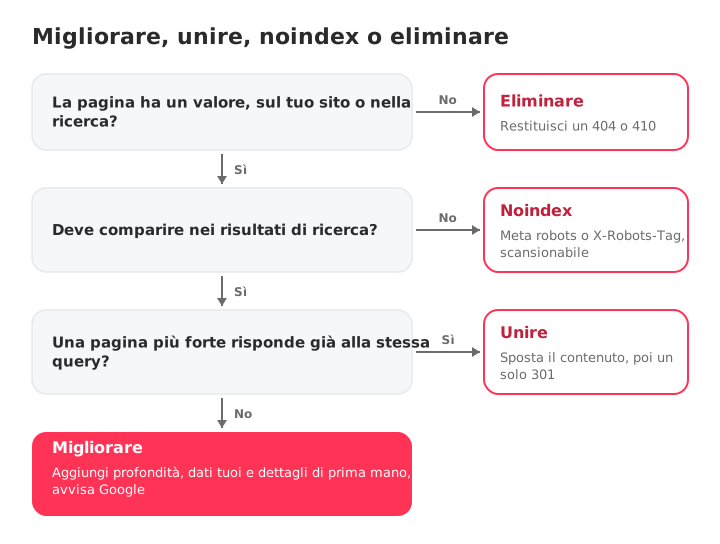
Ogni URL merita uno di quattro esiti. Chiediti: chi cerca sarebbe contento di arrivare qui, ed è questa l'unica pagina del tuo sito che risponde alla query?
| Tipo di pagina | Esempio | Decisione | Come |
|---|---|---|---|
| Utile e unica, ma scarna | Una guida di 300 parole su un tema che conosci | Migliorare | Aggiungi profondità e dettagli di prima mano |
| Duplica una pagina più forte | Due articoli per la stessa query | Unire | Sposta il contenuto, poi redirect 301 |
| Utile sul sito, non nella ricerca | Archivi dei tag, ricerca interna, pagine di ringraziamento | Noindex | Meta tag robots o X-Robots-Tag |
| Nessun valore, nessun sostituto | Promozioni scadute, pagine di test | Eliminare | Restituisci un 404 o 410 |
La guida al crawl budget di Google conferma le ultime due righe: restituisci 404 o 410 per le pagine rimosse e consolida i duplicati. Un 404 in Search Console è normale per le pagine che hai rimosso di proposito.
Il noindex è il punto in cui lo smistamento va storto più spesso:
Non così: un tag noindex sulle pagine /tag/ mentre il robots.txt blocca /tag/. Googlebot non può recuperare le pagine, quindi non vede mai il tag.
Così: /tag/ resta scansionabile e porta il noindex come meta tag o come intestazione X-Robots-Tag.
Secondo la documentazione sul noindex di Google, la regola non funziona all'interno del robots.txt, e sulle pagine visitate di rado la nuova scansione può richiedere mesi. Una volta letto il tag, quegli URL passano a Esclusa in base al tag 'noindex', che è proprio ciò che vuoi per loro.
Come correggere le pagine che meritano l'indicizzazione
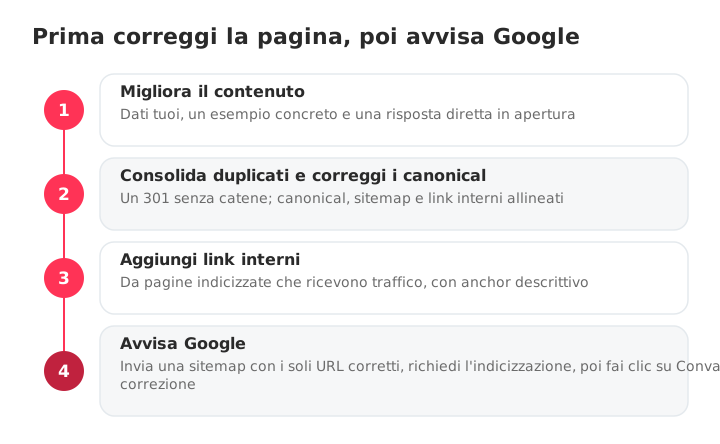
Prima rendi la pagina degna di essere indicizzata, poi avvisa Google. Richiedere l'indicizzazione di una pagina invariata significa chiedere a Google di ripetere una decisione che ha già preso. L'ordine:
- Migliora il contenuto.
- Consolida i duplicati e correggi i canonical.
- Aggiungi link interni.
- Invia una sitemap mirata e richiedi l'indicizzazione.
Migliora la profondità e l'originalità dei contenuti
Riscrivi pensando alla query, non al numero di parole: aggiungi dati tuoi, screenshot, un esempio concreto e una risposta diretta in apertura.
Per esempio, prendi una guida scarna di 300 parole: aggiungi un set di dati di prima mano e un esempio concreto, inserisci un link verso di essa da due articoli che già ricevono traffico e solo allora aggiungila a una sitemap mirata.
Consolida i duplicati e correggi i canonical
Quando due URL trattano lo stesso argomento, tienine uno, sposta lì il contenuto utile e fai un redirect 301 dell'altro direttamente verso di esso, senza catene. Poi verifica che canonical, sitemap e link interni siano allineati e che non sia rimasto nessun noindex dimenticato.
Aggiungi link interni da pagine che Google già apprezza
Collega ogni pagina corretta da pagine indicizzate che ricevono traffico, con un anchor text descrittivo. Qualsiasi crawler può elencare le pagine orfane (zero link interni) filtrando per zero link in entrata. Il metodo completo è in questa guida alla strategia di link interni.
Controlla anche la pagina da smartphone e nel rapporto Segnali web essenziali (Core Web Vitals): una pagina non funzionante su mobile si esclude in fretta.
Invia una sitemap mirata e richiedi l'indicizzazione
Crea una sitemap con i soli URL che hai corretto, inviala e usala per filtrare il rapporto Pagine prima di fare clic su Convalida correzione. Google lo suggerisce per velocizzare la convalida. Se prima ti serve il file attuale, trova la sitemap del tuo sito.
Google ignora priority e changefreq, quindi tieni piuttosto lastmod accurato. Poi fai clic su Richiedi indicizzazione nello strumento Controllo URL per gli URL prioritari: Google applica una quota e dice che ripetere le richieste non velocizza nulla.
Quanto tempo richiede l'indicizzazione dopo una correzione?
Metti in conto da un giorno a diverse settimane, e l'indicizzazione non è mai garantita. Google indica tempi diversi in pagine diverse, quindi eccoli a confronto:
| Cosa hai fatto | Cosa dice Google | Fonte |
|---|---|---|
| Chiesto a Google una nuova scansione | Da qualche giorno a qualche settimana | Chiedere a Google di ripetere la scansione |
| Richiedi indicizzazione | Di solito circa un giorno, fino a una o due settimane, con un limite giornaliero | Guida di Controllo URL |
| Convalida correzione | Fino a circa due settimane, a volte molto di più | Guida di Indicizzazione delle pagine |
Sono i tempi indicati da Google, non casi di recupero. Controlla il rapporto Pagine ogni settimana; se gli URL corretti non si sono mossi una volta trascorsi quei tempi, torna sui contenuti.
Come evitare che le nuove pagine finiscano in questo stato
La prevenzione è una routine: controlla ogni pagina prima della pubblicazione e rivedi Search Console ogni mese. Prima di pubblicare, verifica che la pagina:
- Risponda a una query a cui nessun'altra pagina del sito risponde.
- Aggiunga dati, esempi o esperienza tuoi.
- Abbia un canonical autoreferenziale e nessun noindex dimenticato.
- Sia nella sitemap con un lastmod accurato.
- Abbia un autore indicato per nome e, dove serve, dati strutturati.
- Riceva un link da una pagina correlata e indicizzata.
Una volta al mese, confronta il rapporto Pagine con quello del mese precedente; un problema resta elencato per 90 giorni dopo la scomparsa della sua ultima occorrenza. I siti con più di mille pagine dovrebbero tenere d'occhio anche il rapporto Statistiche di scansione.
SEOcrawl AI gestisce la parte tecnica su larga scala. Il Crawler analizza ogni pagina e restituisce un Audit Health Score, con i problemi suddivisi per Indexability, Crawlability, On-Page e altro. La sua vista Indexation raggruppa i tuoi URL per stato di copertura di Search Console, così vedi quanti si trovano in «Pagina scansionata ma attualmente non indicizzata» e segui il numero nel tempo.
Tra una scansione e l'altra, SEO Monitor ti avvisa quando una pagina chiave riceve un noindex, cambia il canonical, restituisce un 404 o esce dalla sitemap. La stessa piattaforma monitora la visibilità del tuo brand in ChatGPT, Claude, Gemini, Perplexity e Copilot, così SEO e GEO stanno insieme.
Domande frequenti
Cosa significa «Pagina scansionata ma attualmente non indicizzata»?
Significa che Googlebot ha recuperato la tua pagina e ha deciso di non aggiungerla all'indice di Google, quindi non può comparire nella ricerca. Nulla ha bloccato la scansione: Google ha letto la pagina e per ora ha scelto di lasciarla fuori. Non è una penalizzazione manuale, e la pagina potrebbe essere indicizzata o meno in futuro.
È lo stesso di «Rilevata, ma attualmente non indicizzata»?
No. «Rilevata» significa che Google conosce l'URL ma ha rimandato la scansione, quindi la data dell'ultima scansione è vuota. «Scansionata» significa che Google ha già visitato e letto la pagina, e poi ha deciso di non indicizzarla. Con Rilevata, guarda la capacità di scansione sui siti molto grandi; con Scansionata, guarda la qualità dei contenuti, i duplicati e i canonical.
«Pagina scansionata ma attualmente non indicizzata» danneggia la SEO?
Di per sé no: lo stato non è una penalizzazione e la pagina interessata perde solo il proprio traffico di ricerca. Il rischio è il volume, perché Google tratta un'ampia quota di contenuti poco utili come un segnale a livello di sito. Un archivio di tag fuori dall'indice non costa nulla; una pagina prodotto sì. Se il numero sale ogni volta che pubblichi, trattalo come un problema di contenuti del sito, non come un elenco di singoli URL.
Quanto ci vuole perché una pagina venga indicizzata dopo una correzione?
Metti in conto da un giorno a diverse settimane, e l'indicizzazione non è mai garantita. Google dice che una nuova scansione richiede da qualche giorno a qualche settimana, che una richiesta di indicizzazione viene di solito elaborata in circa un giorno ma può richiedere una o due settimane, e che Convalida correzione richiede di solito fino a circa due settimane.
Richiedere l'indicizzazione serve?
Solo dopo aver modificato la pagina. Richiedere l'indicizzazione di una pagina invariata significa chiedere a Google di ripetere una decisione che ha già preso. Le richieste sono soggette a una quota giornaliera, e Google dice che inviare lo stesso URL più volte non velocizza nulla.
Aggiungere la pagina alla sitemap XML aiuta?
Aiuta Google a trovare un URL, non a indicizzarlo. Google definisce una sitemap inviata «solo un suggerimento», e queste pagine sono già state trovate e lette. Dopo una correzione, il compito della sitemap è raggruppare gli URL che vuoi far ricontrollare. Ogni file sitemap contiene fino a 50.000 URL o 50 MB.
Perché la convalida di «Pagina scansionata ma attualmente non indicizzata» non è andata a buon fine?
La convalida si interrompe non appena Google trova nel gruppo un URL non ancora corretto, quindi una sola pagina rimasta indietro può far fallire l'intero lotto. Correggi tutti gli URL del gruppo, oppure restringi il gruppo filtrando il rapporto con una sitemap che contenga solo gli URL corretti, poi convalida di nuovo.
Come aiuta SEOcrawl AI con le pagine che Google scansiona ma non indicizza?
SEOcrawl AI trova le cause interne al sito dietro lo stato. Il Crawler mostra il punteggio di salute, il codice di stato HTTP e la profondità di scansione di ogni URL, così individui le pagine che Google fatica a raggiungere. La vista Indexation raggruppa i tuoi URL per stato di copertura di Search Console, e SEO Monitor ti avvisa quando una pagina chiave riceve un noindex, cambia il canonical, restituisce un 404 o esce dalla sitemap.
Autore: David Kaufmann

Ho passato gli ultimi oltre 10 anni completamente ossessionato dal SEO — e onestamente, non vorrei fosse altrimenti.
La mia carriera ha fatto un salto di qualità quando ho lavorato come Senior SEO Specialist per Chess.com — uno dei 100 siti più visitati dell'intero Internet. Operare a quella scala, su milioni di pagine, decine di lingue e in una delle SERPs più competitive in assoluto, mi ha insegnato cose che nessun corso o certificazione avrebbe mai potuto. Quell'esperienza ha cambiato la mia prospettiva su come dovrebbe essere davvero un grande SEO — ed è diventata la base di tutto ciò che ho costruito da allora.
Da quell'esperienza è nata SEO Alive — un'agenzia per brand che fanno sul serio con la crescita organica. Non siamo qui per vendere dashboards e report mensili. Siamo qui per costruire strategie che spostino davvero l'ago della bilancia, combinando il meglio del SEO classico con l'entusiasmante nuovo mondo della Generative Engine Optimization (GEO) — facendo in modo che il tuo brand appaia non solo nei link blu di Google, ma anche all'interno delle risposte generate dall'AI che ChatGPT, Perplexity e Google AI Overviews consegnano ogni giorno a milioni di persone.
E poiché non riuscivo a trovare uno strumento che gestisse correttamente entrambi questi mondi, me ne sono costruito uno — SEOcrawl AI, una piattaforma enterprise di SEO intelligence che unisce rankings, audit tecnici, monitoraggio dei backlinks, salute del crawl e tracciamento della visibilità del brand nell'AI, tutto in un unico posto. È la piattaforma che ho sempre desiderato esistesse.
Scopri altri contenuti di questo autore

Una pagina di elenco prodotti (PLP) mostra un'intera categoria di prodotti in una volta. Scopri in cosa si differenzia da una PDP, cosa la fa convertire e come far indicizzare le pagine di elenco senza il caos della navigazione a faccette.
