«Rastreada: actualmente sin indexar»: qué significa y cómo solucionarlo

Google visitó tu URL, la leyó y la dejó fuera de los resultados. Te explicamos cómo saber qué páginas merecen una segunda oportunidad y qué dice Google para volver a meterlas en el índice.
Rastreada: actualmente sin indexar (en la interfaz en inglés, «Crawled – currently not indexed») significa que Googlebot obtuvo tu página y decidió no añadirla al índice de Google, así que no puede aparecer en las búsquedas. La ayuda del informe de indexación de páginas lo explica así: la página se rastreó pero no se indexó, y «puede indexarse o no en el futuro».
La causa suele ser la propia página, no un bloqueo técnico. A continuación verás cómo decidir, URL por URL, si corregir, aplicar noindex o eliminar cada página, y cuánto tarda una corrección según Google. ¿Es tu primera vez con el informe? Empieza por esta guía de Google Search Console.
¿Qué significa «Rastreada: actualmente sin indexar»?
El estado significa que Google rastreó la página y decidió no indexarla. Nada bloqueó a Googlebot: Google decidió dejar la página fuera por ahora. Dos distinciones te ayudan a interpretar bien el estado.
Rastreada frente a indexada
Rastrear es que Googlebot descargue una página. Indexar es que Google la almacene para que pueda aparecer en las búsquedas. Una página puede rastrearse muchas veces y no llegar a indexarse nunca.
La ayuda de la herramienta de Inspección de URLs dice que la calidad de una página debe ser «lo bastante alta como para merecer la indexación», y su prueba en directo no puede detectar este estado.
En qué se diferencia de «Descubierta: actualmente sin indexar»
Descubierta: actualmente sin indexar llega un paso antes: Google encontró la URL pero aplazó el rastreo para no sobrecargar tu sitio, por eso la fecha del último rastreo está vacía.
| Descubierta: actualmente sin indexar | Rastreada: actualmente sin indexar | |
|---|---|---|
| ¿Rastreada por Google? | No | Sí |
| Fecha del último rastreo | Vacía | Una fecha |
| Motivo habitual | Rastreo aplazado para no sobrecargar el sitio | Google leyó la página y la descartó |
| Qué revisar primero | Capacidad de rastreo, en sitios muy grandes | Calidad del contenido, duplicados, canónicas |
Google también dice que «que una página no esté indexada no es necesariamente malo». Las páginas con noindex, las URLs bloqueadas en robots.txt, los duplicados y los 404 sin sustituta deben quedarse fuera.
Por qué Google rastrea páginas sin indexarlas
La indexación tiene un listón de calidad que el rastreo no tiene. La guía de presupuesto de rastreo de Google dice que la demanda de rastreo crece con el valor y la originalidad de tu contenido.
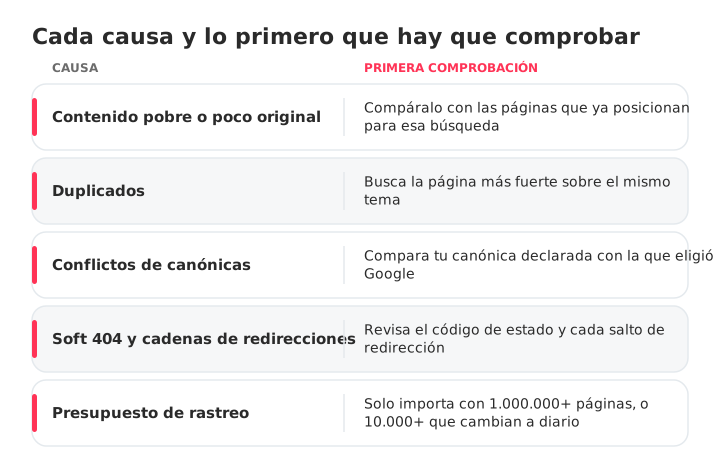
La mayoría de las URLs afectadas encajan en una de estas causas, cada una con su primera comprobación:
- Contenido pobre o poco original: la página repite lo que ya posiciona.
- Duplicados: archivos de etiquetas, URLs ordenadas, dos artículos sobre el mismo tema. Así puedes detectar y corregir la canibalización de keywords.
- Conflictos de canónicas: compara la canónica que declaras con la que ha elegido Google. Cuando Google elige otra URL, la página suele pasar a Página alternativa con etiqueta canónica adecuada o a un estado de duplicado.
- Soft 404 y cadenas de redirecciones: Google dice que los soft 404 desperdician presupuesto de rastreo.
- Presupuesto de rastreo: importa en sitios con más de 1.000.000 de páginas que cambian cada semana o más de 10.000 que cambian a diario. En la mayoría de los sitios no es la causa.
El listón subió en dos momentos concretos. El 18 de agosto de 2022, Google anunció la actualización de contenido útil, una señal a nivel de todo el sitio, y dijo que eliminar el contenido poco útil podía ayudar al resto del sitio. El 5 de marzo de 2024, Google anunció una core update para mostrar menos contenido creado para atraer clics, junto con una nueva política de spam contra el abuso de contenido a escala.
La guía de contenido útil de Google dice que E-E-A-T no es un factor de posicionamiento concreto, que lo que más pesa es la confianza y que no hay un número de palabras preferido. Rellenar una página no lo arregla.
Cómo encontrar y diagnosticar las páginas afectadas en GSC
Abre el informe de indexación de páginas (antes, Cobertura), inspecciona una muestra y agrupa la lista por patrones. Google indica que los sitios con menos de 500 páginas probablemente no necesitan este informe.
Encontrar las URLs afectadas en el informe de páginas
- En Google Search Console, ve a Indexación › Páginas.
- En «Por qué no se han indexado las páginas», haz clic en Rastreada: actualmente sin indexar.
- Haz clic en Exportar y descarga la lista.
El informe muestra hasta 1.000 URLs de ejemplo, no necesariamente todas, así que en un sitio grande la exportación es una muestra.
Revisar páginas con la herramienta de Inspección de URLs
Inspecciona entre cinco y diez URLs exportadas y fíjate en la fecha del último rastreo y en la URL canónica seleccionada por Google. Si la canónica apunta a otra URL, Google ve un duplicado; si el último rastreo es de hace meses, Google vuelve muy poco.
Detectar patrones entre cientos de URLs
Ordena la exportación por carpeta, plantilla y parámetro de URL, y cuenta cada grupo. Imagina 300 URLs repartidas en 180 páginas /tag/, 70 URLs con ?sort= y 50 artículos: son tres decisiones, no 300.
Corregir, noindex o eliminar: decide qué merece cada URL
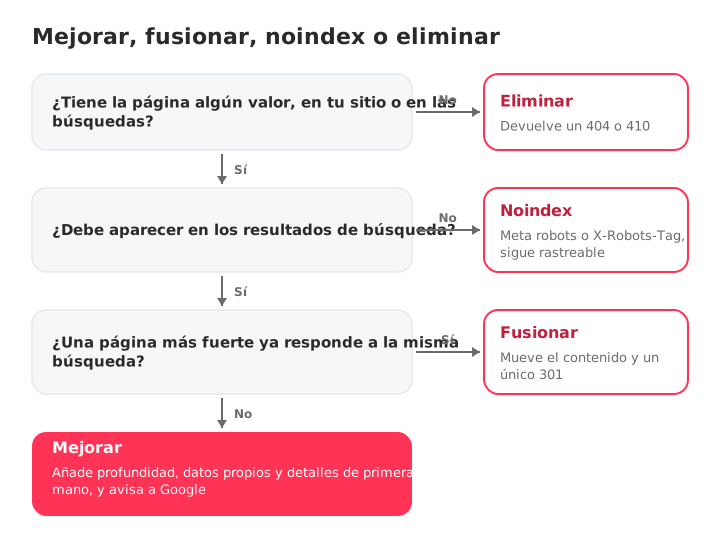
Cada URL merece uno de cuatro destinos. Pregúntate: ¿se alegraría alguien que busca de llegar aquí, y es esta la única página de tu sitio que responde a esa búsqueda?
| Tipo de página | Ejemplo | Decisión | Cómo |
|---|---|---|---|
| Útil y única, pero pobre | Una guía de 300 palabras sobre un tema que dominas | Mejorar | Añade profundidad y detalles de primera mano |
| Duplica una página más fuerte | Dos artículos para la misma búsqueda | Fusionar | Mueve el contenido y redirige con un 301 |
| Útil en el sitio, no en las búsquedas | Archivos de etiquetas, búsqueda interna, páginas de agradecimiento | Noindex | Meta etiqueta robots o X-Robots-Tag |
| Sin valor ni sustituta | Promociones caducadas, páginas de prueba | Eliminar | Devuelve un 404 o un 410 |
La guía de presupuesto de rastreo de Google respalda las dos últimas filas: devuelve un 404 o un 410 en las páginas eliminadas y consolida los duplicados. Un 404 en Search Console es lo esperable en las páginas que has eliminado a propósito.
Con el noindex es donde más se falla al clasificar:
Así no: una etiqueta noindex en tus páginas /tag/ mientras robots.txt bloquea /tag/. Googlebot no puede obtener las páginas, así que nunca ve la etiqueta.
Así sí: /tag/ sigue siendo rastreable y lleva el noindex como meta etiqueta o como cabecera X-Robots-Tag.
Según la documentación de noindex de Google, la regla no funciona dentro de robots.txt, y en páginas que se visitan poco el nuevo rastreo puede tardar meses. Cuando se lee la etiqueta, esas URLs pasan a Excluida por una etiqueta 'noindex', que es justo lo que quieres para ellas.
Cómo corregir las páginas que merecen indexarse
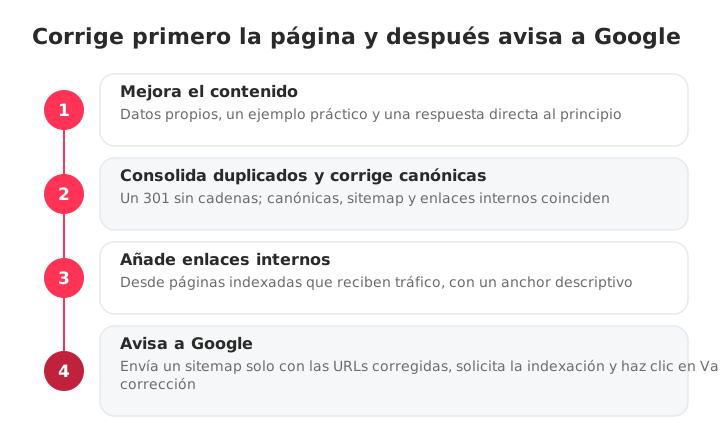
Primero haz que la página merezca indexarse y después avisa a Google. Solicitar la indexación de una página sin cambios es pedirle a Google que repita una decisión que ya tomó. El orden:
- Mejora el contenido.
- Consolida los duplicados y corrige las canónicas.
- Añade enlaces internos.
- Envía un sitemap acotado y solicita la indexación.
Mejora la profundidad y la originalidad del contenido
Reescribe pensando en la búsqueda, no en un número de palabras: añade datos propios, capturas, un ejemplo práctico y una respuesta directa cerca del principio.
Por ejemplo, toma una guía pobre de 300 palabras: añádele un conjunto de datos propio y un ejemplo práctico, enlázala desde dos artículos que ya reciben tráfico y solo entonces inclúyela en un sitemap acotado.
Consolida los duplicados y corrige las canónicas
Cuando dos URLs tratan lo mismo, quédate con una, mueve a ella el contenido útil y haz una redirección 301 de la otra directamente hacia ella, sin cadenas. Después comprueba que las canónicas, el sitemap y los enlaces internos coinciden, y que no queda ningún noindex suelto.
Añade enlaces internos desde páginas que Google ya valora
Enlaza cada página corregida desde páginas indexadas que reciben tráfico, con un anchor descriptivo. Cualquier crawler puede listar las páginas huérfanas (sin enlaces internos) filtrando por cero enlaces entrantes. Tienes el método completo en esta guía de estrategia de enlazado interno.
Revisa también la página en un móvil y en el informe de Métricas web principales (Core Web Vitals): una página rota en móvil se descarta rápido.
Envía un sitemap acotado y solicita la indexación
Crea un sitemap solo con las URLs que has corregido, envíalo y filtra con él el informe de páginas antes de hacer clic en Validar corrección. Google lo recomienda para agilizar la validación. Si antes necesitas tu archivo actual, encuentra el sitemap de tu sitio.
Google ignora priority y changefreq, así que mejor mantén lastmod preciso. Después haz clic en Solicitar indexación en la herramienta de Inspección de URLs para tus URLs prioritarias: Google aplica una cuota y dice que repetir las solicitudes no acelera nada.
¿Cuánto tarda la indexación después de una corrección?
Cuenta con entre un día y varias semanas, y la indexación nunca está garantizada. Google da plazos distintos en páginas distintas, así que aquí los tienes juntos:
| Qué hiciste | Qué dice Google | Fuente |
|---|---|---|
| Pedir a Google que vuelva a rastrear | De unos días a unas semanas | Pedir a Google que vuelva a rastrear tus URLs |
| Solicitar indexación | Normalmente un día más o menos, hasta una o dos semanas, con un límite diario | Ayuda de Inspección de URLs |
| Validar corrección | Hasta unas dos semanas, a veces mucho más | Ayuda de indexación de páginas |
Son los plazos de Google, no casos de recuperación. Revisa el informe de páginas cada semana; si las URLs corregidas no se han movido una vez pasados esos plazos, vuelve al contenido.
Cómo evitar que las páginas nuevas acaben en este estado
La prevención es una rutina: revisa cada página antes de publicarla y repasa Search Console cada mes. Antes de publicar, confirma que la página:
- Responde a una búsqueda que ninguna otra página de tu sitio responde.
- Aporta datos, ejemplos o experiencia propios.
- Tiene una canónica autorreferenciada y ningún noindex suelto.
- Está en el sitemap con un lastmod preciso.
- Tiene un autor con nombre y, cuando aplique, datos estructurados.
- Recibe un enlace desde una página relacionada e indexada.
Una vez al mes, compara el informe de páginas con el del mes anterior; un problema sigue apareciendo durante 90 días después de que desaparezca su último caso. Los sitios de más de mil páginas también deberían vigilar el informe de Estadísticas de rastreo.
SEOcrawl AI se encarga de la parte técnica a escala. El Crawler analiza todas las páginas y devuelve un Audit Health Score, con los problemas desglosados por Indexability, Crawlability, On-Page y más. Su vista Indexation agrupa tus URLs según su estado de cobertura en Search Console, para que veas cuántas hay en «Rastreada: actualmente sin indexar» y sigas la cifra en el tiempo.
Entre rastreos, SEO Monitor te avisa cuando una página clave recibe un noindex, cambia su canónica, devuelve un 404 o sale del sitemap. La misma plataforma sigue la visibilidad de tu marca en ChatGPT, Claude, Gemini, Perplexity y Copilot, para que el SEO y el GEO estén en el mismo sitio.
Preguntas frecuentes
¿Qué significa «Rastreada: actualmente sin indexar»?
Significa que Googlebot obtuvo tu página y decidió no añadirla al índice de Google, así que no puede aparecer en las búsquedas. Nada bloqueó el rastreo: Google leyó la página y decidió dejarla fuera por ahora. No es una penalización manual, y la página puede indexarse o no en el futuro.
¿Es lo mismo que «Descubierta: actualmente sin indexar»?
No. «Descubierta» significa que Google conoce la URL pero aplazó el rastreo, por eso la fecha del último rastreo está vacía. «Rastreada» significa que Google ya visitó y leyó la página, y después decidió no indexarla. Con Descubierta, revisa la capacidad de rastreo en sitios muy grandes; con Rastreada, revisa la calidad del contenido, los duplicados y las canónicas.
¿«Rastreada: actualmente sin indexar» perjudica mi SEO?
Por sí solo, no: el estado no es una penalización y la página afectada solo pierde su propio tráfico de búsqueda. El riesgo es el volumen, porque Google trata una gran proporción de contenido poco útil como una señal a nivel de todo el sitio. Un archivo de etiquetas fuera del índice no cuesta nada; una página de producto, sí. Si la cifra sube cada vez que publicas, trátalo como un problema de contenido del sitio, no como una lista de URLs sueltas.
¿Cuánto tarda una página en indexarse después de corregirla?
Cuenta con entre un día y varias semanas, y la indexación nunca está garantizada. Google dice que un nuevo rastreo tarda de unos días a unas semanas, que una solicitud de indexación suele procesarse en un día más o menos pero puede tardar una o dos semanas, y que Validar corrección suele tardar hasta unas dos semanas.
¿Sirve de algo solicitar la indexación?
Solo después de cambiar la página. Solicitar la indexación de una página sin cambios es pedirle a Google que repita una decisión que ya tomó. Las solicitudes tienen una cuota diaria, y Google dice que enviar la misma URL varias veces no acelera nada.
¿Ayuda añadir la página a mi sitemap XML?
Ayuda a que Google encuentre una URL, no a que la indexe. Google dice que un sitemap enviado es «simplemente una sugerencia», y estas páginas ya se han encontrado y leído. Tras una corrección, la función del sitemap es agrupar las URLs que quieres que se revisen de nuevo. Cada archivo de sitemap admite hasta 50.000 URLs o 50 MB.
¿Por qué ha fallado mi validación de «Rastreada: actualmente sin indexar»?
La validación se detiene en cuanto Google encuentra una URL del grupo sin corregir, así que una sola página pendiente puede hacer fallar todo el lote. Corrige todas las URLs del grupo, o acota el grupo filtrando el informe con un sitemap que solo contenga las URLs corregidas, y vuelve a validar.
¿Cómo ayuda SEOcrawl AI con las páginas que Google rastrea pero no indexa?
SEOcrawl AI encuentra las causas internas del sitio que hay detrás del estado. El Crawler muestra la puntuación de salud, el código de estado HTTP y la profundidad de rastreo de cada URL, para que detectes las páginas a las que a Google le cuesta llegar. La vista Indexation agrupa tus URLs según su estado de cobertura en Search Console, y SEO Monitor te avisa cuando una página clave recibe un noindex, cambia su canónica, devuelve un 404 o sale del sitemap.
Autor: David Kaufmann

Llevo más de 10 años completamente obsesionado con el SEO — y sinceramente, no lo cambiaría por nada.
Mi carrera dio un salto cuando trabajé como especialista SEO sénior en Chess.com — uno de los 100 sitios web más visitados de todo Internet. Operar a esa escala, con millones de páginas, decenas de idiomas y uno de los SERPs más competitivos, me enseñó cosas que ningún curso podría. Esa experiencia cambió mi perspectiva sobre lo que significa hacer SEO de verdad — y se convirtió en la base de todo lo que he construido desde entonces.
De esa experiencia nació SEO Alive — una agencia para marcas que se toman en serio el crecimiento orgánico. No vendemos dashboards ni informes mensuales. Construimos estrategias que realmente mueven la aguja, combinando lo mejor del SEO clásico con el nuevo mundo del Generative Engine Optimization (GEO) — asegurando que tu marca aparezca no solo en los enlaces azules de Google, sino también en las respuestas generadas por IA que ChatGPT, Perplexity y Google AI Overviews entregan a millones de personas cada día.
Y como no encontré una herramienta que gestionara ambos mundos correctamente, construí la mía propia — SEOcrawl AI, una plataforma de inteligencia SEO empresarial que une rankings, auditorías técnicas, monitorización de backlinks, salud del crawl y seguimiento de visibilidad de marca en IA, todo en un solo lugar. Es la plataforma que siempre deseé que existiera.
Descubre más contenido de este autor

Una página de listado de productos (PLP) muestra toda una categoría de productos a la vez. Descubre en qué se diferencia de una PDP, qué la hace convertir y cómo conseguir que tus listados se indexen sin el caos de la navegación facetada.
