Canonical tag: hvad det er, og hvordan du bruger det
Når du ejer et eller flere websites, uanset om de handler om produkter, ydelser eller sektioner af forskellig art, er det almindeligt, at mange sider på platformen er ens eller næsten identiske af en række årsager. Det sker især tit i ecommerce, men vi har også set det i vores rådgivningsarbejde på blogtags og indhold af forskellig slags.
Det er let at forestille sig, at ethvert website kan løbe ind i problemer med duplicate content. Google straffer sites med duplicate content, og det påvirker uden tvivl deres placeringer i søgeresultaterne.
Så hvordan kan det være, at websites kan have duplicate content, uden at deres webmastere skal bekymre sig om at blive straffet?
Svaret ligger i det, der kaldes canonical-attributten eller canonical-linket, som vi gennemgår i detaljer i de næste afsnit, hvor vi kommer ind på definitionen, formålet, fordelene, hvordan du lægger det på, hvornår det bør bruges, og de mulige ulemper ved canonical-attributten, når den bruges til at undgå mulige straffe for duplicate content.
Hvad er et canonical-link og canonical-attributten?
Groft sagt er et canonical-link et link, der gennem et tag eller en attribut bliver beskrevet som det »vigtigste« eller »originale« link på et website, så du kan pege URL'er på sider med lignende indhold hen på det. Takket være det bliver linket opfattet som den foretrukne eller prioriterede version af Googles bots eller søgealgoritmerne.
På den måde kan indhold, der ellers kunne se ud som en dublet, blive håndteret korrekt og relativt let. Hvis det ikke blev beskrevet som canonical, kunne det påvirke platformens placeringer og føre til straffe. Det kan ske, selv når indholdet ikke er duplikeret med vilje, men opstår naturligt og organisk gennem salg af produkter, udbud af ydelser, beslægtede sektioner og så videre.
Rent teknisk er en canonical-URL et link skrevet i HTML-kode, der indeholder canonical-tagget, og som dermed får canonical-attributten. Det gør, at den bliver set som hoved- eller kildeadressen af Googles bots, som nævnt ovenfor, så ensartede links ikke bliver regnet for gentagelser eller dubletter.
Herunder er et eksempel på, hvordan vi angiver en URL som canonical eller hoved-URL:
<link rel="canonical" href="/en/">
Canonical-linkets oprindelse og fordelen for SEO
Brugen af canonical-links begyndte i 2009, da de tre store søgevirksomheder på nettet, Google, Bing og Yahoo, i fællesskab indførte canonical-attributten.
Logisk nok har canonical-linket stort potentiale set med SEO-briller, for det hjælper os med at undgå de straffe, vi nævnte ovenfor, og peger vores vigtigste URL'er ud for Google.
Derfor er canonical-links altid en del af planen, når det handler om et sites SEO og de strategier, der hører til, især på et stort site med et betydeligt antal URL'er, der kan være identiske.
Sådan gør du en URL canonical
Når du har et website, eller er i gang med at optimere et, og du finder, at der er et stort antal ensartede URL'er, bør du gå i gang med en kanonisering. Den går ud på at vælge, hvilken URL der er den bedste, og give den canonical-attributten.
Nogle gange er valget af den bedste URL ligetil, fordi den har det mest optimerede indhold og den bedste tekniske struktur. Men i andre tilfælde kan valget være mere indviklet, især når siderne ligner hinanden meget og er svære at skelne fra hinanden.
Uanset hvad er her en simpel anbefaling: det er altid bedre at vælge en canonical-URL, når du har ensartede sektioner eller sider. Ellers kan der komme negative konsekvenser for dine placeringer og straffe, der kan påvirke trafikken permanent.
For at gøre en URL canonical er det første skridt at sammenligne de URL'er, der kan være ens. Det er almindeligt på ecommerce-sites, hvor brugerne når frem til produkter og oversigter over ydelser ad forskellige veje, hvilket kan give URL'er som disse:
-
https://example.com/wordpress/seoplugin/ -
https://example.com/wordpress/pluginseo/
Da begge URL'er har værdi for sitet eller fører til det samme produkt eller den samme side, skal du vælge, hvilken af de to der er mest relevant, sådan her:
-
Vælg den mest relevante URL ud fra besøg, trafik og autoritet.
-
Når linket er valgt, lægger du canonical-attributten på den ikke-kanoniske side, så den peger på den kanoniske. Det ser nogenlunde sådan her ud:
<link rel="canonical" href="https://example.com/wordpress/seo-plugin/">
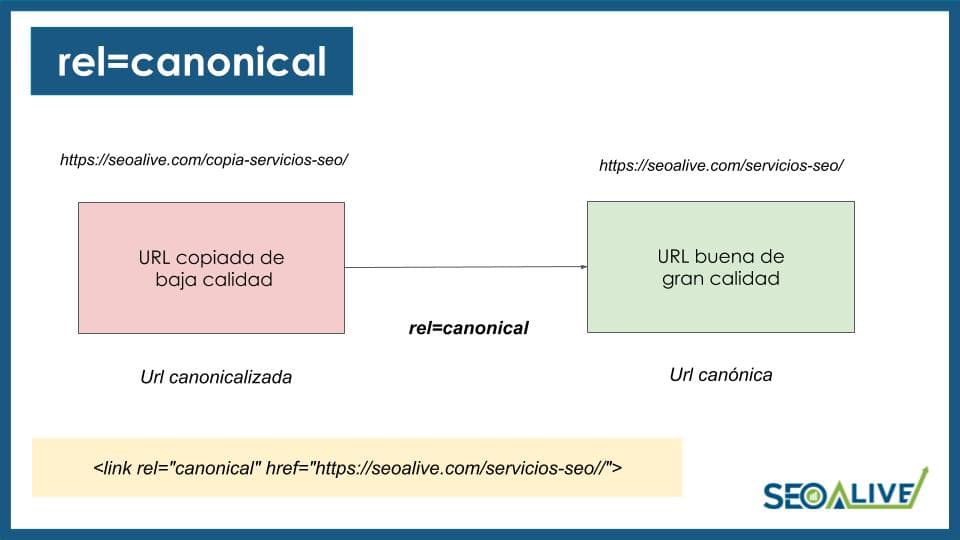
Det, vi opnår med det, er at fortælle Google, hvilken URL der er den kanoniserede (den, vi behandler som en kopi af originalen), og hvilken der er canonical-URL'en, altså originalen. Linket ligger på »kopi«-URL'en og peger på den originale URL.
Med andre ord ville det følge det her skema:
Hvornår er det en god idé at bruge canonical-URL'er
Når du har websites med mange sider eller sektioner som produkter, ydelser og anden information og indlæg, er det meget sandsynligt, at nogle af de sider og URL'er vil ligne hinanden meget, og så er canonical-URL'er en rigtig god idé.
Men i de tilfælde kan du også bruge rigtige 301-redirects i stedet for canonical tags. Det er især nyttigt, når redirects skal være permanente, og der er en sitemigrering. Når det er sagt, er canonical tags altid den næstbedste løsning ved tekniske problemer eller straffe.
Det er endda muligt at bruge canonical tags på URL'er på tværs af forskellige sites, for eksempel indhold der bliver genudgivet uændret på andre platforme, med den rette tilladelse, og altid med pegepind mod originalen for at undgå straffe.
Vigtig note om rel=canonical
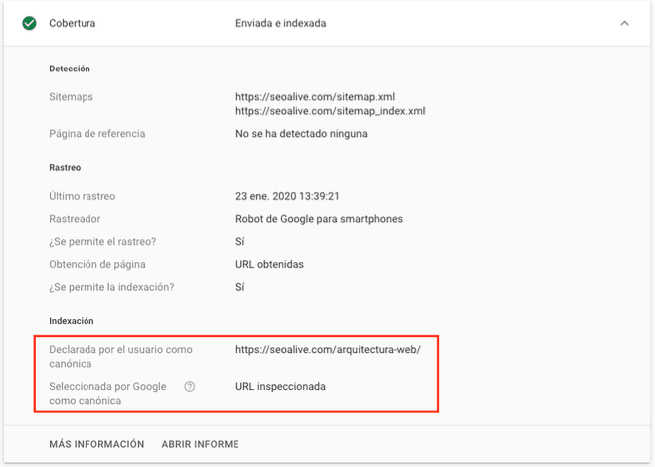
At vi har gemt det til sidst, gør det ikke mindre vigtigt. Vi skal være klar over, at canonical-attributten er et FORSLAG til Google, ikke en ordre. Det betyder, at Google kan ignorere den, hvis de signaler, vi sender på resten af sitet, modsiger den måde, vi har sat den op på.
Med andre ord: hvis vi sætter et canonical fra URL A til URL B, men alle interne links peger på A, og de eksterne links også peger på A, kan Google ignorere det canonical og behandle A som den rigtige. B ville så være en kopi af A og potentielt kunne blive straffet.
For at finde ud af, hvilken URL Google behandler som originalen, og hvilken som den kanoniske, skal vi ind i Search Console, lægge URL'en i inspektøren og gennemgå den information, Google Search Console giver
Og der får vi følgende data:
Klassiske fejl med canonical-URL'er
Der er forskellige problemer og fejl, der bliver begået ofte i forbindelse med canonical-URL'er, og som især dukker op, når værktøjet bliver brugt forkert, for eksempel:
-
Du bør ikke kanonisere et pagineret arkiv til side 1. Tilsvarende bør en sides canonical tag pege på den samme side, for eksempel: fra side 2 til side 2, ellers kan søgemaskiner få svært ved at indeksere dybere sidearkiver.
-
Du skal gøre canonical-URL'er eksklusive og unikke, også selvom det betyder at skifte protokol fra HTTP til HTTPS.
-
Du skal basere canonical-tagget på den URL, der skal bruges**, uden at bruge variabler og på en direkte måde**.
-
Når en side har flere beslægtede canonical-URL'er, kan det være kontraproduktivt og uforudsigeligt. Lad os ikke glemme, at Google skal forstå vores website hurtigt og klart, så lad os gøre det let.
-
En anden vigtig fejl kan komme af at bruge canonical-attributten i body i stedet for i /head eller headeren. Google anbefaler i sine officielle udmeldinger at bruge attributten i head så tidligt som muligt for at undgå problemer, når alt indholdet skal parses, for ellers kan den blive overset.
-
At bruge noindex og rel=canonical sammen. John Mueller tog specifikt fat på det i et af sine mange hangouts og forklarede, at de to signaler modsiger hinanden og vil forvirre Google, som vil tage canonical-attributten frem for noindex. Så dem bør vi ALDRIG bruge sammen.
-
At pege canonical-attributter mod 404-sider eller 30x-sider. Lad os lige tænke over det: hvis vi lægger en attribut på URL A, der peger på B, som giver en fejl eller laver et redirect, sender vi så ikke forkerte signaler til Google? Vi fortæller den, at den »originale« URL er en fejlside eller et redirect... det giver ikke mening.
Avanceret brug af canonical-attributten
Canonical-attributten kan have andre funktioner og avanceret brug, for eksempel:
- Canonical-link i HTTP-headeren: den slags headere kan være meget nyttige, når det handler om at kanonisere PDF-dokumenter, for de er ikke HTML, så vi må gribe til den mulighed, hvis vi vil kanonisere dem. Det ville se sådan her ud:
Link: <http://www.example.com/downloads/seoguide.pdf>; rel="canonical"
-
At bruge canonical på sider, der ikke ligner hinanden så meget: det er faktisk muligt at bruge canonical tags på sider, der ikke rigtig er identiske, endda ret forskellige. Selvom det måske hjælper sitets samlede autoritet, kan det ikke anbefales, for Google kan opdage misbrug af canonicals, straffe sitet og derefter ignorere dets egentlige canonical-URL'er.
-
At bruge canonical-attributten sammen med hreflang: du kan køre strategier med hreflang samtidig med canonical-tagget, med gode resultater hvis det gøres ordentligt. Men du skal være helt klar over, at når du bruger hreflang, skal sprogopsætningen af canonicals være perfekt og altid pege på sig selv for at undgå uforudsigelige problemer eller konflikter, der kan gøre mere skade end gavn for begge strategier.
Har du stadig spørgsmål om det fascinerende SEO-tag? Vi hjælper gerne!
Forfatter: David Kaufmann

Jeg har brugt de sidste 10+ år fuldstændig opslugt af SEO — og helt ærligt: jeg ville ikke have det anderledes.
Min karriere rykkede et niveau op, da jeg arbejdede som senior SEO-specialist for Chess.com — et af de 100 mest besøgte websites på hele internettet. At arbejde i den skala, på tværs af millioner af sider, snesevis af sprog og en af de mest konkurrenceprægede SERP'er der findes, lærte mig ting, som intet kursus og ingen certificering kunne have lært mig. Den erfaring ændrede mit syn på, hvordan rigtig godt SEO ser ud — og den blev fundamentet for alt, hvad jeg har bygget siden.
Ud af det grundlagde jeg SEO Alive — et bureau for brands, der mener det alvorligt med organisk vækst. Vi er ikke her for at sælge dashboards og månedsrapporter. Vi er her for at bygge strategier, der rent faktisk flytter noget, og vi kombinerer det bedste fra klassisk SEO med den spændende nye verden inden for Generative Engine Optimization (GEO) — så dit brand ikke kun dukker op i Googles blå links, men også inde i de AI-genererede svar, som ChatGPT, Perplexity og Google AI Overviews leverer til millioner af mennesker hver eneste dag.
Og fordi jeg ikke kunne finde et værktøj, der håndterede begge verdener ordentligt, byggede jeg selv et — SEOcrawl AI, en enterprise-platform til SEO-intelligens, der samler placeringer, tekniske audits, backlink-overvågning, crawl-sundhed og tracking af brandets synlighed i AI ét sted. Det er den platform, jeg altid ønskede fandtes.
Find mere indhold fra denne forfatter