


«Discovered – currently not indexed»: معناها وكيفية إصلاحها
تعرف Google أن عنوان URL الخاص بك موجود لكنها لم تزره بعد. إليك كيف تعرف هل تنتظر أم تتصرف، وما الإصلاحات التي تجربها أولًا في موقع صغير وآخر كبير.
تعني Discovered – currently not indexed أن Google عثرت على عنوان URL لكنها لم تزحف إليه بعد. هكذا يصفها مساعدة تقرير فهرسة الصفحات من Google. في العادة كانت Google تنوي الزحف ثم أجّلته كي لا تُرهق موقعك، ولذلك يظهر تاريخ آخر زحف فارغًا في التقرير.
إنها حالة تتعلق بأولوية الزحف، وليست حكمًا على محتواك، لأن Google لم تقرأ الصفحة بعد. ستجد أدناه كيف تختلف عن «Crawled»، وما اكتشفناه عند فحص موقعنا، وقائمة بالإصلاحات مرتبة حسب حجم الموقع. هل تبدأ للتو مع التقرير؟ ابدأ بهذا الدليل إلى Google Search Console.
ماذا تعني «Discovered – currently not indexed»
تمرّر Google عنوان URL عبر أربع مراحل: العثور عليه والزحف إليه و**فهرسته** ثم قد تعرضه في النتائج. وتصف حالتان في Search Console عنوانًا توقف في منتصف الطريق.
يصل عنوان URL إلى «عُثر عليه» عبر خريطة الموقع أو عبر روابط من صفحات أخرى. ثم تقرر Google متى تزحف إليه. وتعني «Discovered» أن هذا القرار لم يُتخذ بعد.
الفرق عن «Crawled – currently not indexed»
تبدو الحالتان متشابهتين وتتطلبان إصلاحين مختلفين.
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| هل زحفت إليه Google؟ | لا | نعم |
| تاريخ آخر زحف | فارغ | يوجد تاريخ |
| هل قرأت Google الصفحة؟ | لا | نعم |
| السبب المعتاد | تأجيل الزحف أو أولوية منخفضة | قرأت Google الصفحة وتجاوزتها |
| ما تنظر إليه أولًا | الروابط الداخلية وخريطة الموقع وطاقة الزحف | جودة المحتوى والتكرار وعناوين canonical |
يوجد التشخيص الكامل للحالة الثانية في دليل Crawled – currently not indexed.
كيف تبدو القائمة في موقع حقيقي
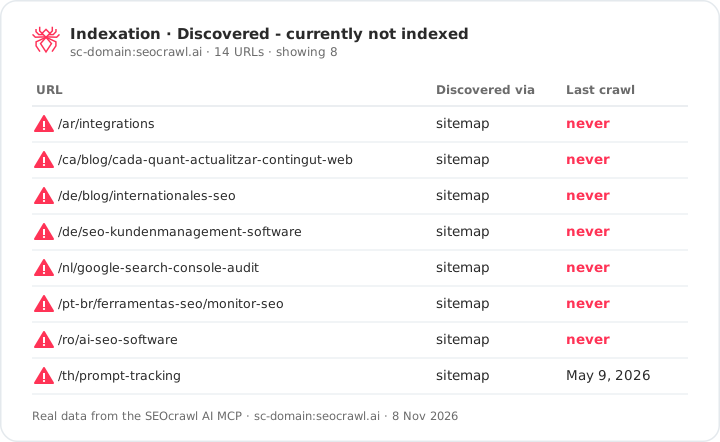
فحصنا seocrawl.ai في تقرير الفهرسة من SEOcrawl. من بين 1,000 عنوان URL يراقبها SEOcrawl (تعلن خريطة موقعنا عن 6,310) هناك 823 مفهرسة، أي 82.3%. وتوجد 128 في «Crawled – currently not indexed» و14 في «Discovered – currently not indexed».
ما يجمع بين هذه الأربعة عشر هو الجزء المفيد:
- كلها صفحات مترجمة: العربية والكتالانية والألمانية والإستونية والليتوانية والهولندية والبرتغالية (البرازيل) والرومانية والتايلاندية. ولا واحدة بالإنجليزية.
- عثرت Google على الأربعة عشر كلها عبر خريطة الموقع، لا عبر رابط من صفحة أخرى.
- أحدها يعرض تاريخ زحف سابقًا (9 مايو 2026)، فالحالة تصف موضع العنوان الآن، ولا تعني أن Google لم تزره قط.
هذا نمط يجب التحقق منه، وليس تشخيصًا. الصفحة الموجودة بـ26 لغة والتي يُوصل إليها أساسًا عبر خريطة الموقع مرشحة طبيعية لروابط داخلية ضعيفة، لذا فالروابط الداخلية أول ما يُنظر إليه. والدرس ينطبق على أي موقع: لا تقرأ القائمة عنوانًا عنوانًا. وبعد التجميع حسب اللغة، تحوّلت 14 عنوانًا إلى سؤال واحد.
تغطي الأرقام 1,000 عنوان URL يراقبها SEOcrawl، وهي عيّنة من خريطة الموقع كلها. أما المجموعة الأكبر البالغة 128 عنوانًا فهي الحالة الأخرى ولها دليلها الخاص.
لماذا تؤجل Google الزحف
يشرح دليل ميزانية الزحف من Google كيف تقرر مقدار ما تزحف إليه: حد للطاقة يتحمله خادمك، والطلب على عناوين URL الخاصة بك. ويمكن ردّ معظم عناوين URL المكتشفة إلى أحد هذه الأسباب الخمسة.
- طاقة الزحف. تقول Google إن الحد ينخفض عندما يبطؤ موقعك أو يعيد أخطاء خادم. الخادم البطيء يعني زحفًا أقل.
- انخفاض الطلب على الزحف. يعتمد الطلب على حجم الموقع وتكرار تحديثه وجودة الصفحات وصلتها بالموضوع. عنوان URL بروابط داخلية قليلة أو بلا روابط يمنح Google سببًا ضئيلًا للعودة سريعًا.
- زحف مهدور. تتنافس عناوين URL المكررة والمعلمات والواجهات الفرعية وسلاسل إعادة التوجيه الطويلة وصفحات soft 404 مع صفحاتك الحقيقية. وتشير Google إلى أن soft 404 يستمر الزحف إليها وتهدر الميزانية، وأن الصفحة التي تحمل noindex تُطلب مع ذلك قبل أن تُهمل.
- العثور عليها عبر خريطة الموقع فقط. تخبر خريطة الموقع Google بأن عنوان URL موجود. لكنها لا تجعله أولوية، وتتعامل Google مع خريطة الموقع على أنها تلميح. والصفحات التي لا تُوجد إلا هناك هي أول من ينتظر.
- موقع أو قسم جديد. يبدأ كل موقع بالحد الافتراضي الحذر نفسه للطاقة، وهو ينمو كلما أثبت الموقع سلامته.
ميزانية الزحف نفسها لا تستحق اهتمامك إلا في المواقع الكبيرة جدًا. وتقدير Google التقريبي: 1,000,000+ صفحة فريدة تُحدَّث أسبوعيًا تقريبًا، أو 10,000+ صفحة تتغير يوميًا. أما في المواقع الأصغر فالسببان 2 و4 أكثر شيوعًا بكثير.
هل هي مشكلة؟ ثلاثة أسئلة قبل إصلاح أي شيء
- هل ينبغي فعلًا فهرسة عنوان URL هذا؟ إذا كان عرضًا مفلترًا أو صفحة بحث داخلي أو عنوان اختبار، فغيابه طبيعي. ولتوضيح ذلك، طبّق noindex أو أعد 404 أو 410 (انظر Excluded by 'noindex' tag).
- كم عنوانًا، وبأي نمط؟ تقول Google إنه مع أقل من 500 صفحة فمن المرجح ألا تحتاج هذا التقرير أصلًا. والقائمة أيضًا محدودة بـ1,000 صف، فهي في الموقع الكبير عيّنة.
- هل هي جديدة؟ عنوان URL نُشر الأسبوع الماضي ليس مشكلة بعد. وتجد النطاقات الزمنية من Google نفسها في الجدول أدناه.
كيفية الإصلاح بحسب حجم الموقع
تعتمد الخطوة الأولى الصحيحة على حجم موقعك، لذا ابدأ من العمود المناسب.
معظم المواقع: حتى نحو 10,000 عنوان URL
- تأكد من أن عنوان URL يستحق الفهرسة. وإن لم يستحق، فطبّق noindex أو احذفه واشطبه من قائمتك.
- أضف روابط من صفحات تزحف إليها Google بالفعل. أضف روابط سياقية بنص ارتساء وصفي من صفحات مفهرسة تتلقى زيارات. يعرض أي زاحف صفحاتك اليتيمة عند تصفية الصفحات التي ليس لها أي رابط داخلي، ويتضمن هذا دليل الروابط الداخلية الطريقة كاملة.
- حافظ على نظافة خريطة الموقع. ضمّن فقط عناوين URL التي تعيد 200 وتقبل الفهرسة وهي نسخة canonical، مع
lastmodدقيق. وتتجاهل Google priority وchangefreq. وإذا كنت تحتاج إلى الملف أولًا، فـاعثر على خريطة موقعك. وإذا ذكر Search Console أنه لا يجد أي خريطة، فانظر No referring sitemaps detected. - اطلب فهرسة بضعة عناوين URL ذات أولوية. افتح أداة فحص عنوان URL وانقر طلب الفهرسة. تطبّق Google حصة وتذكر أن الطلبات المتكررة لا تسرّع شيئًا، فاحتفظ بها للصفحات الأهم.
المواقع الكبيرة أو سريعة التغير: 10,000+ عنوان URL يتغير يوميًا أو مليون+ أسبوعيًا
- قلّل الزحف المهدور. احجب في robots.txt مساحات عناوين URL التي لا قيمة بحثية لها (المعلمات والواجهات الفرعية والبحث الداخلي)، ووحّد المكررات بعناوين canonical وإعادات توجيه 301. لا تعتمد على noindex لتوفير الميزانية: فـGoogle تواصل طلب تلك الصفحات.
- أعد 404 أو 410 للصفحات المحذوفة وأصلح soft 404. تصف Google 404 بأنه إشارة قوية لعدم الزحف إلى العنوان ثانية، بينما تبقى عناوين URL المحجوبة في الطابور مدة أطول. اختصر كل سلسلة إعادة توجيه طويلة.
- افحص إحصاءات الزحف. في الإعدادات، يعرض تقرير إحصاءات الزحف أزمنة الاستجابة وأخطاء الخادم. فإذا كانت مرتفعة تخفض Google حد الطاقة لديك، ولا يفيد أي إصلاح للمحتوى حتى يتحسن الخادم.
- أصلح حسب المجلد أو القالب ثم تحقق من المجموعة. اتخذ قرارًا واحدًا لكل نمط، وأنشئ خريطة موقع تضم عناوين URL المصلحة فقط، وانقر التحقق من الإصلاح. اقرأ المزيد عن ميزانية الزحف إذا كان موقعك ضمن هذه الفئة.
تنتظر أم تتصرف؟
الأصعب ليس الإصلاح، بل معرفة متى تتوقف عن الانتظار. استخدم نطاقات Google نفسها واتجاهك الخاص.
| ما فعلته | ما تقوله Google | المصدر |
|---|---|---|
| طلبت من Google معاودة الزحف | من بضعة أيام إلى بضعة أسابيع | طلب معاودة الزحف من Google |
| طلبت الفهرسة | عادةً نحو يوم، وحتى أسبوع أو أسبوعين، مع حصة يومية | مساعدة فحص عنوان URL |
| تحققت من الإصلاح | حتى نحو أسبوعين، وأحيانًا أطول بكثير | مساعدة فهرسة الصفحات |
النطاقات الزمنية من Google. وقاعدة الانتظار أو التصرف من عندنا: انتظر ما دام عنوان URL جديدًا والمجموعة مستقرة أو تتقلص، وتصرّف عندما تستمر المجموعة في النمو أو تبقى صفحاتك المهمة عالقة بعد تلك الأسابيع.
كيف تتابع ذلك بمرور الوقت
يعرض Search Console أحدث حالة لكل عنوان URL وقائمة محدودة بـ1,000 صف، لذا ابنِ روتينك الخاص:
- صدّر القائمة مرة كل شهر وقارنها بالسابقة. هل المجموعة تنمو أم مستقرة أم تتقلص؟
- جمّع حسب النمط (اللغة أو المجلد أو القالب) قبل النظر إلى عناوين URL منفردة.
- انظر كيف عثرت Google على كل عنوان URL. القائمة التي كلها «خريطة موقع» وليس فيها «صفحة محيلة» أبدًا، كما في عناوين URL الأربعة عشر لدينا، تشير مباشرة إلى الروابط الداخلية.
يقدّم عرض الفهرسة في SEOcrawl AI هذه القائمة جاهزة: صفِّ حسب حالة التغطية لترى عناوين URL داخلها، مع تاريخ آخر زحف والنقرات والظهور. وعبر MCP يأتي كل عنوان URL أيضًا مع canonical الذي اختارته Google مقارنةً بالمعلن، وما إذا كان قد عُثر عليه عبر خريطة الموقع أم عبر صفحة محيلة. ويدقق الزاحف صفحاتك أنت، فترى ما هو ضعيف في عنوان URL قبل أن تطلب من Google إلقاء نظرة أخرى، وينبّهك SEO Monitor عندما تحصل صفحة مهمة على noindex أو يتغير canonical أو تعيد 404 أو تختفي من خريطة الموقع.
وهذه هي القائمة لموقعنا نحن، مباشرة من عرض الفهرسة:
ويمكنك أيضًا تجاوز لوحة المعلومات. مع ربط MCP الخاص بـSEOcrawl AI بـClaude أو ChatGPT اسأل: «اعرض عناوين URL في حالة Discovered – currently not indexed وجمّعها حسب المجلد.» وهذا الشرح خطوة بخطوة لربط Search Console بـClaude وChatGPT.
الأسئلة الشائعة
ماذا تعني «Discovered – currently not indexed»؟
تعني أن Google عثرت على عنوان URL الخاص بك لكنها لم تزحف إليه بعد. في العادة كانت Google تنوي الزحف ثم أجّلته، ولذلك يكون تاريخ آخر زحف فارغًا (مساعدة فهرسة الصفحات). لم تقرأ Google الصفحة، لذا لا تقول الحالة شيئًا عن جودتها. وهي ليست عقوبة.
كم تدوم «Discovered – currently not indexed»؟
لا تنشر Google مدة محددة لهذه الحالة. وتقول إن معاودة الزحف المطلوبة تستغرق من بضعة أيام إلى بضعة أسابيع، وإن التحقق من الإصلاح يستغرق حتى نحو أسبوعين، وأحيانًا أطول بكثير. وقد يحتاج عنوان URL جديد إلى تلك الأسابيع فحسب. إذا استمرت المجموعة في النمو بينما تنشر، فتوقف عن الانتظار وتصرّف.
هل يحل طلب الفهرسة المشكلة؟
قد يفيد في بضعة عناوين URL ذات أولوية، لأنه يطلب من Google وضع الصفحة في الطابور. لكنه لا يزيل السبب، فقد تعود الصفحة إلى الحالة نفسها. وتخضع الطلبات لحصة يومية، وتذكر Google أن إرسال عنوان URL نفسه مرات متعددة لا يسرّع شيئًا. استخدمه بعد تحسين الروابط الداخلية، وليس كأداة جماعية أبدًا.
هل هي عقوبة؟
لا. للإجراءات اليدوية تقرير خاص بها. تعني هذه الحالة أن Google عثرت على عنوان URL ولم تزحف إليه بعد، فلم تُقيَّم الصفحة. والسبب عادةً أولوية الزحف: روابط داخلية ضعيفة أو خادم بطيء أو كومة من عناوين URL قليلة القيمة تتنافس على الزحف.
لماذا اكتُشف كثير من صفحاتي ولم يُفهرس؟
يشير الرقم المرتفع عادةً إلى نمط وليس صفحات منفردة: معلمات عناوين URL أو واجهات فرعية، أو مكررات، أو خريطة موقع تحتوي عناوين لا ينبغي أن تكون فيها، أو روابط داخلية ضعيفة إلى قسم كامل، أو خادم يُبطئ Googlebot. جمّع عناوين URL حسب المجلد أو اللغة أو القالب قبل النظر إلى أي منها منفردًا.
هل ينبغي أن أقلق في موقع صغير؟
عادةً لا. تقول Google إنه إذا كان موقعك يضم أقل من 500 صفحة فمن المرجح ألا تحتاج تقرير فهرسة الصفحات أصلًا. وبضعة عناوين URL جديدة في هذه الحالة تحتاج في الغالب إلى وقت وبضعة روابط داخلية من صفحات تزحف إليها Google بالفعل.
كيف يساعد SEOcrawl AI مع عناوين URL المكتشفة؟
يسرد عرض الفهرسة في SEOcrawl AI عناوين URL العالقة في كل حالة تغطية لدى Google، مع تاريخ آخر زحف والنقرات والظهور. وعبر MCP الخاص بـSEOcrawl AI يمكنك أيضًا أن تطلب من Claude أو ChatGPT هذه القائمة مع canonical الذي اختارته Google مقارنةً بالمعلن وما إذا كانت Google قد عثرت على كل عنوان عبر خريطة الموقع أم عبر صفحة محيلة، مجمّعة حسب المجلد.
المزيد من SEOcrawl AI على Google
اخترنا مصدرًا مفضّلًا لترى المزيد من مقالاتنا في أهم الأخبار على Google.
بقلم: David Kaufmann
قضيتُ السنوات العشر الأخيرة منشغلًا تمامًا بـ SEO — وبصراحة، لم أكن لأبدّل ذلك بأي شيء آخر.
تطوّرت مسيرتي إلى مستوى جديد عندما عملت أخصّائيَّ SEO أوّل في Chess.com — أحد أكثر 100 موقع زيارةً على الإنترنت بأكمله. العمل على هذا النطاق علّمني ما لم تعلّمه لي أي دورة أو شهادة.
من هذه التجربة، أسّستُ SEO Alive — وكالة للعلامات التجارية الجادّة بشأن النموّ العضوي. وبما أنّي لم أجد أداةً تُتقن العالَمَين الكلاسيكي وعصر الذكاء الاصطناعي، بنيتُ SEOcrawl AI. إن كنت تبحث عن شريك SEO خبير يعشق هذا المجال — يسعدني التواصل معك!
اكتشف المزيد من محتوى هذا الكاتب
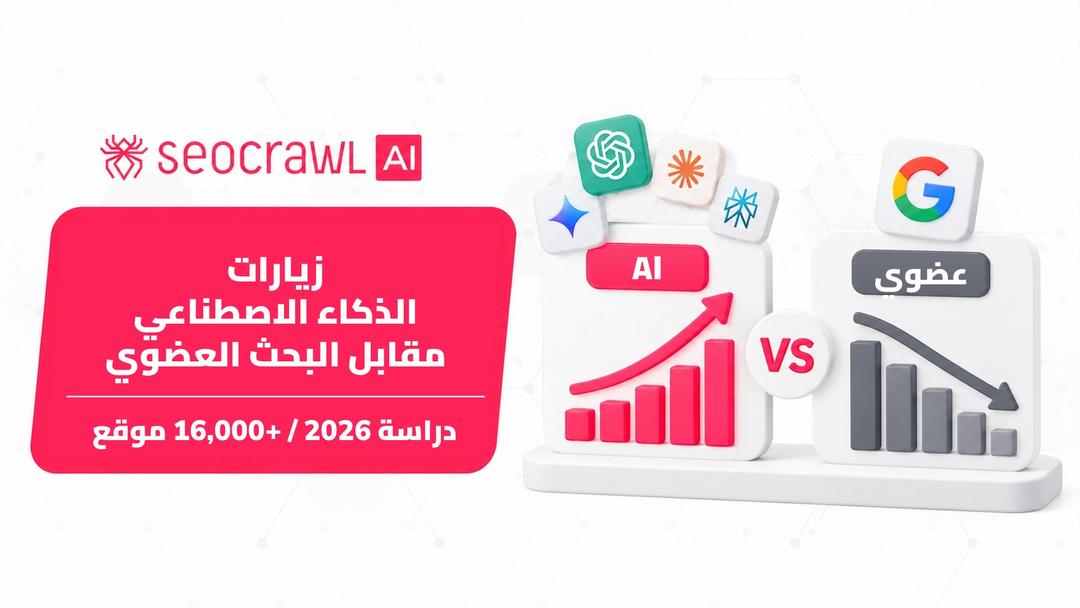
قسنا نقرات Google وزيارات الإحالة من الذكاء الاصطناعي في أكثر من 16,000 موقع و15 قطاعًا. ارتفعت زيارات الذكاء الاصطناعي بنسبة 45% خلال عام، لكنها لا تزال تعادل نحو زيارة واحدة مقابل كل 100 زيارة من Google، في حين تراجعت نقرات Google بنسبة 15%.

حتى 30 نوفمبر، تكلّف السنة الأولى من أي باقة سنوية في SEOcrawl AI نصف السعر بكود BLACKFRIDAY2026. ما الذي تحصل عليه، وما الذي تغطيه برومبتات كل باقة، وكيف ترى خلال 15 دقيقة أين يذكرك ChatGPT وGemini وClaude وPerplexity.