Что такое query fan-out? Техника AI-поиска, которая меняет то, как находят контент
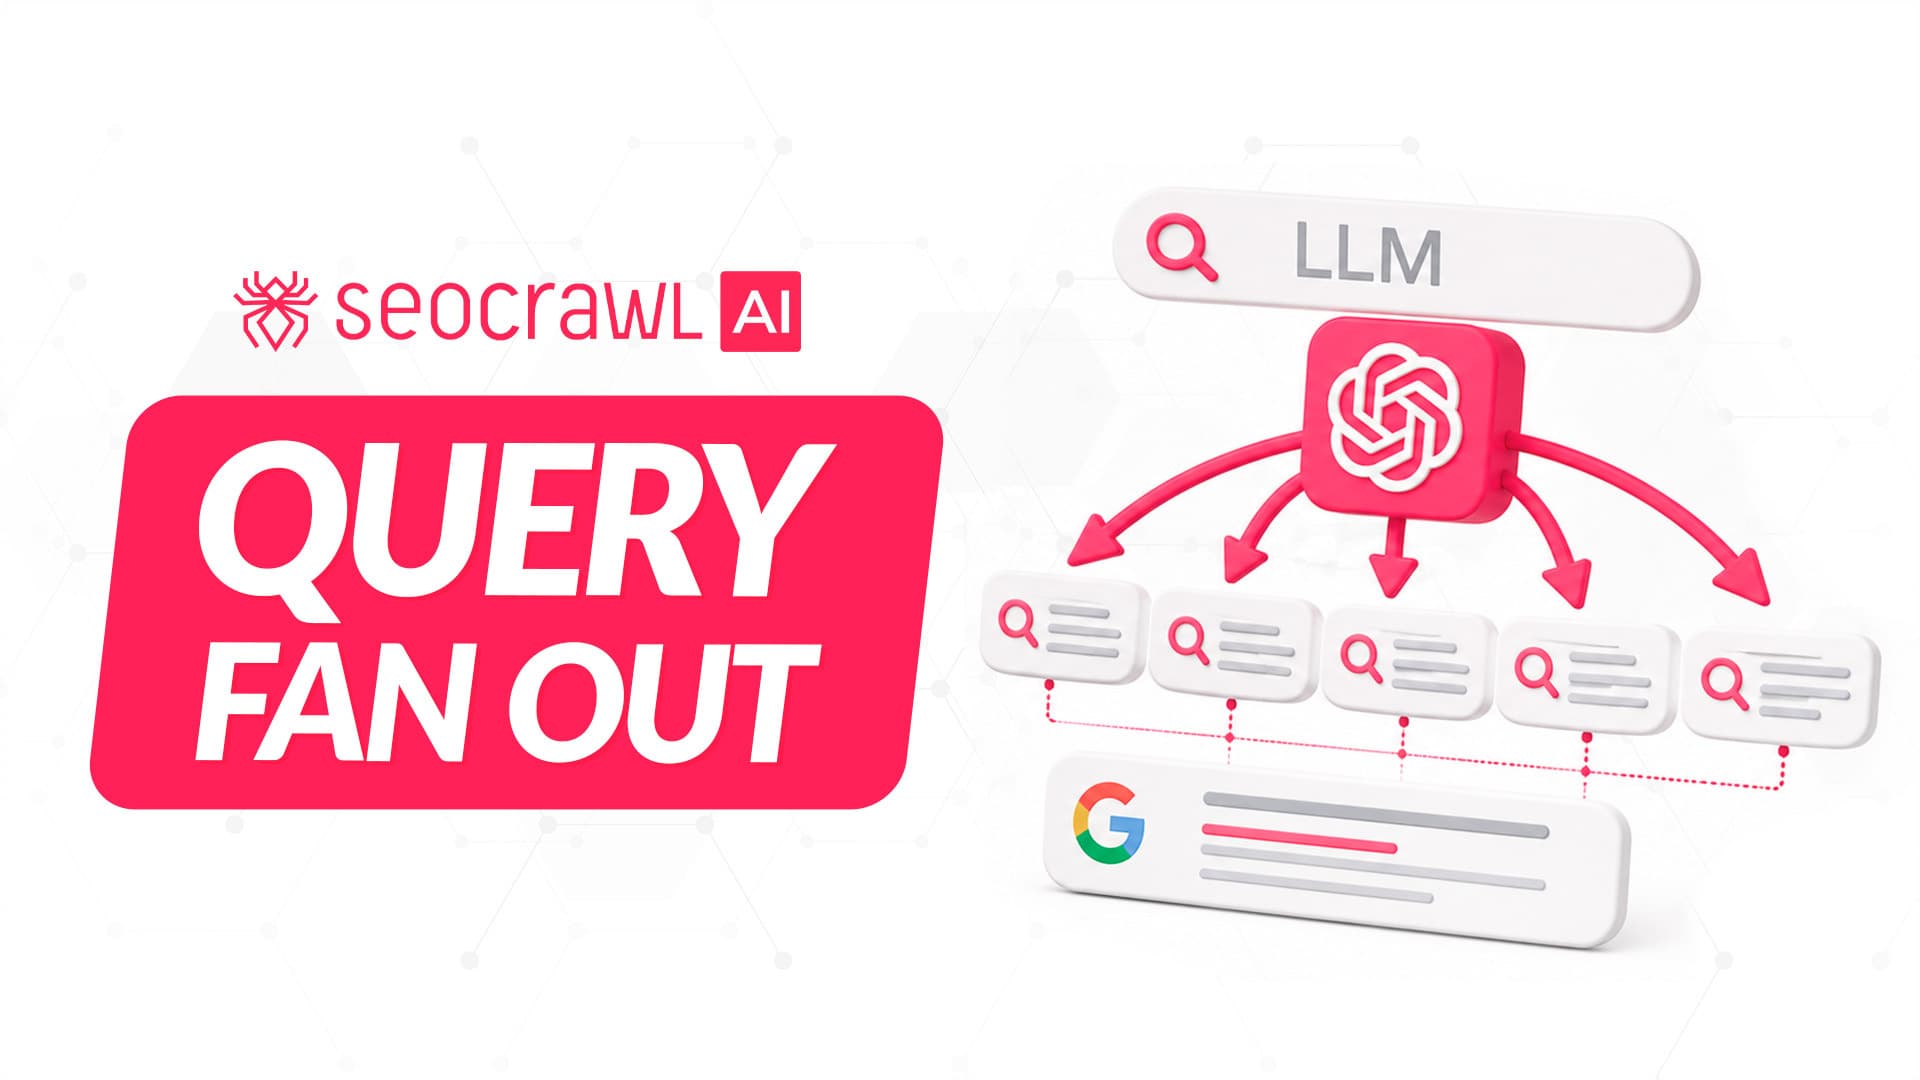
Query fan-out — это техника AI-поиска, которая превращает один запрос пользователя в десятки (а иногда и сотни) параллельных подзапросов, каждый из которых извлекает свою грань ответа, прежде чем LLM сведёт их в один отклик.
На этом методе работают Google AI Mode, ChatGPT и Perplexity, и он определяет, какой контент всплывает наверх и попадает в цитаты. Понимание того, как устроен fan-out, теперь обязательное условие для любой SEO- или контент-стратегии, рассчитанной на эпоху AI-поиска.
Что такое query fan-out?
Когда вы задаёте модели вопрос, система AI-поиска берёт его и разворачивает во множество параллельных подзапросов. Каждый из этих вопросов затем уходит извлекать конкретную информацию, а итоговый ответ, который вы видите, — это синтез всего, что вернулось.
Термин закрепился в 2024–2025 годах, когда Google начал раскатывать AI Mode. Инженеры и SEO-специалисты принялись реверс-инжинирить его работу, и обнаруженное оказалось не совсем новым. Классическое расширение запроса существует десятилетиями (добавление синонимов или смежных терминов к одному поиску), но query fan-out принципиально другой. Он не меняет запрос — он заменяет его множеством независимых, работающих одновременно.

Как это работает: шаг за шагом
За query fan-out стоит конвейер из четырёх отдельных этапов. Каждый важен, потому что каждый — это точка, где ваш контент либо попадает в ответ, либо отсеивается совсем.

Шаг 1: декомпозиция
AI разбирает запрос пользователя и выявляет каждую явную и неявную потребность, заложенную в нём.
Запрос вроде «лучший инструмент управления проектами для распределённых команд» просит не только рекомендацию продукта. Он неявно спрашивает и про функции совместной работы, цены, интеграции, отзывы пользователей и сравнения с альтернативами. Система вытаскивает всё это как отдельные цели для извлечения.
Шаг 2: параллельное извлечение
Каждый подзапрос уходит одновременно извлекать релевантные источники. Это и есть момент «fan-out»: вместо линейного поиска система запускает множество поисков параллельно. Происходит это за миллисекунды.
Шаг 3: агрегация источников
Результаты по каждому подзапросу возвращаются и объединяются в общий пул. Система оценивает, какие источники авторитетны, какие избыточны и какие закрывают грани, упущенные остальными.
Шаг 4: синтез
LLM берёт агрегированный пул источников и составляет итоговый ответ. Именно здесь ваш контент либо получает цитату, либо исчезает. Остаться за бортом не значит, что ваш контент плохо ранжировался, — это значит, что он не закрыл достаточную часть спектра подзапросов, чтобы пережить агрегацию.
Fan-out на разных платформах
Не все платформы реализуют query fan-out одинаково. Охват, скорость и типы подзапросов заметно различаются у Google, ChatGPT и Perplexity.
| Платформа | Охват fan-out | Поведение |
|---|---|---|
| Google AI Mode | Самый агрессивный — по наблюдениям, поднимает от десятков до сотен подзапросов | Глубоко раскладывает на смежные, неявные и сравнительные грани, затем синтезирует со ссылками |
| ChatGPT (search) | Умеренный | Переформулирует и расширяет запрос, выполняет веб-извлечение и цитирует ограниченный набор источников |
| Perplexity | Сфокусированный | Разбивает запрос на меньший набор точечных подзапросов, оптимизированных под быстрые ответы с обилием цитат |
Вывод не в точном числе на конкретной платформе — эти цифры меняются. Вывод в том, что все они раскладывают ваш запрос до того, как ответить, поэтому страница, закрывающая только буквальный вопрос, играет в заведомо худших условиях.
Типы порождаемых подзапросов
Понимание того, какие типы подзапросов ваш контент покрывает (а какие нет), — отправная точка любой стратегии оптимизации под fan-out.
| Тип подзапроса | Что извлекает | Пример (из «лучшая CRM для стартапов») |
|---|---|---|
| Переформулировки | То же намерение, переписанное синонимами | «лучший CRM-софт для компаний на ранней стадии» |
| Смежные | Соседние темы, которые пользователю тоже важны | «цены на CRM для небольших команд» |
| Сравнительные | Прямые сравнения и альтернативы | «HubSpot против Pipedrive для стартапов» |
| Неявные | Невысказанные потребности, зашитые в запрос | «CRM с бесплатным тарифом и простым онбордингом» |
| На свежесть | Свежая или чувствительная ко времени информация | «лучшие CRM для стартапов в 2026» |
| Расширение сущностей | Конкретные продукты, функции или названия | «интеграции CRM со Slack и Gmail» |
Чаще всего упускают два типа — сравнительные и неявные подзапросы: большинство контент-команд оптимизируется под заданный вопрос и игнорирует невысказанный.
Почему query fan-out важен для SEO
Query fan-out не влияет напрямую на классические позиции в Google. Позиция вашей синей ссылки определяется теми же сигналами, что и всегда. Fan-out меняет другое: попадёте ли вы в цитаты внутри AI-ответа.
- Проблема цитирования. Страница может быть #1 по ключевому слову и при этом никогда не появляться в AI-ответе, если она закрывает лишь один тип подзапроса.
- LLM invisibility. Это явление, когда страница ранжируется в классическом поиске, но её никогда не цитируют в AI-ответах. Fan-out повышает этот риск: чем больше подзапросов порождает промпт, тем больше граней должен закрывать ваш контент.
- Влияние на трафик. Ответы AI Overviews и AI Mode снижают кликабельность по тем запросам, где они появляются. Если ваш контент не цитируют внутри этих ответов, вы теряете видимость на обоих уровнях — вас нет в AI-ответе, и кликов из выдачи под ним меньше.
Как это отслеживать
Обычные трекеры позиций вообще не фиксируют присутствие в fan-out. Они умеют мерить вашу позицию в выдаче, но не видят включений в синтезированные AI-ответы.
Инструменты, созданные специально для мониторинга AI-поиска, — такие как AI Tracker и Prompt Tracking от SEOcrawl AI — измеряют упоминания бренда, долю цитирований и share of voice в ChatGPT, Claude, Gemini и Perplexity. Именно эти метрики показывают, переживает ли ваш контент агрегацию fan-out.
Как оптимизировать контент под query fan-out (7 советов)
Классическое SEO оптимизирует одну страницу под одно ключевое слово. Оптимизация под fan-out означает покрытие всего спектра подзапросов, который промпт способен породить.
- Свяжите контент со всем спектром подзапросов. Прежде чем писать или обновлять материал, спросите: какие неявные, смежные, сравнительные и высокоинтентные вопросы могут быть у человека, задающего этот промпт? Это и есть разделы, которые нужно построить.
- Наращивайте глубину темы, а не только ширину. AI, агрегирующий результаты, предпочтёт источник, который глубоко копает одну грань подзапроса, источнику, который поверхностно касается всех граней.
- Структурируйте контент так, чтобы AI мог извлечь отдельные ответы. Каждый раздел должен самостоятельно отвечать на конкретный вопрос. Понятные H2 и H3, ёмкие первые предложения в каждом разделе и формат FAQ — всё это помогает AI-системам вытаскивать чистые фрагменты во время агрегации.
- Усильте сигналы E-E-A-T. Во время агрегации AI оценивает авторитетность. Регалии автора, собственные данные, первоисточники и понятные редакционные стандарты — всё это влияет на то, выживет ли ваш контент.
- Используйте разметку FAQ и структурированные данные. FAQ schema — один из самых ясных сигналов того, что материал создан для ответа на конкретные вопросы, а это ровно то, что ищет извлечение при fan-out.
- Предугадывайте сравнительные и неявные подзапросы. Именно их упускают чаще всего. Стройте сравнительные блоки даже на страницах, которые формально не про сравнение, и закрывайте возражения, альтернативы и краевые случаи.
- Применяйте это и к собственным промптам. Если вы строите AI-агентов или агентные сценарии, понимание fan-out меняет то, как вы пишете главные промпты. Промпт, который предугадывает собственную декомпозицию (разбивая задачу на подзадачи заранее), даёт результаты лучше, чем тот, что оставляет всю декомпозицию модели.
Если вам нужна общая рамка вокруг всего этого, наше руководство по generative engine optimization объясняет, как fan-out вписывается в более широкий переход от SEO к GEO.
FAQ
Что такое query fan-out в AI-поиске?
Query fan-out — это процесс, в котором AI-система разворачивает один запрос пользователя во множество параллельных подзапросов, чтобы собрать исчерпывающую информацию. Его используют Google AI Mode, ChatGPT и Perplexity.
Сколько подзапросов порождает query fan-out?
Это зависит от платформы и сложности запроса: от нескольких штук до десятков и сотен, работающих одновременно. По общим наблюдениям, самый агрессивный fan-out среди крупных AI-систем — у Google AI Mode.
Влияет ли query fan-out на позиции в классическом SEO?
Напрямую нет. Fan-out влияет на попадание в AI-ответ и цитирование, а не на классические позиции синих ссылок. Но снижение кликабельности из-за AI-ответов действительно бьёт по органическому трафику по затронутым запросам.
Как оптимизировать контент под query fan-out?
Стройте исчерпывающее покрытие темы, предугадывайте неявные и сравнительные подзапросы, используйте структурированные данные и усиливайте сигналы E-E-A-T, чтобы ваш контент цитировали по разным типам подзапросов.
Что такое LLM invisibility?
Это явление, когда страница хорошо ранжируется в классическом поиске, но её никогда не цитируют в AI-ответах. Fan-out повышает этот риск, потому что контент должен закрывать более широкий спектр подзапросов, чтобы попасть в итоговый синтезированный ответ.
Query fan-out — это то же самое, что расширение запроса?
Нет. Классическое расширение запроса добавляет синонимы или смежные термины к одному поиску. Query fan-out порождает полностью отдельные параллельные подзапросы, каждый из которых извлекается и синтезируется независимо.
Применяется ли query fan-out за пределами поиска?
Да. В агентных AI-сценариях главный промпт точно так же раскладывается на подзадачи. Понимание fan-out полезно разработчикам и продуктовым AI-командам, а не только SEO-специалистам.
Автор: David Kaufmann

Последние 10 с лишним лет я полностью одержим SEO — и, честно говоря, не хотел бы иначе.
Моя карьера вышла на новый уровень, когда я работал старшим SEO-специалистом в Chess.com — одном из ста самых посещаемых сайтов интернета. Работа в таком масштабе: миллионы страниц, десятки языков и одна из самых конкурентных выдач — научила меня тому, чему не научит ни один курс и ни один сертификат. Этот опыт изменил моё представление о том, как выглядит по-настоящему сильное SEO, и лёг в основу всего, что я построил потом.
Из него выросло SEO Alive — агентство для брендов, которые всерьёз занимаются органическим ростом. Мы не продаём дашборды и ежемесячные отчёты. Мы строим стратегии, которые реально двигают цифры, соединяя классическое SEO с новым и захватывающим миром Generative Engine Optimization (GEO): чтобы ваш бренд появлялся не только в синих ссылках Google, но и внутри ответов, которые ChatGPT, Perplexity и Google AI Overviews каждый день выдают миллионам людей.
А поскольку инструмента, который нормально закрывает оба этих мира, я так и не нашёл, я сделал его сам — SEOcrawl AI, платформу SEO-аналитики корпоративного уровня, где в одном месте собраны позиции, технические аудиты, мониторинг ссылок, здоровье краулинга и отслеживание видимости бренда в ИИ. Это та платформа, которой мне всегда не хватало.
Откройте больше материалов этого автора