


«Descoberta, mas não indexada no momento»: o que significa e como corrigir
O Google sabe que sua URL existe e ainda não a visitou. Veja como saber se é hora de esperar ou agir e quais correções tentar primeiro em um site pequeno e em um grande.
Descoberta, mas não indexada no momento significa que o Google encontrou a URL, mas ainda não a rastreou. É assim que a ajuda do relatório de indexação de páginas do Google descreve. Normalmente o Google planejou o rastreamento e depois o reagendou, em vez de arriscar sobrecarregar seu site, e por isso a data do último rastreamento fica vazia no relatório.
É um status de prioridade de rastreamento, não um veredito sobre o seu conteúdo, porque o Google ainda não leu a página. Abaixo você vê como ele difere de «Rastreada», o que encontramos ao verificar nosso próprio site e uma lista de correções ordenada pelo tamanho do site. Está começando a usar o relatório? Comece por este guia do Google Search Console.
O que significa «Descoberta, mas não indexada no momento»
O Google leva uma URL por quatro etapas: encontra, rastreia, indexa e então pode exibir nos resultados. Dois status do Search Console descrevem uma URL que parou no caminho.
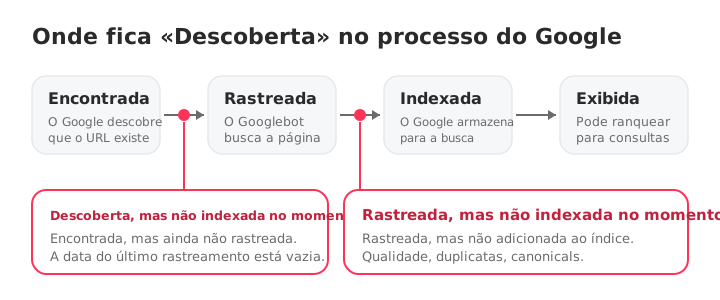
Uma URL chega a «encontrada» pelo seu sitemap ou por links de outras páginas. Depois o Google decide quando rastrear. «Descoberta» significa que essa decisão ainda não aconteceu.
Como difere de «Rastreada, mas não indexada no momento»
Os dois status parecem iguais e pedem correções diferentes.
| Descoberta, mas não indexada no momento | Rastreada, mas não indexada no momento | |
|---|---|---|
| Rastreada pelo Google? | Não | Sim |
| Data do último rastreamento | Vazia | Uma data |
| O Google leu a página? | Não | Sim |
| Motivo habitual | Rastreamento adiado ou de baixa prioridade | O Google leu a página e a descartou |
| Olhar primeiro | Links internos, sitemap, capacidade de rastreamento | Qualidade do conteúdo, duplicatas, canonicals |
O diagnóstico completo do segundo status está no guia de Rastreada, mas não indexada no momento.
Como é a lista em um site real
Verificamos o seocrawl.ai no relatório de Indexação do SEOcrawl. Das 1.000 URLs que o SEOcrawl monitora (nosso sitemap declara 6.310), 823 estão indexadas, ou 82,3%. 128 estão em «Rastreada, mas não indexada no momento» e 14 em «Descoberta, mas não indexada no momento».
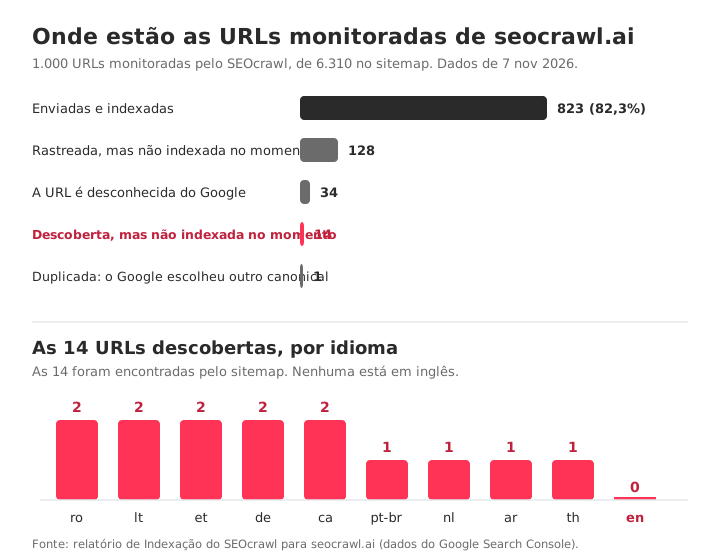
O que as 14 têm em comum é a parte útil:
- Todas são páginas traduzidas: árabe, catalão, alemão, estoniano, lituano, holandês, português (Brasil), romeno e tailandês. Nenhuma está em inglês.
- O Google encontrou as 14 pelo sitemap, e não por um link de outra página.
- Uma delas mostra uma data de rastreamento anterior (9 de maio de 2026), então o status descreve onde a URL está agora, e não que o Google nunca a visitou.
É um padrão a verificar, não um diagnóstico. Uma página que existe em 26 idiomas e é alcançada principalmente pelo sitemap é candidata natural a links internos fracos, então os links internos são a primeira coisa a olhar. A lição vale para qualquer site: não leia a lista URL por URL. Agrupadas por idioma, 14 URLs viraram uma única pergunta.
Os números cobrem as 1.000 URLs que o SEOcrawl monitora, uma amostra de todo o sitemap. O grupo maior, de 128 URLs, é o outro status e tem o seu próprio guia.
Por que o Google adia um rastreamento
O guia do orçamento de rastreamento do Google explica como ele decide quanto rastrear: um limite de capacidade que seu servidor aguenta e a demanda pelas suas URLs. A maioria das URLs descobertas remonta a uma destas cinco causas.
- Capacidade de rastreamento. O Google diz que o limite cai quando seu site fica lento ou retorna erros de servidor. Servidor lento significa menos rastreamentos.
- Baixa demanda de rastreamento. A demanda depende do tamanho do site, da frequência de atualização, da qualidade e da relevância das páginas. Uma URL com poucos links internos, ou nenhum, dá ao Google poucos motivos para voltar logo.
- Desperdício de rastreamento. URLs duplicadas, parâmetros, facetas, longas cadeias de redirecionamentos e soft 404 competem com suas páginas de verdade. O Google observa que os soft 404 continuam sendo rastreados e desperdiçam orçamento, e que ainda solicita uma página com noindex antes de descartá-la.
- Descoberta só pelo sitemap. Um sitemap avisa ao Google que uma URL existe. Não a torna prioridade, e o Google o trata como uma dica. Páginas encontradas só ali são as primeiras a esperar.
- Um site ou seção novos. Todo site começa com o mesmo limite de capacidade padrão, conservador, que cresce conforme o site prova estar saudável.
O orçamento de rastreamento em si só merece sua atenção em sites muito grandes. A estimativa aproximada do Google: 1.000.000+ de páginas únicas atualizadas mais ou menos toda semana, ou 10.000+ páginas que mudam todo dia. Em sites menores, as causas 2 e 4 são muito mais comuns.
É um problema? Três perguntas antes de corrigir qualquer coisa
- Esta URL deveria mesmo ser indexada? Se for uma visualização filtrada, uma página de busca interna ou uma URL de teste, deixá-la de fora é normal. Para deixar isso explícito, aplique noindex ou retorne 404 ou 410 (veja Excluded by 'noindex' tag).
- Quantas URLs, e com qual padrão? O Google diz que, com menos de 500 páginas, você provavelmente nem precisa deste relatório. A lista também é limitada a 1.000 linhas, então em um site grande ela é uma amostra.
- São novas? Uma URL publicada semana passada ainda não é problema. Os prazos do próprio Google estão na tabela abaixo.
Como corrigir, conforme o tamanho do site
A primeira medida certa depende do tamanho do seu site, então comece pela coluna certa.
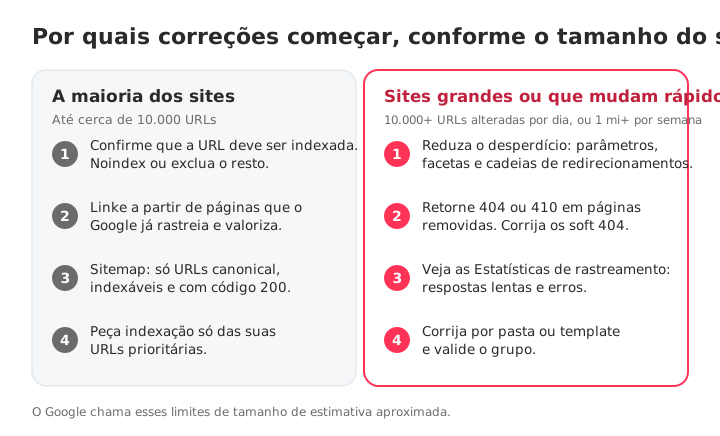
A maioria dos sites: até cerca de 10.000 URLs
- Confirme que a URL merece indexação. Se não merece, aplique noindex ou exclua e tire da sua lista.
- Linke a partir de páginas que o Google já rastreia. Adicione links contextuais, com âncoras descritivas, a partir de páginas indexadas que recebem tráfego. Qualquer crawler lista suas páginas órfãs filtrando as que têm zero links internos, e este guia de links internos traz o método completo.
- Mantenha o sitemap limpo. Inclua só URLs que retornam 200, são indexáveis e são a versão canonical, com um
lastmodpreciso. O Google ignora priority e changefreq. Se primeiro precisa do arquivo, encontre seu sitemap. Se o Search Console disser que não encontra nenhum, veja No referring sitemaps detected. - Solicite a indexação de algumas URLs prioritárias. Abra a ferramenta de inspeção de URL e clique em Solicitar indexação. O Google aplica uma cota e diz que pedidos repetidos não aceleram nada, então reserve para as páginas que mais importam.
Sites grandes ou que mudam rápido: 10.000+ URLs alteradas por dia, ou 1 mi+ por semana
- Reduza o desperdício de rastreamento. Bloqueie no robots.txt os espaços de URL sem valor de busca (parâmetros, facetas, busca interna) e consolide duplicatas com canonicals e redirecionamentos 301. Não conte com o noindex para economizar orçamento: o Google continua solicitando essas páginas.
- Retorne 404 ou 410 para páginas removidas e corrija os soft 404. O Google chama o 404 de sinal forte para não rastrear a URL de novo, enquanto URLs bloqueadas ficam mais tempo na fila. Encurte qualquer cadeia longa de redirecionamentos.
- Confira as Estatísticas de rastreamento. Em Configurações, o relatório Estatísticas de rastreamento mostra tempos de resposta e erros de servidor. Se estiverem altos, o Google reduz seu limite de capacidade, e nenhuma correção de conteúdo ajudará até o servidor melhorar.
- Corrija por pasta ou template e depois valide o grupo. Tome uma decisão por padrão, crie um sitemap só com as URLs corrigidas e clique em Validar correção. Saiba mais sobre orçamento de rastreamento se seu site estiver nessa faixa.
Esperar ou agir?
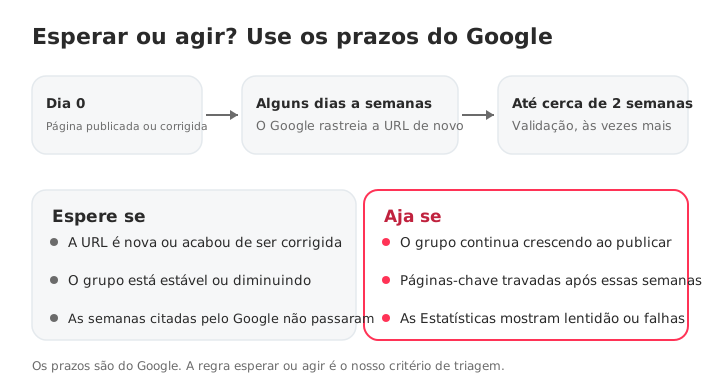
O mais difícil não é a correção, é saber quando parar de esperar. Use as faixas do próprio Google e a sua própria tendência.
| O que você fez | O que o Google diz | Fonte |
|---|---|---|
| Pediu ao Google para rastrear de novo | De alguns dias a algumas semanas | Pedir ao Google para rastrear de novo |
| Solicitou a indexação | Normalmente cerca de um dia, até uma ou duas semanas, com limite diário | Ajuda da inspeção de URL |
| Validou a correção | Até cerca de duas semanas, às vezes muito mais | Ajuda da indexação de páginas |
As faixas de tempo são do Google. A regra de esperar ou agir é nossa: espere enquanto a URL for nova e o grupo estiver estável ou diminuindo, e aja quando o grupo continuar crescendo ou suas páginas-chave ficarem travadas depois dessas semanas.
Como monitorar ao longo do tempo
O Search Console mostra o estado mais recente de cada URL e uma lista limitada a 1.000 linhas, então monte sua própria rotina:
- Uma vez por mês, exporte a lista e compare com a anterior. O grupo está crescendo, estável ou diminuindo?
- Agrupe por padrão (idioma, pasta, template) antes de olhar URLs isoladas.
- Veja como o Google encontrou cada URL. Uma lista toda «sitemap» e nada de «página de referência», como nas nossas 14 URLs, aponta direto para os links internos.
A visualização Indexação do SEOcrawl AI entrega essa lista pronta: filtre por estado de cobertura para ver as URLs dentro dele, com data do último rastreamento, cliques e impressões. Pelo MCP, cada URL vem também com o canonical escolhido pelo Google frente ao declarado e se foi encontrada pelo sitemap ou por uma página de referência. O Crawler audita as próprias páginas, para você ver o que está fraco em uma URL antes de pedir ao Google outra olhada, e o SEO Monitor avisa quando uma página-chave ganha noindex, muda o canonical, retorna 404 ou sai do sitemap.
Veja essa lista para o nosso próprio site, direto da visualização Indexação:
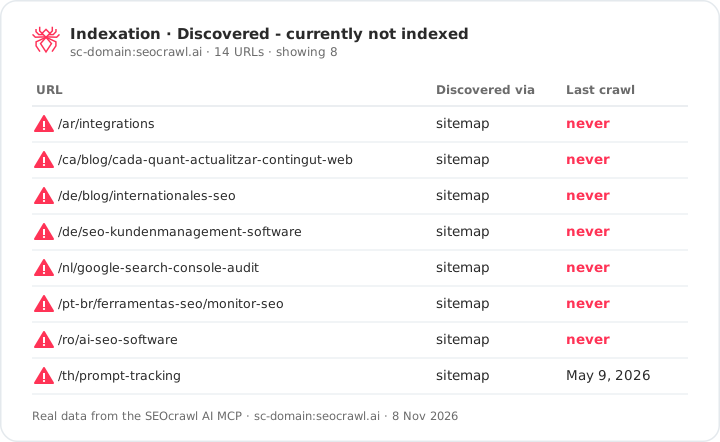
Você também pode dispensar o painel. Com o MCP do SEOcrawl AI conectado ao Claude ou ao ChatGPT, pergunte: «Liste as URLs em Descoberta, mas não indexada no momento e agrupe por pasta.» Aqui está o passo a passo para conectar o Search Console ao Claude e ao ChatGPT.
Perguntas frequentes
O que significa «Descoberta, mas não indexada no momento»?
Significa que o Google encontrou sua URL, mas ainda não a rastreou. Normalmente o Google planejou o rastreamento e depois o reagendou, e por isso a data do último rastreamento fica vazia (ajuda da indexação de páginas). O Google não leu a página, então o status não diz nada sobre a qualidade dela. Não é uma penalidade.
Quanto tempo dura «Descoberta, mas não indexada no momento»?
O Google não publica um prazo para este status. Ele diz que um novo rastreamento solicitado leva de alguns dias a algumas semanas, e que a validação de uma correção leva até cerca de duas semanas, às vezes muito mais. Uma URL nova pode simplesmente precisar dessas semanas. Se o grupo continuar crescendo conforme você publica, pare de esperar e aja.
Solicitar a indexação resolve?
Pode ajudar em algumas URLs prioritárias, porque pede ao Google que coloque a página na fila. Não elimina a causa, então a página pode voltar ao mesmo status. Os pedidos estão sujeitos a uma cota diária, e o Google diz que enviar a mesma URL várias vezes não acelera nada. Use depois de melhorar os links internos, nunca como ferramenta em massa.
É uma penalidade?
Não. Ações manuais aparecem em um relatório próprio. Este status significa que o Google encontrou a URL e ainda não a rastreou, então não avaliou a página. A causa costuma ser a prioridade de rastreamento: links internos fracos, servidor lento ou um monte de URLs de pouco valor disputando rastreamentos.
Por que tantas das minhas páginas estão descobertas, mas não indexadas?
Um número alto geralmente aponta para um padrão, e não para páginas isoladas: parâmetros de URL ou facetas, duplicatas, um sitemap com URLs que não deveriam estar lá, links internos fracos para uma seção inteira ou um servidor que atrasa o Googlebot. Agrupe as URLs por pasta, idioma ou template antes de olhar qualquer uma isoladamente.
Preciso me preocupar em um site pequeno?
Normalmente não. O Google diz que, se seu site tem menos de 500 páginas, você provavelmente nem precisa do relatório de indexação de páginas. Algumas URLs novas nesse status precisam, na maioria das vezes, de tempo e de alguns links internos a partir de páginas que o Google já rastreia.
Como o SEOcrawl AI pode ajudar com URLs descobertas?
A visualização Indexação do SEOcrawl AI lista as URLs paradas em cada estado de cobertura do Google, com data do último rastreamento, cliques e impressões. Pelo MCP do SEOcrawl AI você também pode pedir ao Claude ou ao ChatGPT essa lista com o canonical do Google frente ao declarado e se o Google encontrou cada URL pelo sitemap ou por uma página de referência, e agrupá-la por pasta.
Mais SEOcrawl AI no Google
Escolha a gente como fonte preferida e veja mais artigos nossos nas Principais notícias do Google.
Autor: David Kaufmann
Passei os últimos 10 e poucos anos completamente obcecado por SEO — e, sinceramente, não queria que fosse diferente.
Minha carreira subiu de patamar quando trabalhei como especialista sênior de SEO no Chess.com, um dos 100 sites mais visitados da internet inteira. Operar nessa escala, com milhões de páginas, dezenas de idiomas e uma das SERPs mais competitivas que existem, me ensinou coisas que nenhum curso ou certificação ensinaria. Essa experiência mudou minha visão do que é SEO de verdade — e virou a base de tudo o que construí depois.
Foi dela que nasceu a SEO Alive, uma agência para marcas que levam o crescimento orgânico a sério. Não estamos aqui para vender dashboards e relatórios mensais. Estamos aqui para construir estratégias que realmente movem o ponteiro, combinando o melhor do SEO clássico com o novo e empolgante mundo do Generative Engine Optimization (GEO) — garantindo que sua marca apareça não só nos links azuis do Google, mas dentro das respostas geradas por IA que o ChatGPT, o Perplexity e as AI Overviews do Google entregam a milhões de pessoas todos os dias.
E como eu não encontrava uma ferramenta que desse conta desses dois mundos direito, construí uma: a SEOcrawl AI, uma plataforma enterprise de inteligência em SEO que reúne rankings, auditorias técnicas, monitoramento de backlinks, saúde de rastreamento e acompanhamento da visibilidade da marca em IA — tudo no mesmo lugar. É a plataforma que eu sempre quis que existisse.
Descubra mais conteúdos deste autor
Medimos os cliques do Google e o tráfego de referência das IAs em mais de 16.000 sites de 15 setores. O tráfego de IA cresce 45% ao ano, mas ainda equivale a cerca de 1 visita para cada 100 do Google, enquanto os cliques do Google caíram 15%.

Até 30 de novembro, o primeiro ano de qualquer plano anual do SEOcrawl AI custa metade com o código BLACKFRIDAY2026. O que você recebe, o que os prompts de cada plano cobrem e como ver em 15 minutos onde o ChatGPT, o Gemini, o Claude e o Perplexity mencionam você.