„Excluded by 'noindex' tag“: ką tai reiškia ir kaip tai ištaisyti
Atidarėte Google Search Console, pastebėjote URL grupę su būsena „Excluded by 'noindex' tag“, ir dabar tų puslapių paieškoje nematyti.
Jei Google Search Console pastebėjote URL grupę su būsena „Excluded by 'noindex' tag“, jūsų puslapiai sąmoningai laikomi už Google indekso ribų, o sprendimas paprastai paprastesnis, nei atrodo: suraskite direktyvą, pašalinkite ją ir paprašykite Google puslapį nuskaityti iš naujo.
Šiame vadove paaiškinama, kas tiksliai sukelia šią būseną, kaip rasti už ją atsakingą noindex direktyvą ir kokie tikslūs žingsniai padės ją pašalinti visose populiariausiose TVS, kad jūsų puslapiai vėl galėtų reitinguotis. Tas pats patikrinimas automatiškai atliekamas SEOcrawl AI Crawler, kuris pažymi noindex direktyvas visoje svetainėje, netikrinant kiekvieno URL atskirai.
Ką Google Search Console reiškia „Excluded by 'noindex' tag“?
Būsena „Excluded by 'noindex' tag“ reiškia, kad Googlebot nuskaitė jūsų puslapį, rado noindex direktyvą ir jos paisė, neįtraukdamas puslapio į Google indeksą. Kol ši direktyva lieka, puslapis nebus rodomas paieškos rezultatuose.
Kur ši būsena rodoma GSC
Senojoje ataskaitoje „Coverage“ (2022 m. ją pakeitė ataskaita „Page indexing“) ši būsena buvo rodoma skiltyje „Excluded“. Dabartinėje ataskaitoje „Page indexing“ (Indexing › Pages) ją rasite skiltyje „Not indexed“, lentelėje „Why pages aren't indexed“, su priežastimi „Excluded by 'noindex' tag“. Google sugrupuoja visus paveiktus URL po šia žyma, kad galėtumėte juos eksportuoti ir peržiūrėti iš karto.
Kaip Google aptinka noindex direktyvą ir jos paiso
Google dokumentacijoje apie indeksavimo blokavimą naudojant noindex aprašyti du perdavimo būdai: žyma <meta name="robots" content="noindex"> puslapio HTML <head> dalyje arba direktyva X-Robots-Tag: noindex HTTP atsako antraštėse. Kai Googlebot aptinka bet kurią iš jų, jis visiškai pašalina puslapį iš indekso, net jei anksčiau puslapis buvo suindeksuotas. Pačios žymos pagrindus rasite mūsų vadove apie noindex meta žymą.
Ar tai visada problema? Kai išskyrimas yra sąmoningas
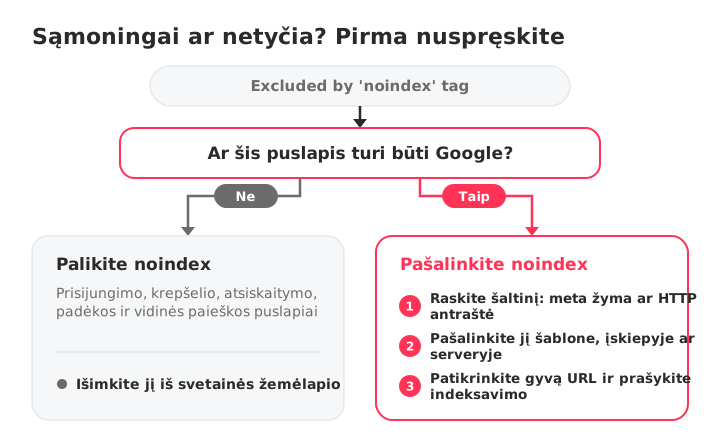
Ne kiekvienas URL su būsena „Excluded by 'noindex' tag“ yra klaida. Administravimo puslapiai, prisijungimo langai, krepšelio ir atsiskaitymo procesai, padėkos puslapiai ir vidinės paieškos rezultatai sąmoningai laikomi už Google indekso ribų. Jei šie puslapiai rodo šią būseną, sistema veikia taip, kaip numatyta. Tikroji problema prasideda tada, kai šią žymą turi puslapiai, kuriuos norite reitinguoti.
Dažniausios būsenos „Excluded by 'noindex' tag“ priežastys
Noindex direktyva jūsų puslapį gali pasiekti keliais skirtingais keliais. Nuo to, kuris iš jų aktyvus jūsų svetainėje, priklauso sprendimas.
Robots meta žyma su „noindex“ <head> dalyje
Dažniausias šaltinis. Eilutė, tokia kaip <meta name="robots" content="noindex">, puslapio HTML kode nurodo Googlebot jo neindeksuoti. Ji gali būti įrašyta tiesiai šablone arba dinamiškai įterpiama TVS, įskiepio ar temos funkcijos.
X-Robots-Tag HTTP atsako antraštėse
X-Robots-Tag veikia lygiai taip pat kaip meta žyma, tačiau yra HTTP atsako antraštėje, o ne HTML kode. Ją gali pridėti serverio konfigūracija, CDN taisyklės arba .htaccess direktyvos. Pavyzdžiui:
Header set X-Robots-Tag "noindex"
Tai paveikia kiekvieną taisyklę atitinkantį failą, įskaitant PDF failus ir paveikslėlius, kurie neturi HTML <head> dalies. Daugelis svetainių savininkų šį kelią visiškai pamiršta, nes direktyvos nesimato puslapio šaltinio kode.
TVS nustatymai, netyčia blokuojantys indeksavimą
WordPress skiltyje Settings › Reading yra žymimasis langelis „Discourage search engines from indexing this site“. Kai jis pažymėtas, WordPress kiekviename svetainės puslapyje prideda robots noindex žymą. Daugelis savininkų jį įjungia kūrimo metu ir po paleidimo pamiršta atžymėti.
Shopify noindex gali taikyti per temos kodą arba programėles. Kai kuriuos paskyros ir sistemos puslapius Shopify pati laiko už indekso ribų, ir tai teisinga, tačiau temos pakeitimas arba SEO programėlė gali per klaidą pridėti noindex prie produktų, kolekcijų ar tinklaraščio puslapių.
Wix taiko noindex bet kuriam puslapiui, kurio SEO nustatymai neleidžia paieškos sistemoms jo indeksuoti. Dažna priežastis: puslapis dubliuojamas, o kopija nepastebimai paveldi originalo noindex nustatymą.
Įskiepių ar temos konfliktai, pridedantys noindex
SEO įskiepiai leidžia nustatyti noindex atskiram įrašui, puslapiui ar turinio tipui. Netinkamai sukonfigūruota bendra taisyklė, įskiepio atnaujinimas, atstatantis nustatymus, arba tema, perrašanti įskiepio direktyvas, gali vienu metu išplatinti noindex dešimtyse puslapių. Jei neseniai atnaujinote įskiepį ar pakeitėte temą, pirmiausia patikrinkite tai.
Staging aplinkos nustatymai, perkelti į gyvą svetainę
Stebėtinai dažnas atsitiktinių noindex žymų šaltinis. Jūsų staging svetainė naudoja noindex, kad nepatektų į Google. Kai diegimo procesas perkelia staging konfigūraciją į gyvą svetainę, kartu su ja persikelia ir noindex direktyva. Paprastai tai iš karto paveikia ištisas svetainės skiltis ir yra viena sunkiausiai diagnozuojamų priežasčių, jei tikrinate tik atskirus puslapius.
Kaip nustatyti, kurie puslapiai paveikti
Pakartojamas diagnostikos procesas aptinka visus paveiktus URL be spėliojimų. Pradėkite nuo Search Console, kad gautumėte sąrašą, tada pereikite prie atskirų puslapių ir suraskite šaltinį.
Paveiktų URL eksportas per ataskaitą „Page indexing“
Atidarykite Google Search Console ir eikite į Indexing › Pages. Lentelėje „Why pages aren't indexed“ spustelėkite „Excluded by 'noindex' tag“. Search Console rodo paveiktų URL imtį; naudokite mygtuką Export, kad atsisiųstumėte sąrašą tolesniam darbui.
Vieno URL tikrinimas URL Inspection įrankiu
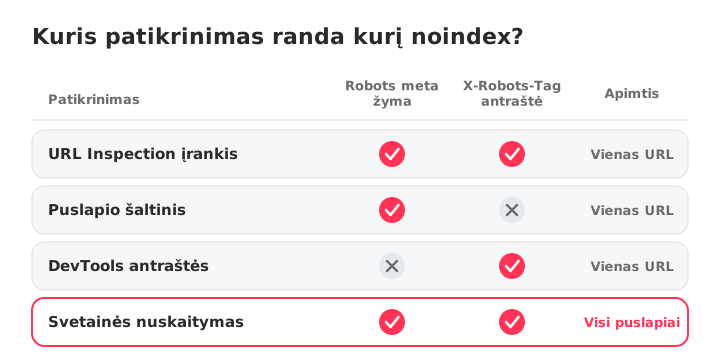
Įklijuokite bet kurį URL į paieškos juostą Search Console viršuje. URL Inspection įrankis parodo, ar Google matė noindex direktyvą ir kur ją rado: skiltyje „Indexing allowed?“ nurodoma, ar noindex atėjo iš robots meta žymos, ar iš X-Robots-Tag HTTP antraštės. Spustelėkite View crawled page, kad pamatytumėte tikslų HTML, kurį gavo Googlebot. Tai greičiausias įmanomas vieno puslapio patikrinimas.
Puslapio šaltinio kodo tikrinimas dėl noindex meta žymų
Atidarykite puslapį naršyklėje, spustelėkite dešiniuoju pelės mygtuku, pasirinkite Peržiūrėti puslapio šaltinį ir ieškokite „noindex“ (Ctrl+F arba Cmd+F). Jei rasite <meta name="robots" content="noindex"> ar kažką panašaus, kaltininkas yra meta žyma. Jei šaltinio kode jos nerandate, direktyva gali ateiti iš HTTP antraštės.
HTTP antraščių tikrinimas naršyklės DevTools
Atidarykite DevTools (F12 arba dešinysis pelės mygtukas › Tikrinti), eikite į skirtuką Network, perkraukite puslapį ir spustelėkite pagrindinio dokumento užklausą. Skiltyje Response Headers ieškokite X-Robots-Tag: noindex. Tai vienintelis būdas naršyklėje aptikti antraštėse siunčiamas noindex direktyvas, kurios nerodomos HTML kode.
Svetainės nuskaitymas su Screaming Frog arba SEOcrawl AI
Diagnozuojant visą svetainę, skaitytuvas vienu kartu aptinka kiekvieną paveiktą puslapį. Screaming Frog SEO Spider gali filtruoti puslapius pagal indeksuojamumą, atsižvelgdamas į meta žymas ir antraštes. SEOcrawl AI Crawler nuskaito kiekvieną puslapį, skiltyje Indexability pažymi kiekvieną puslapį su noindex direktyva ir pateikia Audit Health Score, todėl matote visą mastą be rankinio eksportavimo ir filtravimo.
Kaip ištaisyti „Excluded by 'noindex' tag“: žingsnis po žingsnio
Tai praktiškiausia skiltis. Taikykite sprendimą, atitinkantį jūsų diagnozę iš ankstesnės skilties.
Noindex meta žymos pašalinimas iš puslapio kodo
Redaguokite puslapio šabloną arba turinį ir pašalinkite <meta name="robots" content="noindex"> iš HTML <head> dalies. Individualiai kurtose svetainėse tiesiogiai patikrinkite šablonų failus. Jei žymą įterpia JavaScript, suraskite atsakingą skriptą ir jį pašalinkite arba pridėkite sąlygą.
Prieš:
<meta name="robots" content="noindex">
Po:
<meta name="robots" content="index, follow">
Arba tiesiog visiškai pašalinkite žymą. Google noindex direktyvos nebuvimą laiko leidimu indeksuoti.
X-Robots-Tag taisymas serverio ar CDN konfigūracijoje
Patikrinkite savo .htaccess (Apache), nginx.conf (Nginx) arba CDN taisykles, ar nėra X-Robots-Tag: noindex direktyvų. Pašalinkite jas arba apribokite konkrečiais keliais, kurie turi būti išskirti, o ne puslapiais, kuriuos norite indeksuoti. Pavyzdžiui, galite palikti noindex /staging/, o iš /blog/ jį pašalinti.
Kaip ištaisyti WordPress
Du patikrinimai tokia tvarka:
- Visos svetainės nustatymas: eikite į Settings › Reading ir atžymėkite „Discourage search engines from indexing this site“. Tai pati dažniausia visos svetainės noindex problemų priežastis WordPress.
- Atskirų puslapių nustatymai SEO įskiepiuose:
- Yoast SEO: atidarykite įrašą ar puslapį, slinkite iki Yoast meta bloko, spustelėkite skirtuką Advanced ir nustatykite „Allow search engines to show this content in search results?“ reikšmę „Yes“.
- Rank Math: atidarykite įrašą, eikite į Rank Math meta bloką, spustelėkite skirtuką Advanced ir nustatykite „Robots Meta“ reikšmę „Index“.
- All in One SEO: redaguokite įrašą, atidarykite AIOSEO nustatymų skirtuką Advanced ir įsitikinkite, kad robots nustatymuose nepažymėta „No Index“.
Taip pat patikrinkite kiekvieno įskiepio bendruosius nustatymus, ar ištisiems turinio tipams (žymoms, kategorijoms, pasirinktiniams įrašų tipams) nenustatytas noindex. Kitus WordPress nustatymus rasite mūsų vadove apie WordPress prijungimą prie Google Search Console.
Kaip ištaisyti Shopify
Shopify noindex dažniausiai atsiranda iš temos kodo arba programėlės. Atidarykite Online Store › Themes › Edit code ir theme.liquid bei puslapių šablonuose ieškokite robots meta žymos su noindex. Tada patikrinkite SEO programėles, ar nėra taisyklių, slepiančių produktus, kolekcijas ar tinklaraščio įrašus, ir visus produktus ar puslapius, kuriuose naudojamas metalaukas seo.hidden. Paskyros ir kitus sistemos puslapius Shopify pati laiko už indekso ribų, ir taip turėtų likti.
Kaip ištaisyti Wix, Squarespace ir kituose svetainių kūrimo įrankiuose
Wix: atidarykite puslapio SEO settings (iš puslapio meniu) ir įjunkite „Let search engines index this page“. Jei dubliavote puslapį, kopija galėjo paveldėti originalo noindex nustatymą.
Squarespace: patikrinkite visos svetainės SEO nustatymus, ar nėra parinkties, slepiančios svetainę nuo paieškos sistemų. Atskiriems puslapiams atidarykite puslapio nustatymus ir SEO skirtuke ieškokite „Hide page from search results“. Squarespace taip pat pagal numatytuosius nustatymus kai kuriuos sistemos puslapius, pavyzdžiui, krepšelį, laiko už paieškos rezultatų ribų.
Po pataisymo: pakartotinio indeksavimo užklausa Google Search Console
Pašalinus noindex žymą, Google sužino, kad gali indeksuoti puslapį, tačiau Googlebot vis tiek turi jį nuskaityti iš naujo, kad patvirtintų pakeitimą.
Indeksavimo užklausa per URL Inspection įrankį
Įklijuokite pataisytą URL į Search Console paieškos juostą. Spustelėkite Test live URL, kad patvirtintumėte, jog indeksuoti dabar leidžiama, tada spustelėkite Request indexing. Google įtrauks URL į pakartotinio nuskaitymo eilę. Taip galite pateikti kelis URL, tačiau Search Console riboja, kiek užklausų galima pateikti per dieną.
Per kiek laiko Google iš naujo suindeksuoja puslapį?
Paprastai per kelias dienas ar kelias savaites, priklausomai nuo to, kaip dažnai Googlebot nuskaito jūsų svetainę. Didelio srauto, dažnai atnaujinamos svetainės nuskaitomos iš naujo greičiau; naujos ar mažai lankomos svetainės gali laukti savaites. Indeksavimo užklausa yra greičiausias signalas, kurį galite nusiųsti, tačiau ne garantija: ji įtraukia jūsų URL į nuskaitymo eilę, o ne priverčia nedelsiant nuskaityti iš naujo.
Atnaujinto XML svetainės žemėlapio pateikimas nuskaitymui paspartinti
Jei vienu metu pataisėte daug puslapių, pateikite atnaujintą XML svetainės žemėlapį Search Console skiltyje Sitemaps. Tai signalizuoja, kad jūsų svetainė pasikeitė, ir skatina platesnį pakartotinį nuskaitymą. Švarus svetainės žemėlapis be noindex URL taip pat padeda išvengti prieštaringų signalų, apie kuriuos kalbėsime toliau.
Kada verta palikti noindex žymą (sąmoningi išskyrimai)
Ne kiekvieną noindex žymą reikia šalinti. Kai kurie puslapiai niekada neturėtų būti rodomi paieškos rezultatuose, o juos indeksuojant Google jūsų svetainės vaizde atsiranda menkaverčių ar dubliuotų puslapių ir švaistomas nuskaitymo dėmesys.
Puslapiai, kurių niekada nereikėtų indeksuoti
- Prisijungimo ir registracijos puslapiai
- Krepšelio, atsiskaitymo ir užsakymo patvirtinimo puslapiai
- Vidinės paieškos rezultatų puslapiai (kad būtų išvengta dubliuoto turinio)
- Padėkos puslapiai (lead magnet, formų pateikimas)
- Administravimo ir backend puslapiai
- Staging ir kūrimo aplinkos
- Filtrų ir parametrų puslapiai, generuojantys dubliuotus URL
Noindex ar robots.txt: pagrindiniai skirtumai
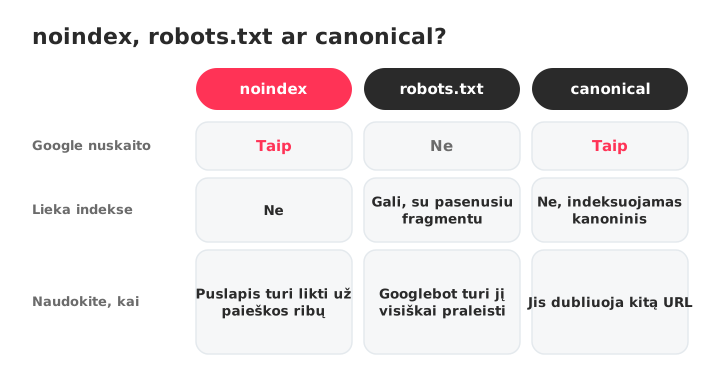
Robots.txt blokuoja nuskaitymą. Noindex leidžia nuskaityti, bet blokuoja indeksavimą. Jei užblokuosite puslapį robots.txt faile, Googlebot jo niekada neperskaitys, vadinasi, niekada nepamatys ir noindex žymos. Jei norite pašalinti puslapį iš indekso, naudokite noindex. Jei norite, kad Googlebot visiškai praleistų puslapį (kad sutaupytumėte nuskaitymo biudžetą), naudokite robots.txt.
Dažna klaida: naudoti robots.txt jau suindeksuotam puslapiui blokuoti. Google nemato noindex žymos, jei negali nuskaityti puslapio, todėl URL gali likti indekse su pasenusiu pavadinimu ir fragmentu. Teisingas būdas: leisti nuskaityti ir naudoti noindex, kad puslapis būtų pašalintas iš indekso.
Canonical žymos ar noindex: tinkamos direktyvos pasirinkimas
Canonical žyma (rel="canonical") sako Google: „šis puslapis yra kito URL kopija, reitinguok tą“. Noindex žyma sako Google: „šio puslapio visai neindeksuok“. Jų paskirtis skirtinga:
- Naudokite canonical, kai turite dubliuotą ar beveik dubliuotą turinį ir norite sutelkti reitingavimo signalus į vieną URL.
- Naudokite noindex, kai puslapis jokiomis aplinkybėmis neturi būti rodomas paieškos rezultatuose.
Abiejų derinimas tame pačiame puslapyje siunčia prieštaringus signalus: vienas sako „sujunk šį puslapį su kitu URL“, kitas sako „atmesk jį“. Pasirinkite tą, kuris atitinka jūsų tikslą.
Kaip ateityje išvengti atsitiktinių noindex žymų
Taisyti noindex problemas, kai jos jau atsirado, būtina, tačiau jų prevencija sutaupo daug valandų diagnostikos ir prarasto srauto.
Search Console įspėjimų apie indeksavimo kritimą nustatymas
Google Search Console siunčia el. laiškus patvirtintiems savininkams ir naudotojams, kai nuosavybėje aptinka naujų indeksavimo problemų. Įsitikinkite, kad Search Console el. pašto nuostatose įjungti pranešimai el. paštu. Jei suindeksuotų puslapių skaičius staiga krenta, įspėjimas suteikia jums laiko, kol dar nesumažėjo srautas.
Noindex patikrinimų įtraukimas į QA kontrolinį sąrašą prieš paleidimą
Prieš diegdami bet kurią svetainę ar perkeldami staging į gyvą aplinką, patikrinkite, ar nėra noindex direktyvų. 30 sekundžių patikrinimas su „Peržiūrėti puslapio šaltinį“ ir „noindex“ paieška aptinka dažniausią diegimo klaidą. Didesnėse svetainėse nuskaitykite svetainę prieš diegimą ir po jo ir palyginkite noindex puslapių skaičių. Įtraukite tai į savo techninio SEO kontrolinį sąrašą, kad niekas to nepraleistų.
Suplanuoti nuskaitymai nepageidaujamoms noindex direktyvoms aptikti
Reguliariai paleiskite pilną nuskaitymą, taip pat po kiekvieno įskiepio atnaujinimo, temos keitimo ar migracijos, kad aptiktumėte nepageidaujamas noindex žymas, kol jos dar nekainavo jums srauto. SEOcrawl AI Crawler leidžia palyginti nuskaitymus, todėl matote, kurie puslapiai gavo noindex ir kada, o SEO Monitor įspėja jus tą pačią akimirką, kai vienas iš jūsų svarbiausių puslapių gauna noindex žymą.
Dažniausiai užduodami klausimai
Ką Google Search Console reiškia būsena „Excluded by 'noindex' tag“?
Tai reiškia, kad Google jūsų puslapyje rado noindex direktyvą ir jos paisė, todėl puslapis nebus rodomas paieškos rezultatuose. Ši būsena rodoma Search Console ataskaitoje „Page indexing“, skiltyje „Not indexed“.
Tai ne visada klaida: puslapiai, kuriuos sąmoningai išskiriate, pavyzdžiui, prisijungimo ar atsiskaitymo, ir turi turėti šią būseną.
Kaip ištaisyti „Excluded by 'noindex' tag“ WordPress svetainėje?
Patikrinkite dvi vietas tokia tvarka. Pirmiausia eikite į Settings › Reading ir įsitikinkite, kad parinktis „Discourage search engines from indexing this site“ nepažymėta. Tada atidarykite kiekvieną paveiktą įrašą ar puslapį savo SEO įskiepyje (Yoast, Rank Math, All in One SEO) ir patikrinkite, ar puslapio robots nustatymas leidžia indeksuoti.
Per kiek laiko Google suindeksuoja puslapį pašalinus noindex?
Paprastai per kelias dienas ar kelias savaites, priklausomai nuo to, kaip dažnai Googlebot nuskaito jūsų svetainę. Pašalinę direktyvą, paprašykite indeksavimo per URL Inspection įrankį ir pateikite atnaujintą XML svetainės žemėlapį, kad procesas vyktų greičiau. Didelio srauto svetainės nuskaitomos iš naujo greičiau nei naujos ar mažai lankomos.
Ar puslapis gali būti išskirtas dėl noindex, net jei jis yra mano svetainės žemėlapyje?
Taip. Noindex direktyva yra viršesnė už įtraukimą į svetainės žemėlapį. Google gali ir toliau nuskaityti URL iš jūsų svetainės žemėlapio, tačiau jo neindeksuos, kol yra noindex.
Arba pašalinkite noindex, kad puslapį būtų galima suindeksuoti, arba išimkite URL iš svetainės žemėlapio, jei išskyrimas sąmoningas. Noindex URL įtraukimas į svetainės žemėlapį siunčia prieštaringus signalus.
Kuo skiriasi noindex nuo puslapio blokavimo robots.txt faile?
Robots.txt neleidžia Googlebot nuskaityti puslapio; noindex leidžia nuskaityti, bet neleidžia indeksuoti. Jei užblokuosite puslapį robots.txt faile, Google negalės perskaityti noindex žymos, todėl jau suindeksuotas puslapis gali likti indekse su pasenusiu turiniu. Naudokite noindex, kai norite pašalinti puslapį iš indekso, o robots.txt tik tada, kai norite visiškai uždrausti nuskaitymą.
Kaip patikrinti, ar puslapis turi noindex žymą?
Trys būdai, nuo greičiausio iki išsamiausio: pasinaudokite Search Console URL Inspection įrankiu, peržiūrėkite puslapio šaltinio kodą ir ieškokite „noindex“ (Ctrl+F) arba patikrinkite HTTP atsako antraštes naršyklės DevTools (skirtukas Network, ieškokite X-Robots-Tag). Tik URL Inspection įrankis ir DevTools aptinka antraštėje siunčiamą noindex.
Ar turėčiau nerimauti, jei daug puslapių rodo „Excluded by 'noindex' tag“?
Tik jei tie puslapiai turėtų būti suindeksuoti. Eksportuokite sąrašą iš Search Console, palyginkite jį su savo sąmoningais išskyrimais (prisijungimo, krepšelio, administravimo, padėkos puslapiai) ir taisykite tik tuos puslapius, kurie turėtų reitinguotis paieškoje. Jei kiekvieną paveiktą puslapį išskyrėte sąmoningai, būsena veikia teisingai.
Autorius: David Kaufmann

Pastaruosius 10+ metų praleidau visiškai apsėstas SEO — ir, tiesą sakant, nenorėčiau, kad būtų kitaip.
Mano karjera pakilo į naują lygį, kai dirbau vyresniuoju SEO specialistu Chess.com — vienoje iš 100 lankomiausių svetainių visame internete. Darbas tokiu mastu, apimant milijonus puslapių, dešimtis kalbų ir vieną konkurencingiausių SERPs, išmokė mane to, ko joks kursas ar sertifikatas niekada nebūtų galėjęs. Ta patirtis pakeitė mano supratimą apie tai, kaip iš tikrųjų atrodo puikus SEO — ir tapo pagrindu viskam, ką nuo tada sukūriau.
Iš tos patirties įkūriau SEO Alive — agentūrą prekės ženklams, kurie rimtai žiūri į organinį augimą. Mes čia ne tam, kad pardavinėtume dashboards ir mėnesines ataskaitas. Mes čia tam, kad kurtume strategijas, kurios iš tikrųjų daro poveikį, sujungdami tai, kas geriausia klasikiniame SEO, su jaudinančiu nauju Generative Engine Optimization (GEO) pasauliu — užtikrindami, kad jūsų prekės ženklas pasirodytų ne tik Google mėlynosiose nuorodose, bet ir AI sugeneruotuose atsakymuose, kuriuos ChatGPT, Perplexity ir Google AI Overviews kasdien pateikia milijonams žmonių.
Ir kadangi neradau įrankio, kuris tinkamai valdytų abu šiuos pasaulius, sukūriau jį pats — SEOcrawl AI, enterprise SEO intelligence platformą, kuri vienoje vietoje sujungia rankings, techninius auditus, backlinks stebėseną, crawl būklę ir AI prekės ženklo matomumo sekimą. Tai platforma, apie kurios egzistavimą visada svajojau.
Atraskite daugiau šio autoriaus turinio