„Crawled – currently not indexed“: ką tai reiškia ir kaip ištaisyti

Google aplankė jūsų URL, jį perskaitė ir paliko už paieškos ribų. Štai kaip atskirti, kurie puslapiai verti antros galimybės, ir ką Google pataria daryti, kad jie grįžtų į indeksą.
„Crawled – currently not indexed“ (nuskaitytas, bet šiuo metu neindeksuotas) reiškia, kad Googlebot atsisiuntė jūsų puslapį ir nusprendė neįtraukti jo į Google indeksą, todėl jis negali pasirodyti paieškoje. Ataskaitos „Page indexing“ pagalboje tai aprašyta taip: puslapis buvo nuskaitytas, bet nesuindeksuotas, ir „ateityje jis gali būti suindeksuotas, o gali ir nebūti“.
Priežastis paprastai yra pats puslapis, o ne techninis blokavimas. Toliau sužinosite, kaip kiekvienam URL nuspręsti, ar puslapį taisyti, pažymėti noindex, ar ištrinti, ir kiek laiko pagal Google užtrunka pataisymas. Ši ataskaita jums nauja? Pradėkite nuo šio Google Search Console vadovo.
Ką reiškia „Crawled – currently not indexed“?
Ši būsena reiškia, kad Google nuskaitė puslapį ir nusprendė jo neindeksuoti. Niekas neblokavo Googlebot: Google kol kas nusprendė puslapio neįtraukti. Teisingai suprasti būseną padeda du skirtumai.
Nuskaitytas ir suindeksuotas
Nuskaitymas – tai Googlebot atliekamas puslapio atsisiuntimas. Indeksavimas – tai puslapio išsaugojimas Google sistemoje, kad jis galėtų pasirodyti paieškose. Puslapis gali būti nuskaitytas daugybę kartų ir vis tiek niekada nebūti suindeksuotas.
URL Inspection įrankio pagalboje sakoma, kad puslapio kokybė turi būti „pakankamai aukšta, kad pateisintų indeksavimą“, o šio įrankio tiesioginis testas šios būsenos apskritai negali patikrinti.
Kuo tai skiriasi nuo „Discovered – currently not indexed“
„Discovered – currently not indexed“ (aptiktas, bet šiuo metu neindeksuotas) yra vienu žingsniu ankstesnė būsena: Google rado URL, bet atidėjo nuskaitymą, kad neapkrautų jūsų svetainės, todėl paskutinio nuskaitymo data tuščia.
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| Ar Google nuskaitė? | Ne | Taip |
| Paskutinio nuskaitymo data | Tuščia | Nurodyta data |
| Įprasta priežastis | Nuskaitymas atidėtas, kad nebūtų apkrauta svetainė | Google perskaitė puslapį ir jį praleido |
| Pirmiausia žiūrėkite į | Nuskaitymo pajėgumą labai didelėse svetainėse | Turinio kokybę, dublikatus, canonical |
Google taip pat teigia: „Tai, kad puslapis neindeksuotas, nebūtinai yra blogai.“ Puslapiai su noindex, robots.txt užblokuoti URL, dublikatai ir 404 be pakaitalo ir turi likti už indekso ribų.
Kodėl Google nuskaito puslapius, bet jų neindeksuoja
Indeksavimui taikoma kokybės kartelė, kurios nėra nuskaitymui. Google nuskaitymo biudžeto vadove teigiama, kad nuskaitymo poreikis auga kartu su jūsų turinio verte ir unikalumu.
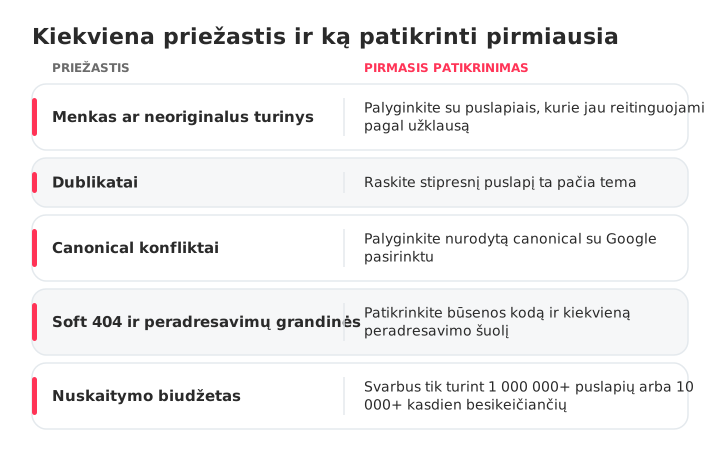
Dauguma paveiktų URL patenka į vieną iš šių priežasčių, ir kiekviena turi savo pirmąjį patikrinimą:
- Menkas ar neoriginalus turinys: puslapis kartoja tai, kas jau reitinguojama.
- Dublikatai: žymų archyvai, rūšiuoti URL, du įrašai ta pačia tema. Štai kaip aptikti ir ištaisyti raktažodžių kanibalizaciją.
- Canonical konfliktai: palyginkite savo nurodytą canonical su tuo, kurį pasirinko Google. Kai Google pasirenka kitą URL, puslapis paprastai pereina į „Alternate page with proper canonical tag“ arba dublikato būseną.
- Soft 404 ir peradresavimų grandinės: Google teigia, kad soft 404 švaisto nuskaitymo biudžetą.
- Nuskaitymo biudžetas: jis svarbus svetainėms, kuriose yra daugiau nei 1 000 000 puslapių, besikeičiančių kas savaitę, arba daugiau nei 10 000, besikeičiančių kasdien. Daugumai svetainių tai nėra priežastis.
Kartelė pakilo dviem datuotais žingsniais. 2022 m. rugpjūčio 18 d. Google paskelbė naudingo turinio atnaujinimą – visos svetainės signalą – ir teigė, kad pašalinus nenaudingą turinį gali pagerėti likusi svetainės dalis. 2024 m. kovo 5 d. Google paskelbė pagrindinį atnaujinimą, skirtą rodyti mažiau paspaudimams pritraukti sukurto turinio, kartu su nauja masinio turinio piktnaudžiavimo šlamšto politika.
Google naudingo turinio gairėse teigiama, kad E-E-A-T nėra konkretus reitingavimo veiksnys, kad svarbiausia yra patikimumas ir kad nėra pageidaujamo žodžių skaičiaus. Puslapio išpūtimas jo neištaisys.
Kaip GSC rasti ir diagnozuoti paveiktus puslapius
Atidarykite ataskaitą „Page indexing“ (anksčiau „Coverage“), patikrinkite imtį ir sugrupuokite sąrašą pagal dėsningumus. Google pažymi, kad svetainėms, turinčioms mažiau nei 500 puslapių, šios ataskaitos greičiausiai nereikia.
Paveiktų URL paieška ataskaitoje „Pages“
- Google Search Console eikite į Indexing › Pages.
- Skiltyje „Why pages aren't indexed“ spustelėkite „Crawled – currently not indexed“.
- Spustelėkite Export ir atsisiųskite sąrašą.
Ataskaitoje rodoma iki 1 000 URL pavyzdžių, nebūtinai visi, todėl didelėje svetainėje eksportas yra tik imtis.
Puslapių tikrinimas su URL Inspection įrankiu
Patikrinkite penkis–dešimt eksportuotų URL ir pažiūrėkite paskutinio nuskaitymo datą bei Google-selected canonical (Google pasirinktą canonical). Jei canonical rodo kitur, Google mato dublikatą; jei nuskaitymo data seniai praėjusi, tikėtina, kad Google retai sugrįžta.
Dėsningumų paieška šimtuose URL
Surūšiuokite eksportą pagal aplanką, šabloną ir URL parametrą, tada suskaičiuokite kiekvieną grupę. Tarkime, 300 URL pasiskirsto į 180 /tag/ puslapių, 70 ?sort= URL ir 50 įrašų: tai trys sprendimai, o ne 300.
Taisyti, noindex ar ištrinti: nuspręskite, ko vertas kiekvienas URL
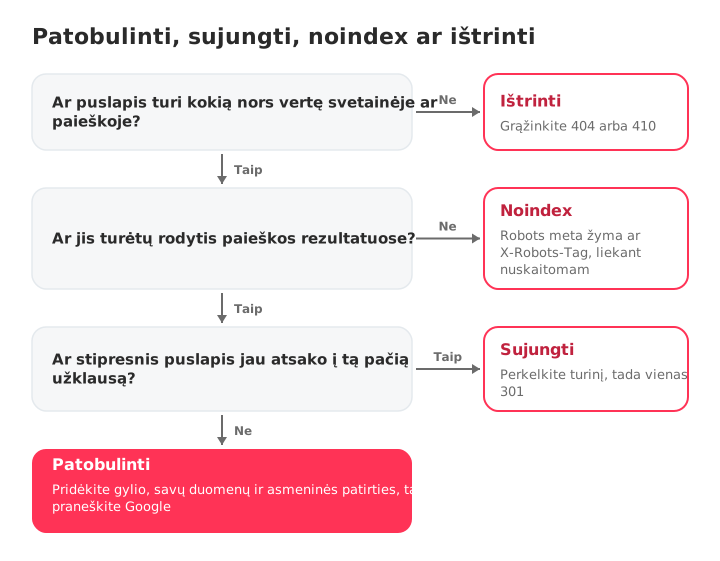
Kiekvienas URL nusipelno vieno iš keturių sprendimų. Paklauskite: ar ieškantysis apsidžiaugtų čia patekęs ir ar tai vienintelis jūsų svetainės puslapis, atsakantis į šią užklausą?
| Puslapio tipas | Pavyzdys | Sprendimas | Kaip |
|---|---|---|---|
| Naudingas ir unikalus, bet menkas | 300 žodžių vadovas tema, kurią išmanote | Patobulinti | Pridėkite gylio ir asmeninės patirties detalių |
| Dubliuoja stipresnį puslapį | Du įrašai ta pačia užklausa | Sujungti | Perkelkite turinį, tada 301 peradresavimas |
| Naudingas svetainėje, ne paieškoje | Žymų archyvai, vidinė paieška, padėkos puslapiai | Noindex | Robots meta žyma arba X-Robots-Tag |
| Jokios vertės, jokio pakaitalo | Pasibaigusios akcijos, bandomieji puslapiai | Ištrinti | Grąžinkite 404 arba 410 |
Google nuskaitymo biudžeto vadovas patvirtina dvi paskutines eilutes: pašalintiems puslapiams grąžinkite 404 arba 410 ir sujunkite dublikatus. 404 Search Console yra normalu puslapiams, kuriuos pašalinote sąmoningai.
Būtent su noindex rūšiuojant dažniausiai suklystama:
Ne taip: noindex žyma /tag/ puslapiuose, kai robots.txt blokuoja /tag/. Googlebot negali atsisiųsti puslapių, todėl žymos niekada nemato.
O taip: /tag/ lieka nuskaitomas ir turi noindex kaip meta žymą arba X-Robots-Tag antraštę.
Pagal Google noindex dokumentaciją taisyklė neveikia robots.txt faile, o retai lankomuose puslapiuose pakartotinis nuskaitymas gali užtrukti mėnesius. Perskaičius žymą, tie URL pereina į „Excluded by 'noindex' tag“, ir būtent to jiems ir norite.
Kaip ištaisyti indeksuoti vertus puslapius
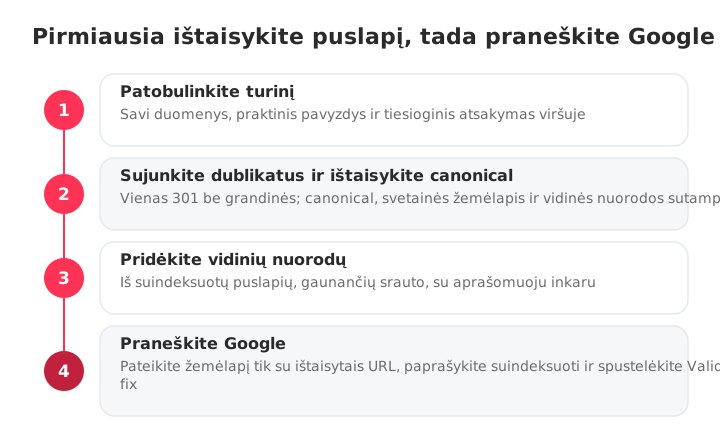
Pirmiausia padarykite puslapį vertą indeksuoti, tada praneškite Google. Prašydami suindeksuoti nepakeistą puslapį, prašote Google pakartoti jau priimtą sprendimą. Eiliškumas:
- Patobulinkite turinį.
- Sujunkite dublikatus ir ištaisykite canonical.
- Pridėkite vidinių nuorodų.
- Pateikite tikslinį svetainės žemėlapį ir paprašykite suindeksuoti.
Pagerinkite turinio gylį ir originalumą
Perrašykite atsižvelgdami į užklausą, o ne į žodžių skaičių: pridėkite savų duomenų, ekrano kopijų, praktinį pavyzdį ir tiesioginį atsakymą puslapio viršuje.
Pavyzdžiui, paimkite menką 300 žodžių vadovą: pridėkite asmeninės patirties duomenų rinkinį ir praktinį pavyzdį, pateikite nuorodą į jį iš dviejų įrašų, kurie jau gauna srauto, ir tik tada įtraukite jį į tikslinį svetainės žemėlapį.
Sujunkite dublikatus ir ištaisykite canonical
Kai du URL apima tą patį, palikite vieną, perkelkite į jį naudingą turinį ir kitą peradresuokite 301 tiesiai į jį, be grandinės. Tada patikrinkite, ar canonical, svetainės žemėlapis ir vidinės nuorodos sutampa ir ar neliko pasiklydusio noindex.
Pridėkite vidinių nuorodų iš puslapių, kuriuos Google jau vertina
Į kiekvieną ištaisytą puslapį nukreipkite nuorodas iš suindeksuotų puslapių, gaunančių srauto, naudodami aprašomąjį inkarą. Bet kuris svetainės skaitytuvas gali išvardyti puslapius našlaičius (be vidinių nuorodų), filtruodamas pagal nulį įeinančių nuorodų. Visą metodą rasite vidinių nuorodų strategijos vadove.
Taip pat patikrinkite puslapį telefone ir „Core Web Vitals“ ataskaitoje: sugedusį mobilųjį puslapį atmesti greita.
Pateikite tikslinį svetainės žemėlapį ir paprašykite suindeksuoti
Sukurkite svetainės žemėlapį tik su ištaisytais URL, pateikite jį ir pagal jį filtruokite ataskaitą „Pages“, prieš spustelėdami Validate fix. Google tai siūlo, kad patvirtinimas vyktų greičiau. Jei pirmiausia reikia dabartinio failo, raskite savo svetainės žemėlapį.
Google ignoruoja priority ir changefreq, todėl verčiau palaikykite tikslų lastmod. Tada URL Inspection įrankyje prioritetiniams URL spustelėkite Request indexing: Google taiko kvotą ir teigia, kad pakartotiniai prašymai nieko nepagreitina.
Per kiek laiko puslapis suindeksuojamas po pataisymo?
Tikėkitės nuo dienos iki kelių savaičių, o indeksavimas niekada nėra garantuotas. Skirtinguose puslapiuose Google nurodo skirtingus terminus, todėl štai jie greta:
| Ką padarėte | Ką sako Google | Šaltinis |
|---|---|---|
| Paprašėte Google nuskaityti iš naujo | Nuo kelių dienų iki kelių savaičių | Ask Google to recrawl |
| Request indexing | Paprastai maždaug diena, iki savaitės ar dviejų, su dienos limitu | URL Inspection pagalba |
| Validate fix | Iki maždaug dviejų savaičių, kartais daug ilgiau | Page indexing pagalba |
Tai Google nurodyti terminai, o ne atsigavimo atvejai. Kas savaitę tikrinkite ataskaitą „Pages“; jei praėjus šiems terminams ištaisyti URL nepajudėjo, grįžkite prie turinio.
Kaip neleisti naujiems puslapiams patekti į šią būseną
Prevencija yra rutina: patikrinkite kiekvieną puslapį prieš paskelbdami ir kas mėnesį peržiūrėkite Search Console. Prieš skelbdami įsitikinkite, kad puslapis:
- Atsako į užklausą, į kurią neatsako joks kitas jūsų svetainės puslapis.
- Prideda jūsų pačių duomenų, pavyzdžių ar patirties.
- Turi į save rodantį canonical ir neturi pasiklydusio noindex.
- Yra svetainės žemėlapyje su tiksliu lastmod.
- Turi įvardytą autorių ir, kur tinka, struktūrizuotus duomenis.
- Gauna nuorodą iš susijusio, suindeksuoto puslapio.
Kartą per mėnesį palyginkite ataskaitą „Pages“ su ankstesniu mėnesiu; problema sąraše lieka 90 dienų po to, kai išnyksta paskutinis jos atvejis. Svetainės, turinčios daugiau nei tūkstantį puslapių, taip pat turėtų stebėti ataskaitą „Crawl Stats“.
SEOcrawl AI tvarko techninę pusę dideliu mastu. Crawler nuskaito kiekvieną puslapį ir pateikia Audit Health Score, o problemos suskirstytos pagal Indexability, Crawlability, On-Page ir kitas kategorijas. Jo Indexation rodinys grupuoja jūsų URL pagal Search Console aprėpties būseną, todėl matote, kiek jų yra būsenoje „Crawled – currently not indexed“, ir galite stebėti skaičių laikui bėgant.
Tarp nuskaitymų SEO Monitor įspėja, kai svarbus puslapis gauna noindex, pakeičia canonical, grąžina 404 arba dingsta iš svetainės žemėlapio. Ta pati platforma stebi jūsų prekės ženklo matomumą ChatGPT, Claude, Gemini, Perplexity ir Copilot, todėl SEO ir GEO yra vienoje vietoje.
DUK
Ką reiškia „Crawled – currently not indexed“?
Tai reiškia, kad Googlebot atsisiuntė jūsų puslapį ir nusprendė neįtraukti jo į Google indeksą, todėl jis negali pasirodyti paieškoje. Niekas neblokavo nuskaitymo: Google perskaitė puslapį ir kol kas nusprendė jo neįtraukti. Tai nėra rankinė nuobauda, o puslapis ateityje gali būti suindeksuotas, o gali ir ne.
Ar tai tas pats kaip „Discovered – currently not indexed“?
Ne. „Discovered“ reiškia, kad Google žino URL, bet atidėjo jo nuskaitymą, todėl paskutinio nuskaitymo data tuščia. „Crawled“ reiškia, kad Google jau aplankė ir perskaitė puslapį, o tada nusprendė jo neindeksuoti. Esant „Discovered“, labai didelėse svetainėse žiūrėkite į nuskaitymo pajėgumą; esant „Crawled“ – į turinio kokybę, dublikatus ir canonical.
Ar „Crawled – currently not indexed“ kenkia mano SEO?
Savaime ne: ši būsena nėra nuobauda, o paveiktas puslapis praranda tik savo paieškos srautą. Rizika slypi kiekyje, nes didelę nenaudingo turinio dalį Google vertina kaip visos svetainės signalą. Žymų archyvas už indekso ribų nieko nekainuoja; produkto puslapis – kainuoja. Jei skaičius auga kaskart, kai ką nors paskelbiate, vertinkite tai kaip visos svetainės turinio problemą, o ne kaip atskirų URL sąrašą.
Per kiek laiko puslapis suindeksuojamas po pataisymo?
Tikėkitės nuo dienos iki kelių savaičių, o indeksavimas niekada nėra garantuotas. Google teigia, kad pakartotinis nuskaitymas užtrunka nuo kelių dienų iki kelių savaičių, Request indexing paprastai apdorojamas maždaug per dieną, bet gali užtrukti savaitę ar dvi, o Validate fix paprastai trunka iki maždaug dviejų savaičių.
Ar padeda prašymas suindeksuoti?
Tik pakeitus puslapį. Prašydami suindeksuoti nepakeistą puslapį, prašote Google pakartoti jau priimtą sprendimą. Prašymams taikoma dienos kvota, o Google teigia, kad kelis kartus siunčiant tą patį URL niekas nepagreitėja.
Ar padeda puslapio įtraukimas į XML svetainės žemėlapį?
Tai padeda Google rasti URL, o ne jį suindeksuoti. Google pateiktą svetainės žemėlapį vadina „tik užuomina“, o šie puslapiai jau rasti ir perskaityti. Po pataisymo svetainės žemėlapio užduotis – sugrupuoti URL, kuriuos norite patikrinti iš naujo. Viename svetainės žemėlapio faile telpa iki 50 000 URL arba 50 MB.
Kodėl nepavyko „Crawled – currently not indexed“ patvirtinimas?
Patvirtinimas sustoja, vos Google randa grupėje vieną dar neištaisytą URL, todėl vienas likęs puslapis gali sužlugdyti visą grupę. Ištaisykite kiekvieną grupės URL arba susiaurinkite grupę, filtruodami ataskaitą pagal svetainės žemėlapį, kuriame yra tik ištaisyti URL, ir patvirtinkite dar kartą.
Kaip SEOcrawl AI padeda su puslapiais, kuriuos Google nuskaito, bet neindeksuoja?
SEOcrawl AI randa šios būsenos priežastis pačioje svetainėje. Crawler rodo kiekvieno URL būklės balą, HTTP būsenos kodą ir nuskaitymo gylį, todėl pastebite puslapius, kuriuos Google sunku pasiekti. Indexation rodinys grupuoja jūsų URL pagal Search Console aprėpties būseną, o SEO Monitor įspėja, kai svarbus puslapis gauna noindex, pakeičia canonical, grąžina 404 arba dingsta iš svetainės žemėlapio.
Autorius: David Kaufmann

Pastaruosius 10+ metų praleidau visiškai apsėstas SEO — ir, tiesą sakant, nenorėčiau, kad būtų kitaip.
Mano karjera pakilo į naują lygį, kai dirbau vyresniuoju SEO specialistu Chess.com — vienoje iš 100 lankomiausių svetainių visame internete. Darbas tokiu mastu, apimant milijonus puslapių, dešimtis kalbų ir vieną konkurencingiausių SERPs, išmokė mane to, ko joks kursas ar sertifikatas niekada nebūtų galėjęs. Ta patirtis pakeitė mano supratimą apie tai, kaip iš tikrųjų atrodo puikus SEO — ir tapo pagrindu viskam, ką nuo tada sukūriau.
Iš tos patirties įkūriau SEO Alive — agentūrą prekės ženklams, kurie rimtai žiūri į organinį augimą. Mes čia ne tam, kad pardavinėtume dashboards ir mėnesines ataskaitas. Mes čia tam, kad kurtume strategijas, kurios iš tikrųjų daro poveikį, sujungdami tai, kas geriausia klasikiniame SEO, su jaudinančiu nauju Generative Engine Optimization (GEO) pasauliu — užtikrindami, kad jūsų prekės ženklas pasirodytų ne tik Google mėlynosiose nuorodose, bet ir AI sugeneruotuose atsakymuose, kuriuos ChatGPT, Perplexity ir Google AI Overviews kasdien pateikia milijonams žmonių.
Ir kadangi neradau įrankio, kuris tinkamai valdytų abu šiuos pasaulius, sukūriau jį pats — SEOcrawl AI, enterprise SEO intelligence platformą, kuri vienoje vietoje sujungia rankings, techninius auditus, backlinks stebėseną, crawl būklę ir AI prekės ženklo matomumo sekimą. Tai platforma, apie kurios egzistavimą visada svajojau.
Atraskite daugiau šio autoriaus turinio

Produktų sąrašo puslapis (PLP) vienu metu parodo visą produktų kategoriją. Sužinokite, kuo jis skiriasi nuo PDP, kas lemia jo konversijas ir kaip suindeksuoti sąrašo puslapius neįklimpus į filtruojamos navigacijos chaosą.
