


«Ditemukan - saat ini tidak diindeks»: arti dan cara memperbaikinya
Google tahu URL Anda ada dan belum mengunjunginya. Berikut cara menilai apakah harus menunggu atau bertindak, dan perbaikan apa yang dicoba lebih dulu di situs kecil maupun besar.
Ditemukan - saat ini tidak diindeks berarti Google menemukan URL tetapi belum meng-crawl-nya. Begitulah bantuan laporan Pengindeksan halaman Google menjelaskannya. Biasanya Google berencana meng-crawl lalu menundanya agar situs Anda tidak kelebihan beban, sehingga tanggal crawl terakhir kosong di laporan.
Ini adalah status prioritas crawling, bukan vonis atas konten Anda, karena Google belum membaca halamannya. Di bawah ini Anda akan melihat perbedaannya dari «Di-crawl», temuan kami saat memeriksa situs sendiri, dan daftar perbaikan yang diurutkan menurut ukuran situs. Baru mulai memakai laporan ini? Mulailah dari panduan Google Search Console ini.
Arti «Ditemukan - saat ini tidak diindeks»
Google membawa sebuah URL melewati empat langkah: menemukan, meng-crawl, mengindeks lalu dapat menampilkannya di hasil. Dua status Search Console menggambarkan URL yang tersangkut di tengah jalan.
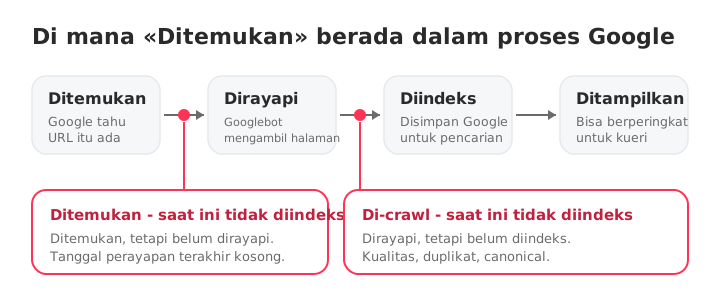
Sebuah URL sampai ke «ditemukan» lewat sitemap atau tautan dari halaman lain. Setelah itu Google memutuskan kapan meng-crawl-nya. «Ditemukan» berarti keputusan itu belum diambil.
Perbedaannya dengan «Di-crawl - saat ini tidak diindeks»
Kedua status ini tampak mirip dan membutuhkan perbaikan yang berbeda.
| Ditemukan - saat ini tidak diindeks | Di-crawl - saat ini tidak diindeks | |
|---|---|---|
| Sudah di-crawl Google? | Belum | Sudah |
| Tanggal crawl terakhir | Kosong | Ada tanggal |
| Google sudah membaca halaman? | Belum | Sudah |
| Alasan umum | Crawl ditunda atau prioritas rendah | Google membaca halaman lalu melewatinya |
| Periksa lebih dulu | Tautan internal, sitemap, kapasitas crawl | Kualitas konten, duplikat, canonical |
Diagnosis lengkap untuk status kedua ada di panduan Di-crawl - saat ini tidak diindeks.
Seperti apa daftarnya di situs nyata
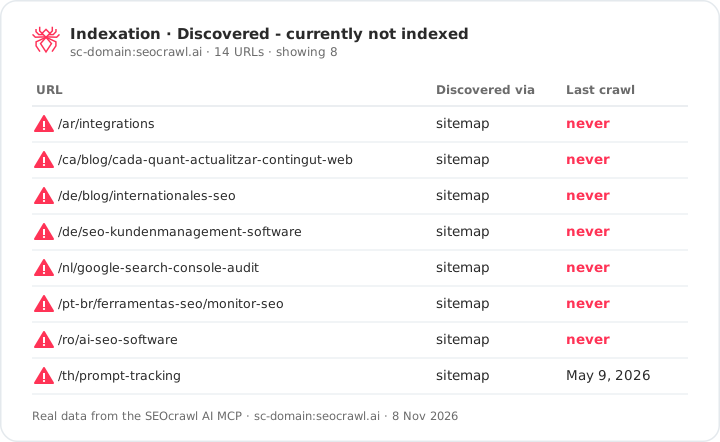
Kami memeriksa seocrawl.ai di laporan Pengindeksan SEOcrawl. Dari 1.000 URL yang dipantau SEOcrawl (sitemap kami menyatakan 6.310), 823 sudah diindeks, atau 82,3%. 128 berada di «Di-crawl - saat ini tidak diindeks» dan 14 di «Ditemukan - saat ini tidak diindeks».
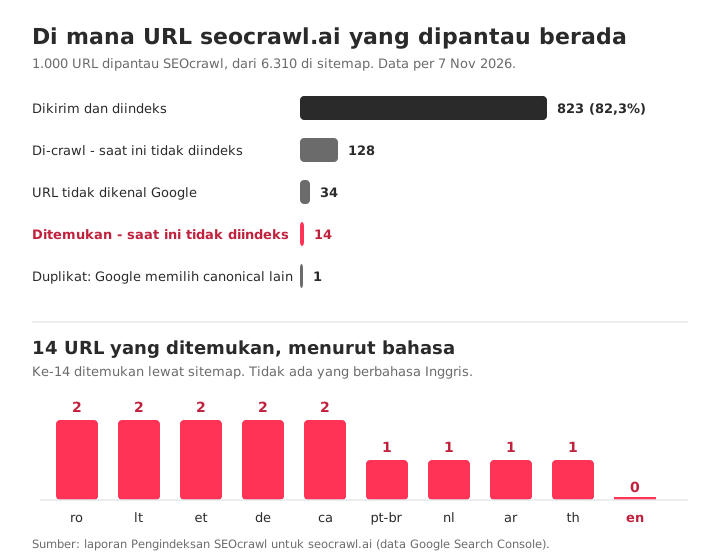
Kesamaan ke-14 URL itulah bagian yang berguna:
- Semuanya halaman terjemahan: Arab, Katalan, Jerman, Estonia, Lituania, Belanda, Portugis (Brasil), Rumania, dan Thai. Tidak ada yang berbahasa Inggris.
- Google menemukan ke-14-nya lewat sitemap, bukan lewat tautan dari halaman lain.
- Satu di antaranya menunjukkan tanggal crawl sebelumnya (9 Mei 2026), jadi status ini menggambarkan posisi URL saat ini, bukan bahwa Google tidak pernah mengunjunginya.
Ini pola yang perlu diperiksa, bukan diagnosis. Halaman yang ada dalam 26 bahasa dan terutama dijangkau lewat sitemap adalah kandidat alami untuk tautan internal yang lemah, jadi tautan internal adalah hal pertama yang dilihat. Pelajarannya berlaku untuk situs mana pun: jangan membaca daftar URL demi URL. Setelah dikelompokkan menurut bahasa, 14 URL menjadi satu pertanyaan.
Angka-angka ini mencakup 1.000 URL yang dipantau SEOcrawl, yaitu sampel dari seluruh sitemap. Kelompok yang lebih besar, 128 URL, adalah status lainnya dan punya panduan tersendiri.
Mengapa Google menunda crawl
Panduan crawl budget Google menjelaskan cara Google memutuskan seberapa banyak yang di-crawl: batas kapasitas yang sanggup ditangani server Anda dan permintaan terhadap URL Anda. Sebagian besar URL yang ditemukan bisa dilacak ke salah satu dari lima penyebab ini.
- Kapasitas crawl. Google menyatakan batasnya turun ketika situs Anda melambat atau mengembalikan error server. Server lambat berarti lebih sedikit crawl.
- Permintaan crawl rendah. Permintaan bergantung pada ukuran situs, seberapa sering diperbarui, serta kualitas dan relevansi halaman. URL dengan sedikit tautan internal, atau tanpa tautan sama sekali, memberi Google sedikit alasan untuk segera kembali.
- Crawl yang terbuang. URL duplikat, parameter, facet, rantai redirect yang panjang, dan soft 404 bersaing dengan halaman asli Anda. Google mencatat bahwa soft 404 terus di-crawl dan membuang budget, dan halaman ber-noindex tetap diminta sebelum dilepas.
- Hanya ditemukan lewat sitemap. Sitemap memberi tahu Google bahwa sebuah URL ada. Itu tidak menjadikannya prioritas, dan Google memperlakukan sitemap sebagai petunjuk. Halaman yang hanya ditemukan di sana adalah yang pertama menunggu.
- Situs atau bagian baru. Setiap situs mulai dengan batas kapasitas bawaan yang sama dan konservatif, yang tumbuh seiring situs terbukti sehat.
Crawl budget itu sendiri hanya layak mendapat perhatian pada situs yang sangat besar. Perkiraan kasar Google: 1.000.000+ halaman unik yang diperbarui kira-kira mingguan, atau 10.000+ halaman yang berubah setiap hari. Pada situs yang lebih kecil, penyebab 2 dan 4 jauh lebih umum.
Apakah ini masalah? Tiga pertanyaan sebelum memperbaiki apa pun
- Apakah URL ini memang seharusnya diindeks? Jika berupa tampilan terfilter, halaman pencarian internal, atau URL uji, wajar bila tidak ada. Untuk menegaskannya, terapkan noindex atau kembalikan 404 atau 410 (lihat Excluded by 'noindex' tag).
- Berapa banyak URL, dengan pola apa? Google menyatakan bahwa dengan kurang dari 500 halaman, Anda mungkin tidak memerlukan laporan ini. Daftarnya juga dibatasi 1.000 baris, jadi di situs besar itu hanyalah sampel.
- Apakah URL-nya baru? URL yang terbit minggu lalu belum menjadi masalah. Rentang waktu dari Google sendiri ada di tabel di bawah.
Cara memperbaikinya menurut ukuran situs
Langkah pertama yang tepat bergantung pada ukuran situs Anda, jadi mulailah dari kolom yang sesuai.
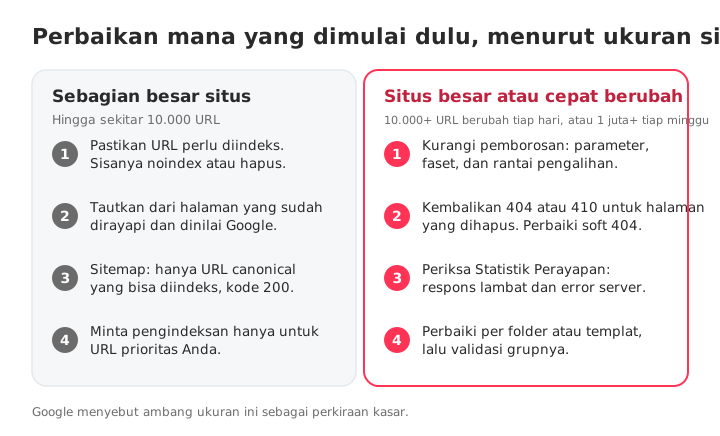
Sebagian besar situs: hingga sekitar 10.000 URL
- Pastikan URL layak diindeks. Jika tidak, terapkan noindex atau hapus lalu coret dari daftar Anda.
- Tautkan dari halaman yang sudah di-crawl Google. Tambahkan tautan kontekstual dengan anchor text deskriptif dari halaman terindeks yang mendapat trafik. Crawler mana pun dapat menampilkan halaman yatim Anda dengan memfilter halaman yang tanpa tautan internal, dan panduan tautan internal ini memuat metode lengkapnya.
- Jaga sitemap tetap bersih. Sertakan hanya URL yang mengembalikan 200, dapat diindeks, dan merupakan versi canonical, dengan
lastmodyang akurat. Google mengabaikan priority dan changefreq. Jika Anda butuh berkasnya lebih dulu, temukan sitemap Anda. Jika Search Console menyatakan tidak menemukan satu pun, lihat No referring sitemaps detected. - Minta pengindeksan untuk beberapa URL prioritas. Buka alat Inspeksi URL dan klik Minta pengindeksan. Google menerapkan kuota dan menyatakan permintaan berulang tidak mempercepat apa pun, jadi simpan untuk halaman yang paling penting.
Situs besar atau yang berubah cepat: 10.000+ URL berubah per hari atau 1 juta+ per minggu
- Kurangi crawl yang terbuang. Blokir di robots.txt ruang URL yang tidak bernilai bagi pencarian (parameter, facet, pencarian internal) dan konsolidasikan duplikat dengan canonical serta redirect 301. Jangan mengandalkan noindex untuk menghemat budget: Google terus meminta halaman-halaman itu.
- Kembalikan 404 atau 410 untuk halaman yang dihapus dan perbaiki soft 404. Google menyebut 404 sebagai sinyal kuat untuk tidak meng-crawl URL lagi, sedangkan URL yang diblokir bertahan lebih lama dalam antrean. Persingkat setiap rantai redirect yang panjang.
- Periksa statistik crawl. Di Setelan, laporan Statistik crawl menampilkan waktu respons dan error server. Jika tinggi, Google menurunkan batas kapasitas Anda, dan tak ada perbaikan konten yang membantu sampai server membaik.
- Perbaiki per folder atau template, lalu validasi kelompoknya. Ambil satu keputusan per pola, buat sitemap khusus berisi URL yang sudah diperbaiki, dan klik Validasi perbaikan. Baca lebih lanjut tentang crawl budget jika situs Anda masuk kategori ini.
Menunggu atau bertindak?
Bagian tersulit bukan perbaikannya, melainkan mengetahui kapan harus berhenti menunggu. Gunakan rentang waktu dari Google sendiri dan tren Anda sendiri.
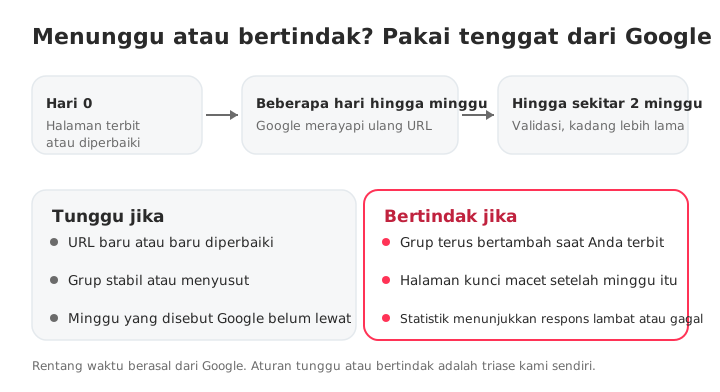
| Yang Anda lakukan | Kata Google | Sumber |
|---|---|---|
| Meminta Google meng-crawl ulang | Beberapa hari hingga beberapa minggu | Meminta Google meng-crawl ulang |
| Meminta pengindeksan | Biasanya sekitar sehari, hingga satu atau dua minggu, dengan kuota harian | Bantuan Inspeksi URL |
| Memvalidasi perbaikan | Hingga sekitar dua minggu, kadang jauh lebih lama | Bantuan Pengindeksan halaman |
Rentang waktunya dari Google. Aturan menunggu atau bertindak adalah milik kami: tunggu selama URL masih baru dan kelompoknya stabil atau menyusut, dan bertindaklah ketika kelompok terus bertambah atau halaman penting Anda tetap tersangkut setelah minggu-minggu itu.
Cara memantau dari waktu ke waktu
Search Console menampilkan kondisi terbaru setiap URL dan daftar yang dibatasi 1.000 baris, jadi bangun rutinitas Anda sendiri:
- Ekspor daftar sebulan sekali dan bandingkan dengan yang sebelumnya. Apakah kelompoknya bertambah, stabil, atau menyusut?
- Kelompokkan menurut pola (bahasa, folder, template) sebelum melihat URL satu per satu.
- Lihat bagaimana Google menemukan setiap URL. Daftar yang semuanya «sitemap» dan tak ada «halaman perujuk», seperti pada 14 URL kami, langsung menunjuk ke tautan internal.
Tampilan Pengindeksan di SEOcrawl AI menyajikan daftar itu siap pakai: filter menurut status cakupan untuk melihat URL di dalamnya, beserta tanggal crawl terakhir, klik, dan tayangan. Lewat MCP, setiap URL juga datang dengan canonical pilihan Google dibanding yang dideklarasikan dan apakah ditemukan lewat sitemap atau halaman perujuk. Crawler mengaudit halaman Anda sendiri, sehingga Anda bisa melihat apa yang lemah pada sebuah URL sebelum meminta Google melihatnya lagi, dan SEO Monitor memperingatkan ketika halaman penting mendapat noindex, mengganti canonical, mengembalikan 404, atau hilang dari sitemap.
Berikut daftar itu untuk situs kami sendiri, langsung dari tampilan Pengindeksan:
Anda juga bisa melewatkan dasbor. Dengan MCP SEOcrawl AI yang terhubung ke Claude atau ChatGPT, tanyakan: «Tampilkan URL yang berstatus Ditemukan - saat ini tidak diindeks dan kelompokkan menurut folder.» Ini panduan langkah demi langkah menghubungkan Search Console ke Claude dan ChatGPT.
Pertanyaan umum
Apa arti «Ditemukan - saat ini tidak diindeks»?
Artinya Google menemukan URL Anda tetapi belum meng-crawl-nya. Biasanya Google berencana meng-crawl lalu menundanya, sehingga tanggal crawl terakhir kosong (bantuan Pengindeksan halaman). Google belum membaca halamannya, jadi status ini tidak mengatakan apa pun tentang kualitasnya. Ini bukan penalti.
Berapa lama «Ditemukan - saat ini tidak diindeks» berlangsung?
Google tidak menerbitkan batas waktu untuk status ini. Google menyatakan crawl ulang yang diminta memakan waktu beberapa hari hingga beberapa minggu, dan validasi perbaikan hingga sekitar dua minggu, kadang jauh lebih lama. URL baru mungkin memang butuh minggu-minggu itu. Jika kelompok terus bertambah seiring Anda menerbitkan, berhentilah menunggu dan bertindaklah.
Apakah meminta pengindeksan memperbaikinya?
Itu bisa membantu untuk beberapa URL prioritas, karena meminta Google memasukkan halaman ke antrean. Itu tidak menghilangkan penyebabnya, jadi halaman bisa kembali ke status yang sama. Permintaan tunduk pada kuota harian, dan Google menyatakan mengirim URL yang sama berulang kali tidak mempercepat apa pun. Gunakan setelah memperbaiki tautan internal, jangan pernah sebagai alat massal.
Apakah ini penalti?
Bukan. Tindakan manual punya laporan tersendiri. Status ini berarti Google menemukan URL dan belum meng-crawl-nya, jadi halaman belum dinilai. Penyebabnya biasanya prioritas crawling: tautan internal yang lemah, server lambat, atau banyak URL bernilai rendah yang bersaing untuk di-crawl.
Mengapa begitu banyak halaman saya ditemukan tetapi tidak diindeks?
Angka tinggi biasanya menunjuk ke sebuah pola, bukan halaman tunggal: parameter URL atau facet, duplikat, sitemap berisi URL yang tidak semestinya ada, tautan internal lemah ke seluruh bagian, atau server yang memperlambat Googlebot. Kelompokkan URL menurut folder, bahasa, atau template sebelum melihat satu per satu.
Apakah saya perlu khawatir di situs kecil?
Biasanya tidak. Google menyatakan jika situs Anda memiliki kurang dari 500 halaman, Anda mungkin tidak memerlukan laporan Pengindeksan halaman. Beberapa URL baru dalam status ini umumnya hanya perlu waktu dan beberapa tautan internal dari halaman yang sudah di-crawl Google.
Bagaimana SEOcrawl AI dapat membantu dengan URL yang ditemukan?
Tampilan Pengindeksan di SEOcrawl AI mendaftar URL yang tersangkut di setiap status cakupan Google, lengkap dengan tanggal crawl terakhir, klik, dan tayangan. Lewat MCP SEOcrawl AI, Anda juga dapat meminta Claude atau ChatGPT menampilkan daftar itu dengan canonical Google dibanding yang dideklarasikan dan apakah Google menemukan setiap URL lewat sitemap atau halaman perujuk, lalu mengelompokkannya per folder.
Lihat lebih banyak SEOcrawl AI di Google
Pilih kami sebagai sumber pilihan agar artikel kami lebih sering muncul di Berita Utama Google.
Penulis: David Kaufmann
Saya telah menghabiskan lebih dari 10 tahun terakhir benar-benar terobsesi dengan SEO — dan jujur saja, saya tidak mau menukarnya dengan apa pun.
Karier saya mencapai level baru ketika saya bekerja sebagai senior SEO specialist untuk Chess.com — salah satu dari 100 website paling banyak dikunjungi di seluruh internet. Bekerja di skala seperti itu, di jutaan halaman, puluhan bahasa, dan di salah satu SERPs paling kompetitif yang ada, mengajari saya hal-hal yang tidak akan pernah bisa diberikan oleh kursus atau sertifikasi mana pun. Pengalaman itu mengubah cara pandang saya tentang seperti apa SEO yang benar-benar hebat — dan menjadi fondasi bagi semua yang saya bangun setelahnya.
Dari pengalaman itu, saya mendirikan SEO Alive — sebuah agency untuk brand yang serius menggarap pertumbuhan organik. Kami tidak di sini untuk menjual dashboards dan laporan bulanan. Kami di sini untuk membangun strategi yang benar-benar menggerakkan hasil, menggabungkan yang terbaik dari SEO klasik dengan dunia baru yang menarik dari Generative Engine Optimization (GEO) — memastikan brand Anda tidak hanya muncul di tautan biru Google, tetapi juga di dalam jawaban yang dihasilkan AI yang dikirimkan ChatGPT, Perplexity, dan Google AI Overviews kepada jutaan orang setiap harinya.
Dan karena saya tidak bisa menemukan tool yang menangani kedua dunia itu dengan benar, saya membangunnya sendiri — SEOcrawl AI, sebuah platform enterprise SEO intelligence yang menyatukan rankings, audit teknis, pemantauan backlinks, kesehatan crawl, dan pelacakan visibilitas brand di AI dalam satu tempat. Inilah platform yang selalu saya harap pernah ada.
Temukan lebih banyak konten dari penulis ini
Kami mengukur klik Google dan trafik rujukan AI di lebih dari 16.000 website dan 15 industri. Trafik AI naik 45% dalam setahun, tetapi masih setara sekitar 1 kunjungan untuk setiap 100 kunjungan dari Google, sementara klik Google turun 15%.

Sampai 30 November, tahun pertama paket tahunan SEOcrawl AI mana pun setengah harga dengan kode BLACKFRIDAY2026. Apa yang Anda dapatkan, apa yang dicakup prompt di setiap paket, dan cara melihat dalam 15 menit di mana ChatGPT, Gemini, Claude, dan Perplexity menyebut Anda.