Dikecualikan oleh tag 'noindex': Artinya dan Cara Memperbaikinya
Anda membuka Google Search Console, melihat sejumlah URL berlabel "Dikecualikan oleh tag 'noindex'," dan kini halaman-halaman tersebut tidak terlihat di penelusuran.
Jika Anda menemukan sejumlah URL berlabel "Dikecualikan oleh tag 'noindex'" di Google Search Console, halaman Anda sengaja dijauhkan dari indeks Google, dan solusinya biasanya lebih sederhana dari kelihatannya: temukan direktifnya, hapus, lalu minta Google meng-crawl ulang.
Panduan ini menjelaskan secara rinci apa yang memicu status ini, cara menemukan direktif noindex penyebabnya, serta langkah-langkah tepat untuk menghapusnya di semua CMS utama agar halaman Anda bisa kembali mendapat peringkat. Pengecekan yang sama berjalan otomatis di Crawler SEOcrawl AI, yang menandai direktif noindex di seluruh situs Anda tanpa perlu mengecek URL satu per satu.
Apa arti "Dikecualikan oleh tag 'noindex'" di Google Search Console?
Status "Dikecualikan oleh tag 'noindex'" berarti Googlebot meng-crawl halaman Anda, menemukan direktif noindex, dan mematuhinya dengan tidak memasukkan halaman tersebut ke indeks Google. Halaman Anda tidak akan muncul di hasil penelusuran selama direktif itu masih ada.
Di mana status ini muncul di GSC
Di laporan Cakupan versi lama (digantikan laporan Pengindeksan halaman pada 2022), status ini muncul di bagian "Dikecualikan". Di laporan Pengindeksan halaman saat ini (Pengindeksan › Halaman), Anda akan menemukannya di bagian "Tidak diindeks", pada tabel "Alasan halaman tidak diindeks", dengan alasan "Dikecualikan oleh tag 'noindex'". Google mengelompokkan semua URL yang terdampak di bawah label ini agar Anda bisa mengekspor dan meninjaunya sekaligus.
Cara Google menemukan dan mematuhi direktif noindex
Dokumentasi Google tentang memblokir pengindeksan dengan noindex menjelaskan dua cara penerapannya: tag <meta name="robots" content="noindex"> di bagian HTML <head> halaman, atau direktif X-Robots-Tag: noindex di header respons HTTP. Saat Googlebot menemukan salah satunya, Googlebot menghapus halaman dari indeks sepenuhnya, bahkan jika halaman itu sebelumnya sudah terindeks. Untuk dasar-dasar tag ini, lihat panduan kami tentang meta tag noindex.
Apakah ini selalu masalah? Saat pengecualian memang disengaja
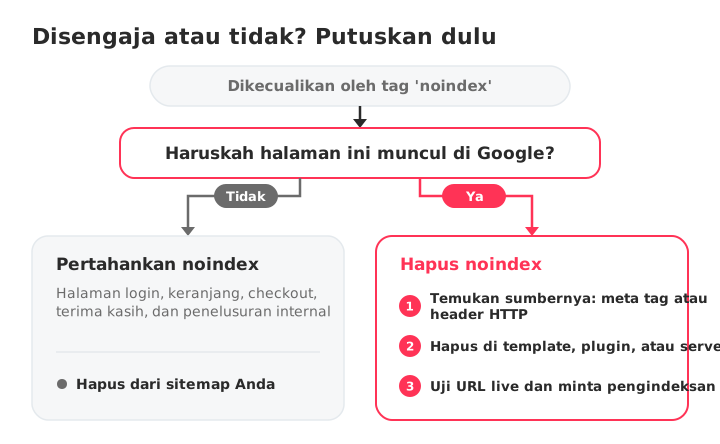
Tidak semua URL berstatus "Dikecualikan oleh tag 'noindex'" adalah error. Halaman admin, layar login, alur keranjang dan checkout, halaman terima kasih, serta hasil penelusuran internal memang sengaja dijauhkan dari indeks Google. Jika halaman-halaman tersebut menampilkan status ini, sistem bekerja sesuai rancangan. Masalah sebenarnya muncul ketika halaman yang ingin Anda rankingkan mendapat label ini.
Penyebab umum status "Dikecualikan oleh tag 'noindex'"
Direktif noindex bisa sampai ke halaman Anda melalui beberapa jalur berbeda. Mengetahui jalur mana yang aktif di situs Anda menentukan cara memperbaikinya.
Meta tag robots dengan "noindex" di <head>
Sumber yang paling umum. Baris seperti <meta name="robots" content="noindex"> di HTML halaman Anda memberi tahu Googlebot agar tidak mengindeksnya. Baris ini bisa ditulis langsung di template atau disisipkan secara dinamis oleh CMS, plugin, atau fungsi tema.
X-Robots-Tag di header respons HTTP
X-Robots-Tag bekerja persis seperti meta tag, tetapi berada di header respons HTTP, bukan di HTML. Konfigurasi server, aturan CDN, atau direktif .htaccess bisa menambahkannya. Contohnya:
Header set X-Robots-Tag "noindex"
Ini memengaruhi setiap file yang cocok dengan aturan tersebut, termasuk PDF dan gambar yang tidak memiliki bagian HTML <head>. Banyak pemilik situs sama sekali melewatkan jalur ini karena direktifnya tidak terlihat di sumber halaman.
Pengaturan CMS yang tidak sengaja memblokir pengindeksan
WordPress memiliki kotak centang di Pengaturan › Membaca bernama "Minta mesin pencari untuk tidak mengindeks situs ini". Saat dicentang, WordPress menambahkan tag robots noindex ke setiap halaman situs. Banyak pemilik situs mengaktifkannya selama pengembangan lalu lupa menonaktifkannya setelah peluncuran.
Shopify bisa menerapkan noindex melalui kode tema atau aplikasi. Beberapa halaman akun dan halaman sistem memang dijauhkan dari indeks oleh Shopify sendiri, dan itu benar, tetapi perubahan tema atau aplikasi SEO bisa tidak sengaja menambahkan noindex ke halaman produk, koleksi, atau blog.
Wix menerapkan noindex pada halaman mana pun yang pengaturan SEO-nya melarang mesin pencari mengindeksnya. Pemicu yang umum adalah menduplikasi halaman dan tanpa sadar mewarisi pengaturan noindex dari halaman aslinya.
Konflik plugin atau tema yang menambahkan noindex
Plugin SEO memungkinkan Anda mengatur noindex per pos, halaman, atau jenis konten. Aturan global yang salah konfigurasi, pembaruan plugin yang mereset pengaturan, atau tema yang menimpa direktif plugin bisa menyebarkan noindex ke puluhan halaman sekaligus. Jika Anda baru saja memperbarui plugin atau mengganti tema, periksa hal ini lebih dulu.
Pengaturan lingkungan staging yang terbawa ke produksi
Sumber tag noindex tidak sengaja yang ternyata cukup sering terjadi. Situs staging Anda memakai noindex agar tidak masuk Google. Saat pipeline build membawa konfigurasi staging ke produksi, direktif noindex ikut terbawa. Biasanya ini memengaruhi seluruh bagian situs sekaligus dan menjadi salah satu penyebab tersulit untuk didiagnosis jika Anda hanya mengecek halaman satu per satu.
Cara mendiagnosis halaman mana yang terdampak
Alur diagnosis yang bisa diulang akan menangkap semua URL yang terdampak tanpa perlu menebak. Mulailah dari Search Console untuk mendapatkan daftarnya, lalu telusuri halaman satu per satu untuk menemukan sumbernya.
Menggunakan laporan Pengindeksan halaman untuk mengekspor URL yang terdampak
Buka Google Search Console dan masuk ke Pengindeksan › Halaman. Klik "Dikecualikan oleh tag 'noindex'" di tabel "Alasan halaman tidak diindeks". Search Console menampilkan contoh URL yang terdampak; gunakan tombol Ekspor untuk mengunduh daftarnya agar bisa diolah.
Memeriksa satu URL dengan alat Inspeksi URL
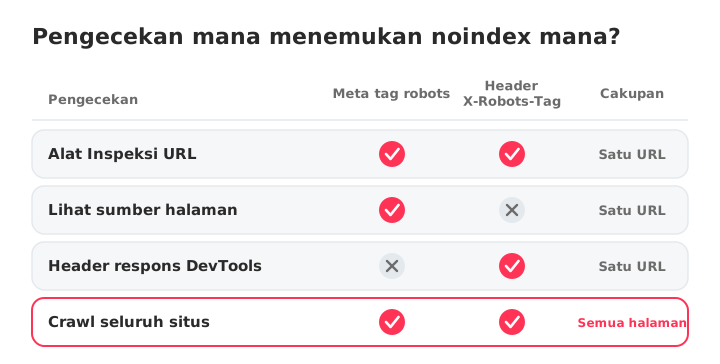
Tempelkan URL mana pun ke kolom penelusuran di bagian atas Search Console. Alat Inspeksi URL menunjukkan apakah Google melihat direktif noindex dan di mana menemukannya: di bagian "Pengindeksan diizinkan?" alat ini melaporkan apakah noindex berasal dari meta tag robots atau header HTTP X-Robots-Tag. Klik Lihat halaman yang di-crawl untuk melihat HTML persis yang diterima Googlebot. Ini adalah pengecekan satu halaman tercepat yang tersedia.
Mengecek sumber halaman untuk meta tag noindex
Buka halaman di browser, klik kanan lalu pilih Lihat sumber halaman, kemudian cari "noindex" (Ctrl+F atau Cmd+F). Jika Anda menemukan <meta name="robots" content="noindex"> atau yang serupa, meta tag itulah penyebabnya. Jika tidak ditemukan di sumber, direktif kemungkinan berasal dari header HTTP.
Menggunakan DevTools browser untuk mengecek header HTTP
Buka DevTools (F12, atau klik kanan › Inspect), masuk ke tab Network, muat ulang halaman, lalu klik permintaan dokumen utama. Cari X-Robots-Tag: noindex di bagian Response Headers. Inilah satu-satunya cara di dalam browser untuk menangkap direktif noindex berbasis header yang tidak muncul di HTML.
Meng-crawl situs Anda dengan Screaming Frog atau SEOcrawl AI
Untuk diagnosis di seluruh situs, crawler menangkap setiap halaman yang terdampak dalam sekali jalan. Screaming Frog SEO Spider bisa memfilter halaman berdasarkan indexability dari meta tag maupun header. Crawler SEOcrawl AI meng-crawl setiap halaman, menandai setiap halaman yang memiliki direktif noindex di bagian Indexability, dan memberikan Audit Health Score, sehingga Anda melihat cakupan lengkapnya tanpa perlu mengekspor dan memfilter secara manual.
Cara memperbaiki "Dikecualikan oleh tag 'noindex'": langkah demi langkah
Inilah bagian yang paling praktis. Ikuti perbaikan yang sesuai dengan hasil diagnosis Anda dari bagian sebelumnya.
Menghapus meta tag noindex dari sumber halaman
Edit template atau konten halaman untuk menghapus <meta name="robots" content="noindex"> dari HTML <head>. Di situs yang dibangun khusus, periksa langsung file template-nya. Jika tag disisipkan oleh JavaScript, temukan skrip yang bertanggung jawab lalu hapus atau beri kondisi.
Sebelum:
<meta name="robots" content="noindex">
Sesudah:
<meta name="robots" content="index, follow">
Atau cukup hapus tag tersebut sepenuhnya. Google menganggap tidak adanya direktif noindex sebagai "pengindeksan diizinkan".
Memperbaiki X-Robots-Tag di konfigurasi server atau CDN
Periksa .htaccess (Apache), nginx.conf (Nginx), atau aturan CDN Anda untuk direktif X-Robots-Tag: noindex. Hapus direktif tersebut, atau batasi hanya pada path tertentu yang memang harus dikecualikan, bukan pada halaman yang ingin Anda indeks. Misalnya, Anda bisa mempertahankan noindex di /staging/ sambil menghapusnya dari /blog/.
Cara memperbaiki di WordPress
Dua pengecekan, secara berurutan:
- Pengaturan untuk seluruh situs: buka Pengaturan › Membaca dan hapus centang "Minta mesin pencari untuk tidak mengindeks situs ini". Ini adalah penyebab paling umum masalah noindex di seluruh situs WordPress.
- Pengaturan per halaman di plugin SEO:
- Yoast SEO: buka pos atau halaman, gulir ke kotak meta Yoast, klik tab Advanced, lalu atur "Allow search engines to show this content in search results?" menjadi "Yes".
- Rank Math: buka pos, masuk ke kotak meta Rank Math, klik tab Advanced, lalu atur "Robots Meta" menjadi "Index".
- All in One SEO: edit pos, buka tab Advanced di pengaturan AIOSEO, dan pastikan "No Index" tidak dicentang di pengaturan robots.
Periksa juga pengaturan global setiap plugin untuk jenis konten utuh (tag, kategori, custom post type) yang diatur ke noindex. Untuk pengaturan WordPress lainnya, lihat panduan kami tentang menghubungkan WordPress ke Google Search Console.
Cara memperbaiki di Shopify
Di Shopify, noindex biasanya berasal dari kode tema atau aplikasi. Buka Toko Online › Tema › Edit kode lalu cari di theme.liquid dan template halaman meta tag robots yang berisi noindex. Kemudian periksa aplikasi SEO Anda untuk aturan yang menyembunyikan produk, koleksi, atau pos blog, serta produk atau halaman apa pun yang memakai metafield seo.hidden. Halaman akun dan halaman sistem lainnya dijauhkan dari indeks oleh Shopify dan memang sebaiknya tetap begitu.
Cara memperbaiki di Wix, Squarespace, dan website builder lainnya
Wix: buka pengaturan SEO halaman (dari menu halaman) lalu aktifkan "Let search engines index this page". Jika Anda menduplikasi halaman, salinannya mungkin mewarisi pengaturan noindex dari halaman aslinya.
Squarespace: periksa pengaturan SEO untuk seluruh situs, apakah ada opsi yang menyembunyikan situs dari mesin pencari. Untuk halaman individual, buka pengaturan halaman dan cari "Hide page from search results" di tab SEO. Squarespace juga secara default menjauhkan beberapa halaman sistem, seperti keranjang, dari hasil penelusuran.
Setelah perbaikan: meminta pengindeksan ulang di Google Search Console
Menghapus tag noindex memberi tahu Google bahwa halaman boleh diindeks, tetapi Anda tetap perlu Googlebot meng-crawl ulang halaman tersebut untuk mengonfirmasi perubahannya.
Menggunakan alat Inspeksi URL untuk meminta pengindeksan
Tempelkan URL yang sudah diperbaiki ke kolom penelusuran Search Console. Klik Uji URL live untuk memastikan pengindeksan kini diizinkan, lalu klik Minta pengindeksan. Google akan memasukkan URL ke antrean crawl ulang. Anda bisa mengirim beberapa URL dengan cara ini, tetapi Search Console membatasi jumlah permintaan per hari.
Berapa lama Google mengindeks ulang sebuah halaman?
Biasanya beberapa hari hingga beberapa minggu, tergantung seberapa sering Googlebot meng-crawl situs Anda. Situs bertrafik tinggi yang sering diperbarui di-crawl ulang lebih cepat; situs baru atau bertrafik rendah bisa menunggu berminggu-minggu. Meminta pengindeksan adalah sinyal tercepat yang bisa Anda kirim, tetapi bukan jaminan: langkah ini memasukkan URL Anda ke antrean crawl, bukan memaksa crawl ulang seketika.
Mengirimkan sitemap XML yang diperbarui untuk mempercepat crawling
Jika Anda memperbaiki banyak halaman sekaligus, kirimkan sitemap XML yang telah diperbarui di bagian Peta situs Search Console. Ini memberi sinyal bahwa situs Anda telah berubah dan mendorong crawl ulang yang lebih luas. Sitemap yang bersih tanpa URL ber-noindex juga mencegah sinyal yang bertentangan, yang akan kita bahas berikutnya.
Kapan sebaiknya mempertahankan tag noindex (pengecualian yang disengaja)
Tidak semua tag noindex perlu dihapus. Beberapa halaman memang tidak boleh muncul di hasil penelusuran, dan mengindeksnya hanya menambah halaman tipis atau duplikat ke gambaran Google tentang situs Anda serta membuang perhatian crawl.
Halaman yang tidak boleh diindeks
- Halaman login dan pendaftaran
- Halaman keranjang, checkout, dan konfirmasi pesanan
- Halaman hasil penelusuran internal (untuk mencegah konten duplikat)
- Halaman terima kasih (lead magnet, pengiriman formulir)
- Halaman admin dan backend
- Lingkungan staging dan pengembangan
- Halaman filter dan parameter yang menghasilkan URL duplikat
noindex vs. robots.txt: perbedaan utama
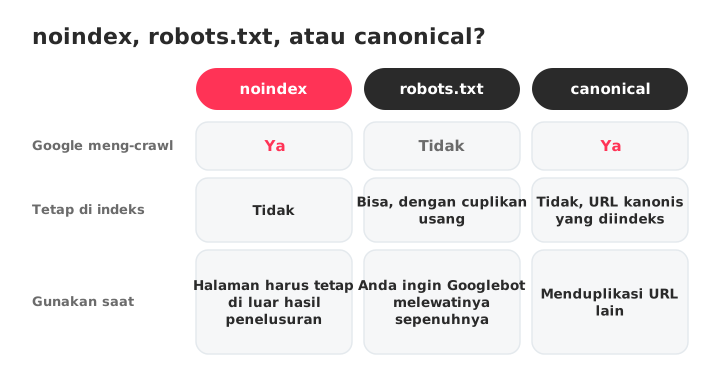
robots.txt memblokir crawling. noindex mengizinkan crawling tetapi memblokir pengindeksan. Jika Anda memblokir halaman di robots.txt, Googlebot tidak pernah membacanya, artinya Googlebot juga tidak pernah melihat tag noindex. Jika Anda ingin halaman keluar dari indeks, gunakan noindex. Jika Anda ingin Googlebot melewati halaman sepenuhnya (untuk menghemat crawl budget), gunakan robots.txt.
Kesalahan yang umum: memakai robots.txt untuk memblokir halaman yang sudah terindeks. Google tidak bisa melihat tag noindex jika tidak bisa meng-crawl halamannya, sehingga URL tersebut bisa tetap berada di indeks dengan judul dan cuplikan yang usang. Pendekatan yang benar adalah mengizinkan crawling dan memakai noindex untuk mengeluarkan halaman dari indeks.
Tag kanonis vs. noindex: memilih direktif yang tepat
Tag kanonis (rel="canonical") memberi tahu Google "halaman ini adalah salinan dari URL lain itu, rankingkan yang itu saja". Tag noindex memberi tahu Google "jangan indeks halaman ini sama sekali". Keduanya punya fungsi berbeda:
- Gunakan canonical jika Anda memiliki konten duplikat atau hampir duplikat dan ingin menyatukan sinyal peringkat ke satu URL.
- Gunakan noindex jika halaman tidak boleh muncul di hasil penelusuran dalam kondisi apa pun.
Menggabungkan keduanya di halaman yang sama mengirimkan sinyal yang bertentangan: yang satu berkata "gabungkan halaman ini ke URL lain", yang lain berkata "buang saja". Pilih salah satu yang sesuai dengan tujuan Anda.
Mencegah tag noindex yang tidak disengaja di masa depan
Memperbaiki masalah noindex secara reaktif memang perlu, tetapi mencegahnya menghemat berjam-jam diagnosis dan trafik yang hilang.
Menyiapkan notifikasi Search Console untuk penurunan pengindeksan
Google Search Console mengirim email kepada pemilik dan pengguna terverifikasi saat mendeteksi masalah pengindeksan baru di sebuah properti. Pastikan notifikasi email diaktifkan di preferensi email Search Console Anda. Jika jumlah halaman terindeks tiba-tiba turun, notifikasi ini memberi Anda waktu lebih awal sebelum trafik ikut turun.
Menambahkan pengecekan noindex ke checklist QA sebelum peluncuran
Sebelum men-deploy situs atau membawa staging ke produksi, periksa direktif noindex. Pengecekan 30 detik dengan "Lihat sumber halaman" dan pencarian "noindex" sudah menangkap kesalahan deployment yang paling umum. Untuk situs yang lebih besar, lakukan crawl sebelum dan sesudah deployment lalu bandingkan jumlah halaman ber-noindex. Tambahkan ke checklist SEO teknis Anda agar tidak ada yang melewatkannya.
Crawl terjadwal untuk menangkap direktif noindex yang tidak diinginkan
Jalankan crawl penuh secara terjadwal, dan setelah setiap pembaruan plugin, pergantian tema, atau migrasi, untuk menangkap tag noindex liar sebelum merugikan trafik Anda. Crawler SEOcrawl AI memungkinkan Anda membandingkan crawl, sehingga Anda bisa melihat halaman mana yang berubah menjadi noindex dan kapan, dan SEO Monitor memberi tahu Anda begitu salah satu halaman penting mendapat tag noindex.
FAQ
Apa arti "Dikecualikan oleh tag 'noindex'" di Google Search Console?
Artinya Google menemukan dan mematuhi direktif noindex di halaman Anda, sehingga halaman tersebut tidak akan muncul di hasil penelusuran. Status ini muncul di laporan Pengindeksan halaman di Search Console, di bagian "Tidak diindeks".
Ini tidak selalu merupakan error: halaman yang sengaja Anda kecualikan, seperti halaman login atau checkout, memang seharusnya menampilkan status ini.
Bagaimana cara memperbaiki "Dikecualikan oleh tag 'noindex'" di WordPress?
Periksa dua tempat secara berurutan. Pertama, buka Pengaturan › Membaca dan pastikan "Minta mesin pencari untuk tidak mengindeks situs ini" tidak dicentang. Kedua, buka setiap pos atau halaman yang terdampak di plugin SEO Anda (Yoast, Rank Math, All in One SEO) dan pastikan pengaturan robots per halaman mengizinkan pengindeksan.
Berapa lama Google mengindeks halaman setelah noindex dihapus?
Biasanya beberapa hari hingga beberapa minggu, tergantung seberapa sering Googlebot meng-crawl situs Anda. Minta pengindeksan dengan alat Inspeksi URL setelah menghapus direktif, lalu kirimkan sitemap XML yang telah diperbarui untuk mempercepat prosesnya. Situs dengan trafik tinggi di-crawl ulang lebih cepat dibanding situs baru atau bertrafik rendah.
Apakah halaman bisa dikecualikan oleh noindex meskipun ada di sitemap saya?
Bisa. Direktif noindex mengalahkan keberadaan URL di sitemap. Google mungkin tetap meng-crawl URL dari sitemap Anda, tetapi tidak akan mengindeksnya selama noindex masih ada.
Hapus noindex agar halaman bisa diindeks, atau hapus URL dari sitemap jika pengecualiannya memang disengaja. Mencantumkan URL ber-noindex di sitemap mengirimkan sinyal yang bertentangan.
Apa perbedaan antara noindex dan memblokir halaman di robots.txt?
robots.txt mencegah Googlebot meng-crawl halaman; noindex mengizinkan crawling tetapi mencegah pengindeksan. Jika Anda memblokir halaman dengan robots.txt, Google tidak bisa membaca tag noindex, sehingga halaman yang sudah terindeks bisa tetap berada di indeks dengan konten usang. Gunakan noindex untuk mengeluarkan halaman dari indeks, dan robots.txt hanya jika Anda ingin mencegah crawling sepenuhnya.
Bagaimana cara mengecek apakah sebuah halaman memiliki tag noindex?
Ada tiga metode, dari yang tercepat hingga yang paling menyeluruh: gunakan alat Inspeksi URL di Search Console, lihat sumber halaman dan cari "noindex" (Ctrl+F), atau periksa header respons HTTP di DevTools browser Anda (tab Network, cari X-Robots-Tag). Hanya alat Inspeksi URL dan DevTools yang bisa mendeteksi noindex yang dikirim lewat header.
Apakah saya perlu khawatir jika banyak halaman berstatus "Dikecualikan oleh tag 'noindex'"?
Hanya jika halaman-halaman tersebut seharusnya diindeks. Ekspor daftarnya dari Search Console, bandingkan dengan pengecualian yang disengaja (halaman login, keranjang, admin, terima kasih), lalu perbaiki hanya halaman yang seharusnya mendapat peringkat di penelusuran. Jika semua halaman yang terdampak memang sengaja Anda kecualikan, berarti status ini bekerja dengan benar.
Penulis: David Kaufmann

Saya telah menghabiskan lebih dari 10 tahun terakhir benar-benar terobsesi dengan SEO — dan jujur saja, saya tidak mau menukarnya dengan apa pun.
Karier saya mencapai level baru ketika saya bekerja sebagai senior SEO specialist untuk Chess.com — salah satu dari 100 website paling banyak dikunjungi di seluruh internet. Bekerja di skala seperti itu, di jutaan halaman, puluhan bahasa, dan di salah satu SERPs paling kompetitif yang ada, mengajari saya hal-hal yang tidak akan pernah bisa diberikan oleh kursus atau sertifikasi mana pun. Pengalaman itu mengubah cara pandang saya tentang seperti apa SEO yang benar-benar hebat — dan menjadi fondasi bagi semua yang saya bangun setelahnya.
Dari pengalaman itu, saya mendirikan SEO Alive — sebuah agency untuk brand yang serius menggarap pertumbuhan organik. Kami tidak di sini untuk menjual dashboards dan laporan bulanan. Kami di sini untuk membangun strategi yang benar-benar menggerakkan hasil, menggabungkan yang terbaik dari SEO klasik dengan dunia baru yang menarik dari Generative Engine Optimization (GEO) — memastikan brand Anda tidak hanya muncul di tautan biru Google, tetapi juga di dalam jawaban yang dihasilkan AI yang dikirimkan ChatGPT, Perplexity, dan Google AI Overviews kepada jutaan orang setiap harinya.
Dan karena saya tidak bisa menemukan tool yang menangani kedua dunia itu dengan benar, saya membangunnya sendiri — SEOcrawl AI, sebuah platform enterprise SEO intelligence yang menyatukan rankings, audit teknis, pemantauan backlinks, kesehatan crawl, dan pelacakan visibilitas brand di AI dalam satu tempat. Inilah platform yang selalu saya harap pernah ada.
Temukan lebih banyak konten dari penulis ini