Di-crawl - Saat Ini Tidak Diindeks: Artinya dan Cara Memperbaikinya

Google mengunjungi URL Anda, membacanya, lalu tidak memasukkannya ke penelusuran. Berikut cara mengetahui halaman mana yang layak diberi kesempatan kedua, dan cara yang disarankan Google untuk memasukkannya kembali.
Di-crawl - saat ini tidak diindeks berarti Googlebot sudah mengambil halaman Anda dan memutuskan untuk tidak menambahkannya ke indeks Google, sehingga halaman itu tidak bisa muncul di penelusuran. Bantuan laporan Pengindeksan halaman dari Google menjelaskannya begini: halaman sudah di-crawl tetapi tidak diindeks, dan halaman itu “mungkin diindeks atau mungkin tidak diindeks di masa mendatang”.
Penyebabnya biasanya halaman itu sendiri, bukan pemblokiran teknis. Di bawah ini, Anda akan melihat cara memutuskan, URL demi URL, apakah setiap halaman perlu diperbaiki, diberi noindex, atau dihapus, serta berapa lama perbaikan memakan waktu menurut Google. Baru mengenal laporan ini? Mulailah dengan panduan Google Search Console ini.
Apa arti “Di-crawl - saat ini tidak diindeks”?
Status ini berarti Google sudah meng-crawl halaman dan memilih untuk tidak mengindeksnya. Tidak ada yang memblokir Googlebot: Google memutuskan untuk tidak menyertakan halaman itu untuk saat ini. Dua perbedaan berikut membantu Anda membaca status ini dengan benar.
Di-crawl vs. diindeks
Crawling adalah proses Googlebot mengunduh halaman. Pengindeksan adalah proses Google menyimpan halaman itu agar bisa muncul di penelusuran. Sebuah halaman bisa di-crawl berkali-kali dan tetap tidak pernah diindeks.
Bantuan alat Inspeksi URL menyatakan bahwa kualitas halaman harus “cukup tinggi untuk layak diindeks”, dan pengujian live-nya sama sekali tidak bisa memeriksa status ini.
Perbedaannya dengan “Ditemukan - saat ini tidak diindeks”
Ditemukan - saat ini tidak diindeks terjadi satu langkah lebih awal: Google menemukan URL tersebut tetapi menunda crawl agar situs Anda tidak kelebihan beban, sehingga tanggal crawl terakhir kosong.
| Ditemukan - saat ini tidak diindeks | Di-crawl - saat ini tidak diindeks | |
|---|---|---|
| Di-crawl oleh Google? | Tidak | Ya |
| Tanggal crawl terakhir | Kosong | Ada tanggal |
| Alasan umum | Crawl ditunda agar situs tidak kelebihan beban | Google membaca halaman dan melewatinya |
| Periksa lebih dulu | Kapasitas crawl, di situs yang sangat besar | Kualitas konten, duplikat, kanonis |
Google juga menyatakan bahwa “Tidak diindeks belum tentu buruk.” Halaman ber-noindex, URL yang diblokir di robots.txt, duplikat, dan halaman 404 tanpa pengganti memang seharusnya tidak masuk indeks.
Mengapa Google meng-crawl halaman tanpa mengindeksnya
Pengindeksan punya standar kualitas yang tidak dimiliki crawling. Panduan anggaran crawl Google menyatakan bahwa permintaan crawl meningkat seiring nilai dan keunikan konten Anda.
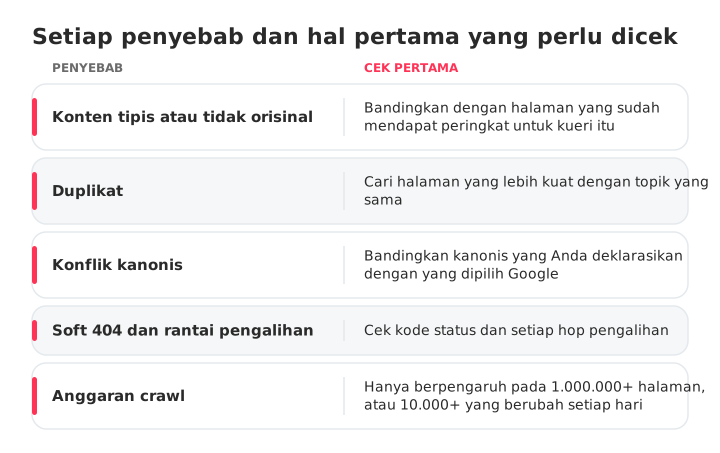
Sebagian besar URL yang terdampak masuk ke salah satu penyebab berikut, masing-masing dengan pemeriksaan pertamanya:
- Konten tipis atau tidak orisinal: halaman mengulang apa yang sudah mendapat peringkat.
- Duplikat: arsip tag, URL hasil pengurutan, dua artikel dengan topik yang sama. Berikut cara menemukan dan mengatasi kanibalisasi kata kunci.
- Konflik kanonis: bandingkan kanonis yang Anda deklarasikan dengan kanonis yang dipilih Google. Saat Google memilih URL lain, halaman biasanya berpindah ke Halaman alternatif dengan tag kanonis yang tepat atau status duplikat.
- Soft 404 dan rantai pengalihan: Google menyatakan bahwa soft 404 membuang-buang anggaran crawl.
- Anggaran crawl: berpengaruh pada situs dengan lebih dari 1.000.000 halaman yang berubah setiap minggu atau lebih dari 10.000 halaman yang berubah setiap hari. Bagi sebagian besar situs, ini bukan penyebabnya.
Standar ini naik dalam dua tahap yang tanggalnya jelas. Pada 18 Agustus 2022, Google mengumumkan helpful content update, sebuah sinyal di seluruh situs, dan menyatakan bahwa menghapus konten yang tidak membantu dapat membantu bagian lain situs. Pada 5 Maret 2024, Google mengumumkan core update untuk menampilkan lebih sedikit konten yang dibuat demi menarik klik, bersama kebijakan spam baru tentang penyalahgunaan konten berskala besar.
Panduan konten yang membantu dari Google menyatakan bahwa E-E-A-T bukan faktor peringkat tertentu, bahwa kepercayaan adalah yang terpenting, dan bahwa tidak ada jumlah kata yang lebih disukai. Menggemukkan halaman tidak akan memperbaikinya.
Cara menemukan dan mendiagnosis halaman yang terdampak di GSC
Buka laporan Pengindeksan halaman (sebelumnya laporan Cakupan), periksa sampelnya, lalu kelompokkan daftar berdasarkan pola. Google mencatat bahwa situs dengan kurang dari 500 halaman kemungkinan tidak memerlukan laporan ini.
Menemukan URL yang terdampak di laporan Halaman
- Di Google Search Console, buka Pengindeksan › Halaman.
- Di bawah “Alasan halaman tidak diindeks”, klik Di-crawl - saat ini tidak diindeks.
- Klik Ekspor dan unduh daftarnya.
Laporan menampilkan hingga 1.000 contoh URL, belum tentu semuanya, jadi di situs besar hasil ekspornya hanyalah sampel.
Memeriksa halaman dengan alat Inspeksi URL
Periksa lima hingga sepuluh URL hasil ekspor untuk melihat tanggal crawl terakhir dan kanonis yang dipilih Google. Kanonis yang mengarah ke tempat lain berarti Google menganggapnya duplikat; tanggal crawl yang sudah berbulan-bulan lalu menunjukkan bahwa Google jarang kembali.
Menemukan pola di antara ratusan URL
Urutkan hasil ekspor berdasarkan folder, template, dan parameter URL, lalu hitung setiap grup. Misalnya 300 URL terbagi menjadi 180 halaman /tag/, 70 URL ?sort=, dan 50 artikel: itu tiga keputusan, bukan 300.
Perbaiki, noindex, atau hapus: tentukan apa yang layak untuk setiap URL
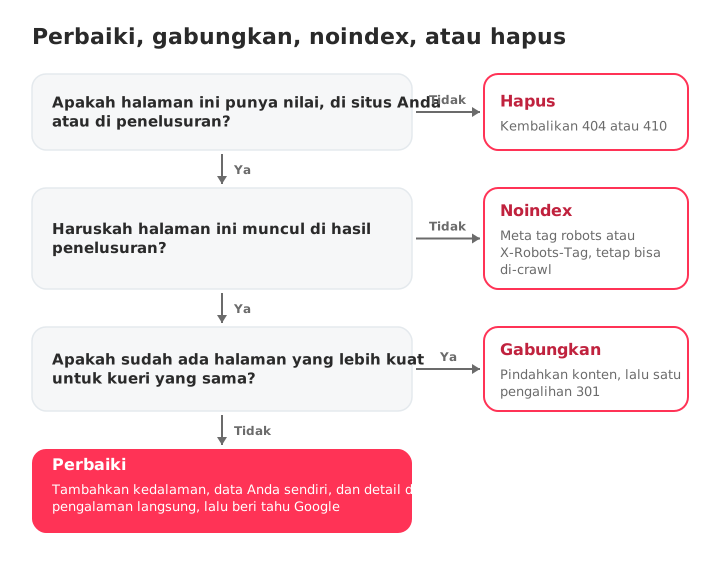
Setiap URL layak mendapat salah satu dari empat hasil. Tanyakan: apakah pengguna penelusuran akan senang mendarat di sini, dan apakah ini satu-satunya halaman di situs Anda yang menjawab kueri tersebut?
| Jenis halaman | Contoh | Keputusan | Caranya |
|---|---|---|---|
| Berguna dan unik, tetapi tipis | Panduan 300 kata tentang topik yang Anda kuasai | Perbaiki | Tambahkan kedalaman dan detail dari pengalaman langsung |
| Duplikat dari halaman yang lebih kuat | Dua artikel untuk kueri yang sama | Gabungkan | Pindahkan konten, lalu pengalihan 301 |
| Berguna di situs, tidak perlu di penelusuran | Arsip tag, penelusuran internal, halaman terima kasih | Noindex | Meta tag robots atau X-Robots-Tag |
| Tidak bernilai, tanpa pengganti | Promo kedaluwarsa, halaman uji coba | Hapus | Kembalikan 404 atau 410 |
Panduan anggaran crawl Google mendukung dua baris terakhir: kembalikan 404 atau 410 untuk halaman yang dihapus dan gabungkan duplikat. 404 di Search Console adalah hal wajar untuk halaman yang sengaja Anda hapus.
Noindex adalah bagian triase yang paling sering salah:
Jangan seperti ini: tag noindex di halaman /tag/ sementara robots.txt memblokir /tag/. Googlebot tidak bisa mengambil halaman tersebut, sehingga tidak pernah melihat tag-nya.
Seperti ini: /tag/ tetap bisa di-crawl dan memuat noindex sebagai meta tag atau header X-Robots-Tag.
Menurut dokumentasi noindex Google, aturan ini tidak berfungsi di dalam robots.txt, dan pada halaman yang jarang dikunjungi, crawl ulang bisa memakan waktu berbulan-bulan. Setelah tag-nya terbaca, URL tersebut akan berpindah ke Dikecualikan oleh tag 'noindex', dan memang itulah yang Anda inginkan untuk halaman-halaman tersebut.
Cara memperbaiki halaman yang layak diindeks
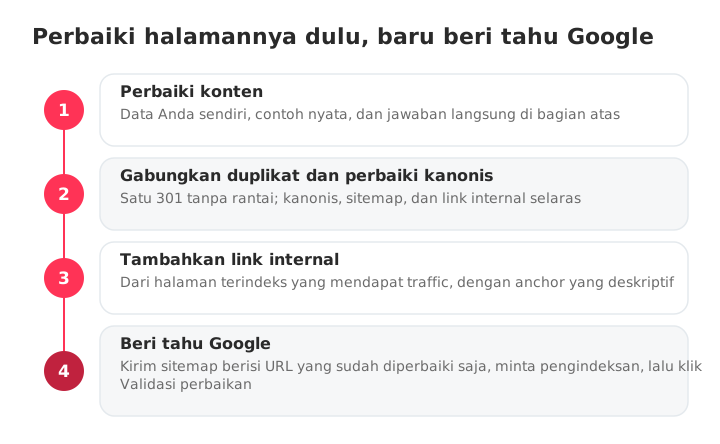
Buat halaman layak diindeks terlebih dahulu, baru beri tahu Google. Meminta pengindeksan untuk halaman yang tidak berubah sama saja meminta Google mengulangi keputusan yang sudah diambilnya. Urutannya:
- Perbaiki konten.
- Gabungkan duplikat dan perbaiki kanonis.
- Tambahkan link internal.
- Kirim sitemap yang terfokus dan minta pengindeksan.
Tingkatkan kedalaman dan orisinalitas konten
Tulis ulang berdasarkan kueri, bukan jumlah kata: tambahkan data Anda sendiri, tangkapan layar, contoh nyata, dan jawaban langsung di dekat bagian atas.
Sebagai contoh, ambil panduan tipis 300 kata: tambahkan dataset hasil pengalaman langsung dan contoh nyata, tautkan dari dua artikel yang sudah mendapat traffic, dan baru setelah itu tambahkan ke sitemap yang terfokus.
Gabungkan duplikat dan perbaiki kanonis
Jika dua URL membahas hal yang sama, pertahankan satu, pindahkan konten yang berguna ke sana, lalu alihkan dengan 301 URL yang lain langsung ke URL tersebut, tanpa rantai. Kemudian pastikan kanonis, sitemap, dan link internal selaras, dan tidak ada noindex yang tertinggal.
Tambahkan link internal dari halaman yang sudah dihargai Google
Tautkan setiap halaman yang sudah diperbaiki dari halaman terindeks yang mendapat traffic, dengan anchor yang deskriptif. Crawler situs apa pun bisa menampilkan daftar halaman yatim (tanpa link internal) dengan memfilter inlink nol. Metode lengkapnya ada di panduan strategi internal link ini.
Periksa juga halaman di ponsel dan di laporan Data Web Inti: halaman seluler yang rusak cepat untuk disingkirkan sebagai penyebab.
Kirim sitemap yang terfokus dan minta pengindeksan
Buat sitemap yang hanya berisi URL yang sudah Anda perbaiki, kirimkan, lalu filter laporan Halaman dengan sitemap itu sebelum mengklik Validasi perbaikan. Google menyarankan cara ini untuk mempercepat validasi. Jika Anda perlu file yang ada terlebih dahulu, temukan sitemap situs Anda.
Google mengabaikan priority dan changefreq, jadi pastikan lastmod tetap akurat. Lalu klik Minta pengindeksan di alat Inspeksi URL untuk URL prioritas Anda: Google menerapkan kuota dan menyatakan bahwa permintaan berulang tidak mempercepat apa pun.
Berapa lama pengindeksan setelah perbaikan?
Perkirakan satu hari hingga beberapa minggu, dan pengindeksan tidak pernah dijamin. Google memberikan rentang yang berbeda di halaman yang berbeda, jadi berikut perbandingannya:
| Yang Anda lakukan | Kata Google | Sumber |
|---|---|---|
| Meminta Google meng-crawl ulang | Beberapa hari hingga beberapa minggu | Meminta Google meng-crawl ulang |
| Minta pengindeksan | Biasanya sekitar satu hari, hingga satu atau dua minggu, dengan batas harian | Bantuan Inspeksi URL |
| Validasi perbaikan | Hingga sekitar dua minggu, terkadang jauh lebih lama | Bantuan Pengindeksan halaman |
Ini adalah linimasa dari Google, bukan kasus pemulihan. Periksa laporan Halaman setiap minggu; jika URL yang sudah diperbaiki belum berubah setelah rentang tersebut lewat, kembali ke kontennya.
Cara mencegah halaman baru masuk ke status ini
Pencegahan adalah rutinitas: periksa setiap halaman sebelum tayang dan tinjau Search Console setiap bulan. Sebelum memublikasikan, pastikan halaman tersebut:
- Menjawab kueri yang tidak dijawab halaman lain di situs Anda.
- Menambahkan data, contoh, atau pengalaman Anda sendiri.
- Memiliki kanonis yang merujuk ke dirinya sendiri dan tidak ada noindex yang tertinggal.
- Ada di sitemap dengan lastmod yang akurat.
- Mencantumkan nama penulis dan, jika relevan, data terstruktur.
- Mendapat link dari halaman terkait yang sudah terindeks.
Sebulan sekali, bandingkan laporan Halaman dengan bulan sebelumnya; sebuah masalah tetap tercantum selama 90 hari setelah kejadian terakhirnya hilang. Situs dengan lebih dari seribu halaman sebaiknya juga memantau laporan Statistik crawling.
SEOcrawl AI menangani sisi teknisnya dalam skala besar. Crawler memindai setiap halaman dan menghasilkan Audit Health Score, dengan masalah yang dikelompokkan berdasarkan Indexability, Crawlability, On-Page, dan lainnya. Tampilan Indexation mengelompokkan URL Anda berdasarkan status cakupan Search Console, sehingga Anda bisa melihat berapa banyak yang berada di “Di-crawl - saat ini tidak diindeks” dan memantau jumlahnya dari waktu ke waktu.
Di antara crawl, SEO Monitor memberi tahu Anda saat halaman penting mendapat noindex, berganti kanonis, mengembalikan 404, atau keluar dari sitemap. Platform yang sama juga memantau visibilitas merek Anda di ChatGPT, Claude, Gemini, Perplexity, dan Copilot, sehingga SEO dan GEO berada di satu tempat.
FAQ
Apa arti “Di-crawl - saat ini tidak diindeks”?
Artinya Googlebot sudah mengambil halaman Anda dan memutuskan untuk tidak menambahkannya ke indeks Google, sehingga halaman itu tidak bisa muncul di penelusuran. Tidak ada yang memblokir crawl: Google membaca halaman tersebut dan memilih untuk tidak menyertakannya untuk saat ini. Ini bukan penalti manual, dan halaman tersebut mungkin diindeks atau mungkin tidak diindeks di masa mendatang.
Apakah sama dengan “Ditemukan - saat ini tidak diindeks”?
Tidak. “Ditemukan” berarti Google mengetahui URL tersebut tetapi menunda crawl, sehingga tanggal crawl terakhir kosong. “Di-crawl” berarti Google sudah mengunjungi dan membaca halaman itu, lalu memutuskan untuk tidak mengindeksnya. Untuk “Ditemukan”, periksa kapasitas crawl di situs yang sangat besar; untuk “Di-crawl”, periksa kualitas konten, duplikat, dan kanonis.
Apakah “Di-crawl - saat ini tidak diindeks” merugikan SEO saya?
Tidak dengan sendirinya: status ini bukan penalti, dan halaman yang terdampak hanya kehilangan traffic penelusurannya sendiri. Risikonya ada pada jumlah, karena Google memperlakukan porsi besar konten yang tidak membantu sebagai sinyal di seluruh situs. Arsip tag yang keluar dari indeks tidak merugikan apa-apa; halaman produk merugikan. Jika jumlahnya naik setiap kali Anda memublikasikan konten, tangani sebagai masalah konten di tingkat situs, bukan daftar URL satu per satu.
Berapa lama halaman diindeks setelah diperbaiki?
Perkirakan antara satu hari hingga beberapa minggu, dan pengindeksan tidak pernah dijamin. Menurut Google, crawl ulang memerlukan beberapa hari hingga beberapa minggu, permintaan pengindeksan biasanya diproses dalam sekitar satu hari tetapi bisa memakan waktu satu hingga dua minggu, dan Validasi perbaikan biasanya memerlukan waktu hingga sekitar dua minggu.
Apakah meminta pengindeksan akan membantu?
Hanya setelah Anda mengubah halamannya. Meminta pengindeksan untuk halaman yang tidak berubah sama saja meminta Google mengulangi keputusan yang sudah diambilnya. Permintaan dibatasi kuota harian, dan Google menyatakan bahwa mengirim URL yang sama berkali-kali tidak mempercepat apa pun.
Apakah menambahkan halaman ke sitemap XML membantu?
Sitemap membantu Google menemukan URL, bukan mengindeksnya. Google menyebut sitemap yang dikirim “hanya sebagai petunjuk”, dan halaman-halaman ini sudah ditemukan dan dibaca. Setelah perbaikan, tugas sitemap adalah mengelompokkan URL yang ingin Anda periksa ulang. Setiap file sitemap memuat hingga 50.000 URL atau 50 MB.
Mengapa validasi “Di-crawl - saat ini tidak diindeks” saya gagal?
Validasi berhenti begitu Google menemukan satu URL dalam grup yang belum diperbaiki, sehingga satu halaman yang tersisa bisa membuat seluruh batch gagal. Perbaiki setiap URL dalam grup, atau persempit grup dengan memfilter laporan menggunakan sitemap yang hanya berisi URL yang sudah diperbaiki, lalu validasi lagi.
Bagaimana SEOcrawl AI membantu menangani halaman yang di-crawl Google tetapi tidak diindeks?
SEOcrawl AI menemukan penyebab di sisi situs di balik status ini. Crawler menampilkan skor kesehatan, kode status HTTP, dan kedalaman crawl setiap URL, sehingga Anda bisa menemukan halaman yang sulit dijangkau Google. Tampilan Indexation mengelompokkan URL Anda berdasarkan status cakupan Search Console, dan SEO Monitor memberi tahu Anda saat halaman penting mendapat noindex, berganti kanonis, mengembalikan 404, atau keluar dari sitemap.
Penulis: David Kaufmann

Saya telah menghabiskan lebih dari 10 tahun terakhir benar-benar terobsesi dengan SEO — dan jujur saja, saya tidak mau menukarnya dengan apa pun.
Karier saya mencapai level baru ketika saya bekerja sebagai senior SEO specialist untuk Chess.com — salah satu dari 100 website paling banyak dikunjungi di seluruh internet. Bekerja di skala seperti itu, di jutaan halaman, puluhan bahasa, dan di salah satu SERPs paling kompetitif yang ada, mengajari saya hal-hal yang tidak akan pernah bisa diberikan oleh kursus atau sertifikasi mana pun. Pengalaman itu mengubah cara pandang saya tentang seperti apa SEO yang benar-benar hebat — dan menjadi fondasi bagi semua yang saya bangun setelahnya.
Dari pengalaman itu, saya mendirikan SEO Alive — sebuah agency untuk brand yang serius menggarap pertumbuhan organik. Kami tidak di sini untuk menjual dashboards dan laporan bulanan. Kami di sini untuk membangun strategi yang benar-benar menggerakkan hasil, menggabungkan yang terbaik dari SEO klasik dengan dunia baru yang menarik dari Generative Engine Optimization (GEO) — memastikan brand Anda tidak hanya muncul di tautan biru Google, tetapi juga di dalam jawaban yang dihasilkan AI yang dikirimkan ChatGPT, Perplexity, dan Google AI Overviews kepada jutaan orang setiap harinya.
Dan karena saya tidak bisa menemukan tool yang menangani kedua dunia itu dengan benar, saya membangunnya sendiri — SEOcrawl AI, sebuah platform enterprise SEO intelligence yang menyatukan rankings, audit teknis, pemantauan backlinks, kesehatan crawl, dan pelacakan visibilitas brand di AI dalam satu tempat. Inilah platform yang selalu saya harap pernah ada.
Temukan lebih banyak konten dari penulis ini


Domain Authority memprediksi seberapa baik sebuah situs bisa meraih peringkat, tetapi bukan faktor peringkat Google. Inilah yang sebenarnya diukur DA, perbandingannya dengan DR dan Authority Score, serta metrik yang lebih layak Anda perhatikan.