Sådan bliver du nævnt i ChatGPT: en guide til ChatGPT-SEO i 2026
ChatGPT er stille og roligt blevet en af de mest indflydelsesrige discovery-motorer på internettet. I 2026 får millioner af brugere anbefalinger af brands og produkter direkte fra AI-genererede svar i stedet for fra klassiske søgeresultater. Dukker din virksomhed ikke op i de svar, er du usynlig for en hurtigt voksende del af dit publikum.
Hvad det vil sige at »rangere« i ChatGPT i 2026
Der findes ingen position 1 i ChatGPT. Ingen SERP at følge. Når nogen beder ChatGPT om at anbefale et værktøj eller spørger, hvem de førende udbydere i en kategori er, genererer modellen et svar. Og enten er dit brand i det svar, eller også er det ikke.
Sådan henter og citerer ChatGPT's søgning sine kilder
ChatGPT arbejder i to tilstande. Er websøgning slået fra, trækker den på sine træningsdata: alt, hvad den nåede at indlæse før sin knowledge cutoff. Er websøgning slået til (og det er den i stigende grad som standard), søger den i Bing i realtid, læser indholdet og syntetiserer et svar med indlejrede citater. Begge tilstande betyder noget, og de reagerer på hver sine signaler.
Forskellen på klassisk SEO og optimering til AI-søgning
Klassisk SEO handler om at rangere en side på et søgeord på en resultatside. Optimering til AI-søgning handler om at skabe de betingelser, der får en model til at stole nok på dit brand til at nævne det i et genereret svar.
Google belønner relevans på siden, linkautoritet og teknisk sundhed. ChatGPT belønner hvor ofte dit brand nævnes, din tilstedeværelse off-page, og indhold der kan trækkes rent ud uden yderligere kontekst. Overlappet findes (backlinks og E-E-A-T tæller begge steder), men vægtningen og pipelinen er en anden.
Derfor betyder placeringer i ChatGPT noget for trafik og brandsynlighed
ChatGPT håndterer over 2,5 milliarder beskeder om dagen. En voksende del af dem er forespørgsler om anbefalinger af produkter og services. Brugere, der får en anbefaling fra ChatGPT, går ofte ikke tilbage til Google for at tjekke efter. AI'ens topvalg bliver brugerens topvalg 74 % af gangene (Growth Memo, april 2026).
Henvisningstrafik fra AI-kilder konverterer uforholdsmæssigt godt. I 88 % af alle AI Mode-sessioner forlod brugerne aldrig ruden for at tjekke eksterne kilder. Det brand, der bliver citeret først, har en klar fordel.

Sådan afgør ChatGPT, hvilke kilder den citerer
At forstå mekanikken bag citaterne er grundlaget for alt det andet. De fleste råd om ChatGPT-SEO springer det over og går direkte til taktikken. Det er en fejl.
Træningsdata vs. hentning i realtid
I træningsdata-tilstand svarer ChatGPT ud fra det, den lærte under pre-training. De brands og kilder, der optrådte hyppigt og autoritativt på nettet før modellens cutoff, er dem, den forbinder med et givet emne. Det kan du ikke ændre med tilbagevirkende kraft, men du kan begynde at opbygge de signaler, der kommer til at tælle i næste træningsrunde.
I realtids-tilstand bruger ChatGPT Retrieval-Augmented Generation (RAG): den formulerer en søgning, henter resultater fra Bing, læser indholdet og syntetiserer et svar med citater. Det er her, optimeringsarbejdet har direkte og målbar effekt.
Sådan driver Bing ChatGPT's live-søgeresultater
87 % af ChatGPT's citater i realtids-tilstand overlapper med Bings topresultater (Seer Interactive). Det er det enkeltstående vigtigste datapunkt for enhver, der vil forbedre sin synlighed i ChatGPT. Rangerer dit site godt på Google, men er det ikke ordentligt indekseret i Bing, er du usynlig i ChatGPT's realtids-tilstand, uanset hvor godt dit indhold er.
Google-SEO og synlighed i ChatGPT hænger sammen, men er ikke det samme. Autoritetssignalerne overlapper (backlinks, E-E-A-T, brandets troværdighed), men pipelinen er en anden. Bing har sin egen crawler, sit eget indeks og sine egne ranking-signaler.
Autoritetssignaler ChatGPT læner sig op ad (E-E-A-T, brandomtaler, links)
En analyse fra 2024 af 82 faktorer med sammenhæng til ChatGPT-citater viste, at relevans (r=0,91) og brandomtaler (r=0,87) var de to stærkeste signaler — begge off-page. Struktureret on-page-optimering optrådte ikke som en primær driver. Det betyder ikke, at on-page er ligegyldigt, men bruger du al din energi på on-page-finpudsning og ignorerer din tilstedeværelse off-page, optimerer du det forkerte lag.

Sådan påvirker retrieval-augmented generation (RAG) valget af kilder
RAG er den mekanisme, der får ChatGPT's live-søgning til at virke. Når en bruger stiller et spørgsmål med websøgning slået til, nedbryder modellen forespørgslen i underforespørgsler, henter relevante resultater fra Bing, læser indholdet og udvælger passager, den kan sy sammen til et svar.
Du kan rangere på fan-out-underforespørgsler (de støttespørgsmål, modellen genererer, når den nedbryder en hovedforespørgsel), selv om du ikke rangerer på hovedsøgeordet. Dertil kommer, at modellen udvælger passager, ikke sider. En side, hvor svaret er begravet i en mur af tekst, taber til en side, hvor svaret står i de første 60 ord i et klart struktureret afsnit.

Opbyg emneautoritet, som AI-modeller stoler på
De brands, ChatGPT citerer mest konsekvent, er ikke nødvendigvis dem med flest sider eller den højeste Domain Authority. Emneautoritet vil sige, at modellen gentagne gange har mødt dit brand som en troværdig kilde til et bestemt emne — på tværs af dit eget indhold, omtaler hos tredjepart og redaktionel dækning.
- Lav grundigt, ekspertdrevet indhold om dine kerneemner. AI-modeller foretrækker kilder, der konsekvent dækker et emne komplet og på ekspertniveau.
- Udgiv original research og egne data. Førstepartsdata, cases og original analyse er citatmagneter og det, der lærer modeller at behandle dig som en autoritativ kilde.
- Vis erfaring fra den virkelige verden. Førstehåndsberetninger, konkrete eksempler fra praksis og ægte ekspertise bidrager alt sammen til E-E-A-T.
- Dæk hele tragten. Byg indhold, der tager emnet fra spørgsmål på awareness-niveau helt ned til sammenligninger, der er klar til konvertering.

Optimér din indholdsstruktur til store sprogmodeller
Klare, konstaterende sætninger og direkte svar
De første 40-60 ord i ethvert afsnit skal levere kernesvaret direkte. Byg ikke op til det. En model, der trækker en passage ud til et citat, har brug for noget, der står alene uden den omkringliggende kontekst.
Undgå kontekstafhængige henvisninger: »denne tilgang«, »metoden ovenfor«, »som nævnt tidligere«. Hver passage skal kunne stå alene.

Formatér indhold med overskrifter, lister og tabeller, LLM'er kan læse
Struktureret formatering er et signal til modellen om, hvordan informationen er organiseret. Overskrifter, der rammer et afsnit ind som et spørgsmål, hjælper modellen med at se, hvad afsnittet svarer på. Punktopstillinger og tabeller lader modellen trække struktureret information ud uden at skulle tygge sig gennem løbende prosa.
Brug H2'er og H3'er som spørgsmål, brugerne rent faktisk stiller — ikke som søgeordsfraser eller emneetiketter.
Skriv korte definitioner og opsummeringer, AI kan løfte ordret
Skriv definitioner på fagudtryk i samme sætning eller den umiddelbart efter. Her er et eksempel på et afsnit, der er klar til at blive citeret:
Retrieval-Augmented Generation (RAG) er den mekanisme, ChatGPT bruger til at besvare spørgsmål med webdata i realtid. Når en bruger stiller et spørgsmål med websøgning slået til, søger modellen i Bing, henter relevante sider, læser indholdet og syntetiserer et svar med indlejrede citater. Sider, der er nemme at læse maskinelt (klar struktur, direkte svar, ingen mure af jargon), bliver oftere valgt som kilder.
Hver eneste sætning i det afsnit kan stå alene. Ingen sætning kræver den foregående for at give mening.
Implementér schema-markup og strukturerede data
Sider, ChatGPT citerer, har strukturerede data 71 % af gangene (Rankmax). De mest relevante schemaer:
- FAQPage: Selv om Google droppede FAQ-rich resultatet i maj 2026, er FAQPage-schema stadig værdifuldt — LLM'er læser strukturerede data, når de indekserer sider, uafhængigt af hvad Google vælger at vise. Svar på 80-150 ord virker bedre til AI-udtræk end de 30-ords svar, der blev bygget til Googles harmonika.
- Article with Author: Kobler eksplicit indholdet til en verificeret person med faglige kvalifikationer — et direkte E-E-A-T-signal på schema-niveau.
- HowTo: Nyttigt til procedureindhold, hvor en klar rækkefølge gør udtrækket lettere.
Optimér til featured snippets (de fodrer AI-svarene)
Indhold optimeret til featured snippets (direkte svar i første afsnit, klare overskrifter i spørgsmålsform, struktureret formatering) er præcis den slags indhold, AI-modeller trækker ud. De to optimeringsmål er næsten identiske.
Vinder dine sider featured snippets på informationssøgninger i din kategori, er de allerede struktureret, som AI-modeller foretrækker.
Styrk dit brands digitale fodaftryk og signaler off-page

Optjen backlinks fra troværdige domæner med høj autoritet
Backlinks fra anerkendte medier gør dobbelt arbejde: de bidrager til din placering i Bing (direkte pipeline til ChatGPT's hentning) og lægger datapunkter til modellens kobling mellem dit brand og emnet. Et enkelt link fra et autoritativt domæne i din branche vejer tungere end snesevis af links fra sites med lav autoritet.
Bliv nævnt i podcasts, på YouTube og i brancheudgivelser
At være gæst i en relevant podcast eller bidrage til en YouTube-kanal i din kategori giver omtaler i flere formater (show notes, transskriptioner, opsummerende artikler) — hvert af dem et datapunkt. Lyd og video fylder mere og mere i LLM'ers træningsdata.
Opbyg konsekvente brandomtaler på nettet (omtaler uden link tæller med)
At dit brandnavn optræder i relevante sammenhænge uden et hyperlink (brandomtaler uden link) lærer modellen at forbinde dit brand med et emne. Hvor ofte de to optræder sammen, tæller uafhængigt af, om der er et link. Behandl brand-PR, deltagelse i communities og earned media som AI-SEO-signaler, ikke bare som awareness-aktiviteter.
Udnyt Wikipedia, Wikidata og tilstedeværelse i Knowledge Graph
Wikipedia er blandt de kilder, der vægter tungest i LLM'ers træningsdata. En Wikipedia-side om dit brand gør det lettere for modellen at forbinde dit navn med en bestemt kategori, og det øger direkte sandsynligheden for at blive citeret. Wikidata-poster har en tilsvarende effekt på optagelse i knowledge graph.
Optimér din Google Business Profile og oversigter hos tredjepart
Konsekvens i brandnavn, beskrivelse og kategori på tværs af platforme (Google Business Profile, G2, Capterra, branchekataloger) bidrager til entitetskonsistens. Det fortæller modellerne, at dit brand er en stabil, virkelig entitet med en klar identitet — ikke en enkeltstående omtale i én sammenhæng.
Tekniske SEO-fundamenter, der understøtter synlighed over for AI

Sørg for, at dit site er indekseret i Bing (ikke kun Google)
Sæt Bing Webmaster Tools op, indsend dit sitemap, og tjek at dine vigtigste sider er indekseret. Når 87 % af ChatGPT's citater kan spores tilbage til Bing-resultater, er det den tekniske handling med højest ROI, du har.
Optimér sidehastighed, Core Web Vitals og mobiloplevelsen
Langsomme sider og en dårlig mobiloplevelse sænker crawl-prioriteten hos alle bots, også AI-crawlere. Det er optimeringer, du får brug for til alt indhold, der skal findes af en crawler — uanset ChatGPT. Er du i tvivl om, hvor du står, så start med dine Core Web Vitals.
Brug en ren sitearkitektur, der kan crawles
Sider bag login, JavaScript-tung rendering der blokerer crawlere, eller dybt begravede URL-strukturer sænker alle sammen chancen for, at AI-systemer når dit indhold. En flad, logisk arkitektur med klar intern linkstruktur gør det lettere for enhver crawler at finde og indeksere dit indhold.
Brug robots.txt og llms.txt til at guide AI-crawlere
Tjek din robots.txt-fil eksplicit for AI-crawlernes user agents: GPTBot (OpenAI), ClaudeBot (Anthropic), PerplexityBot. Gamle brede disallow-regler kan komme til at blokere dem. Er en AI-crawler blokeret, kan det system ikke tilgå dit indhold i realtids-tilstand.
llms.txt er en ny standard, der lader ejere af sites angive, hvilket indhold AI-systemer skal prioritere, når de indekserer domænet. Udbredelsen er stadig tidlig i 2026, men implementerer du den nu, står du foran, når standarden bliver udbredt.
Indsend og vedligehold et opdateret XML-sitemap
Et præcist og aktuelt sitemap indsendt til både Google Search Console og Bing Webmaster Tools sikrer, at crawlere finder dit indhold effektivt. For sites, der udgiver ofte, mindsker dynamiske sitemaps, der opdaterer sig selv, forsinkelsen mellem udgivelse og indeksering.
Omdømme- og tillidssignaler, der påvirker AI-anbefalinger
Saml og fremvis anmeldelser på G2, Trustpilot og Google
Anmeldelsesplatforme er tungt indekseret og bærer stærke sentimentsignaler. ChatGPT opsuger tonen fra det, den finder om dit brand. Et brand med konsekvent positive anmeldelser på flere platforme bliver beskrevet anderledes end et med blandede signaler. Både mængde og hvor nye de er, tæller.
Byg forfattersider med autoritet og verificerbare kvalifikationer
En forfatterside med verificerbare kvalifikationer, udgivelseshistorik og faglige profiler giver modellen eksplicitte signaler om, hvem der står bag indholdet, og hvorfor man kan stole på dem. Link forfattersider til eksterne profiler (LinkedIn, medlemskaber af brancheforeninger), som modellen kan krydstjekke.
Kom med på »best of«-lister og brancheoversigter
At blive inkluderet i kuraterede lister hos anerkendte medier kombinerer autoritet off-page med en direkte kobling mellem emne og brand. Når modellen henter en artikel om »de bedste [kategori]-værktøjer« for at besvare en anbefalingsforespørgsel, får hvert brand på listen en chance for at blive citeret.
Reagér på negative omtaler for at holde brandets sentiment i orden
Uadresseret negativ dækning former det sentiment, AI-modeller beskriver dit brand med. Et brand med uløste offentlige klager eller negativ dækning i autoritative kilder bliver beskrevet med netop de associationer.
Mål og følg din ChatGPT-synlighed i 2026
Værktøjer til at overvåge AI-citater og brandomtaler
I modsætning til Google findes der ingen Search Console for ChatGPT. Uden dedikeret måling har du ingen indsigt i, om du bliver citeret, eller hvordan du står i forhold til konkurrenterne.
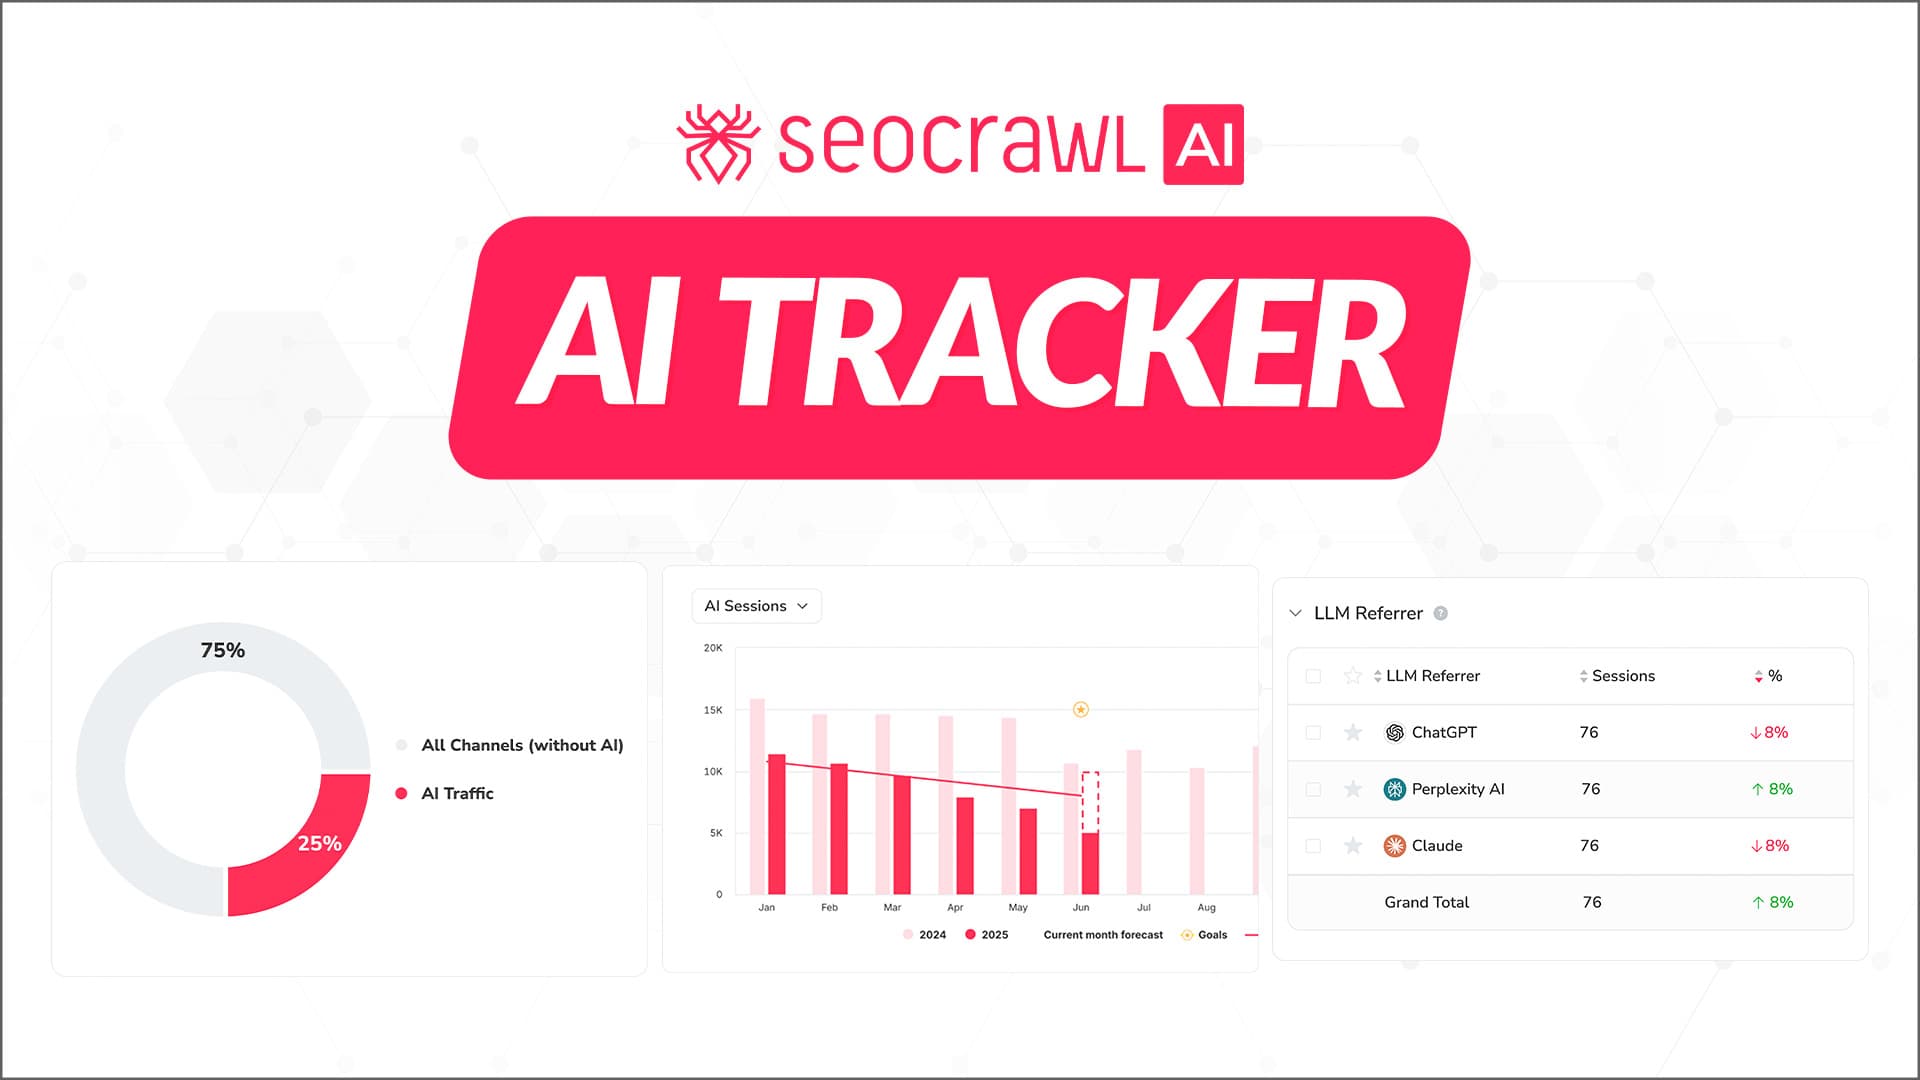
SEOcrawl AI's AI Tracker overvåger brandomtaler, share of voice og sentiment i ChatGPT, Claude, Gemini, Perplexity og Copilot og kobler de data til dine klassiske SEO-placeringer og din trafik i det samme dashboard.
Sådan prompt-tester du din egen ChatGPT-synlighed
Den manuelle metode kræver ingen værktøjer. Kør prompts på kategoriniveau i ChatGPT: »Hvilke [din kategori]-værktøjer er de førende?«, »Hvilke [din kategori]-udbydere bruger de fleste enterprise-teams?«, »Sammenlign [dit brand] og [konkurrent]«. Notér så, om dit brand dukker op, hvor det dukker op, og hvordan det bliver beskrevet.
Men et enkelt tjek kan give dig et misvisende billede. Til systematisk måling i stor skala kører SEOcrawl AI's Prompt Tracker dine prompts i ChatGPT efter en tidsplan og logger hver brandomtale og citeret URL, så du ser præcis de spørgsmål, hvor ChatGPT allerede anbefaler dig.
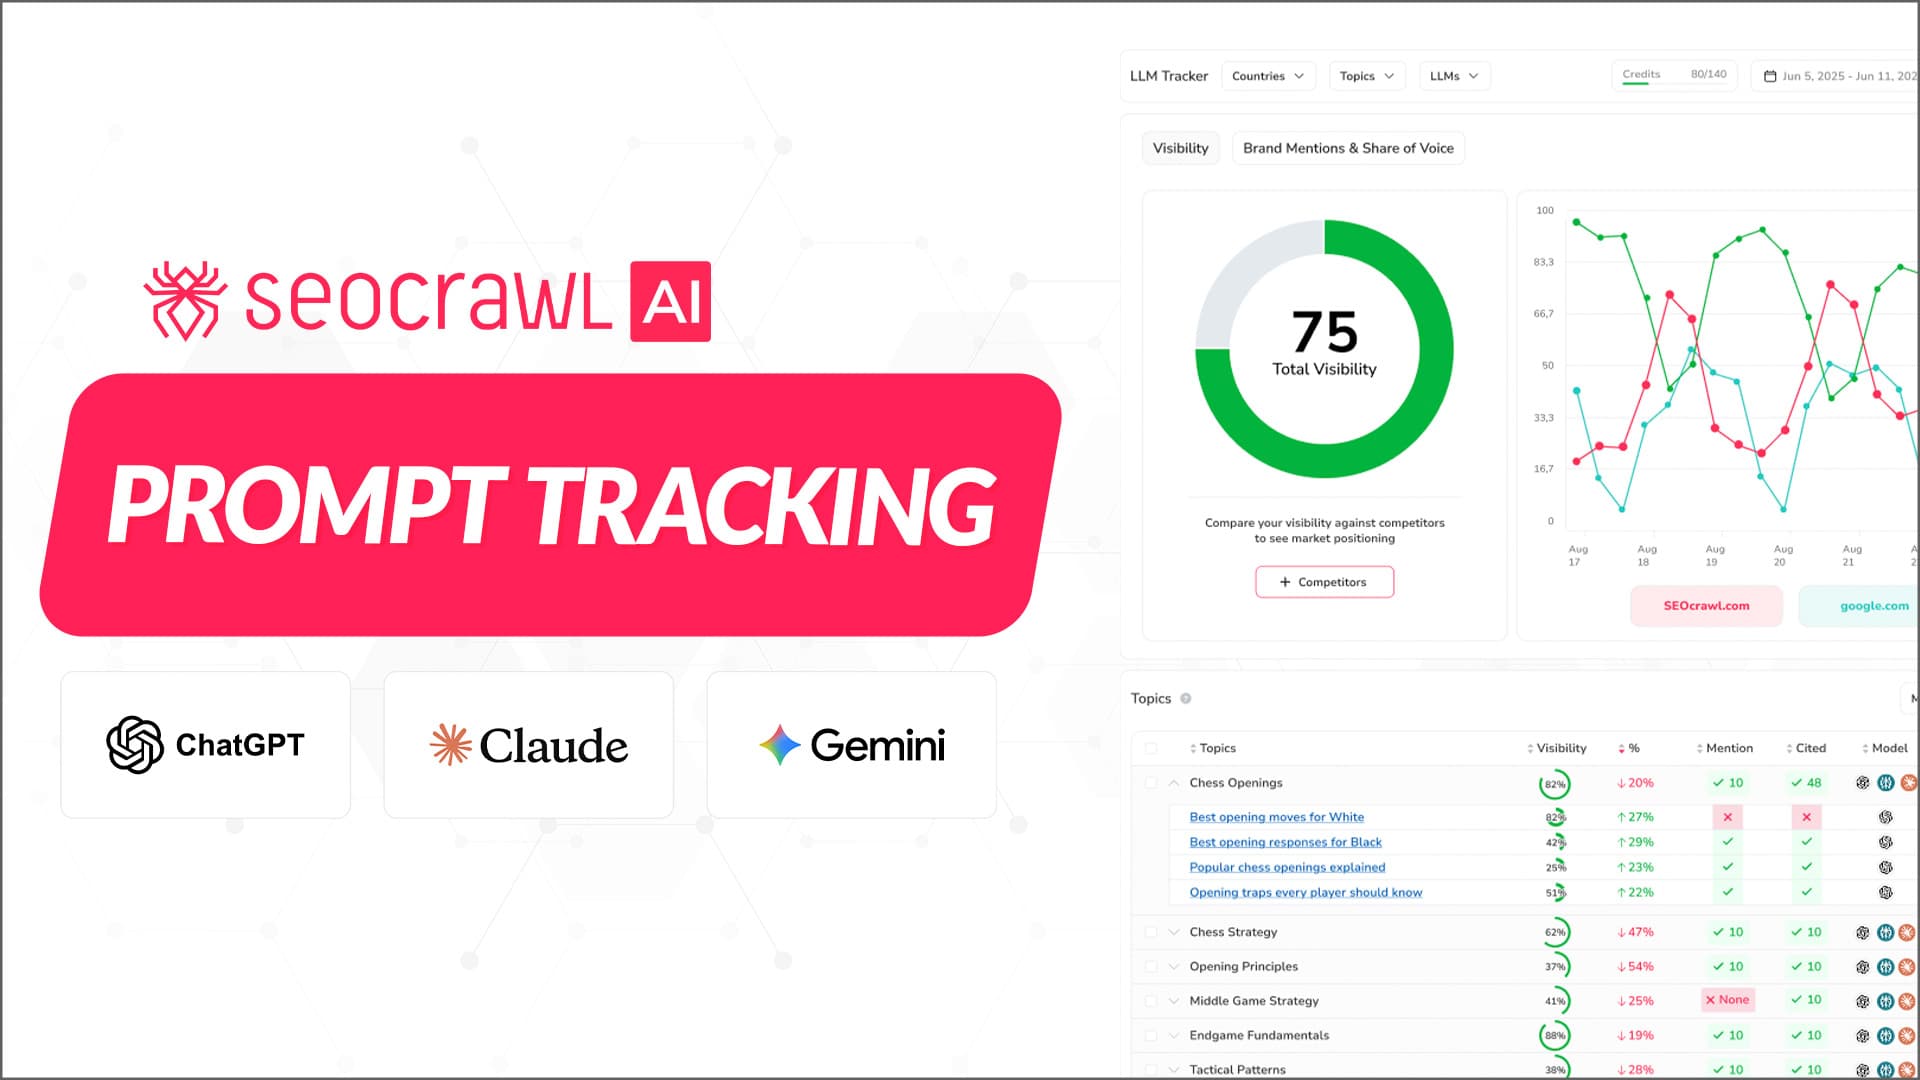
Den scorer også din share of voice mod de konkurrenter, du navngiver, og advarer dig, når en af dem begynder at vinde en prompt, du plejede at eje.
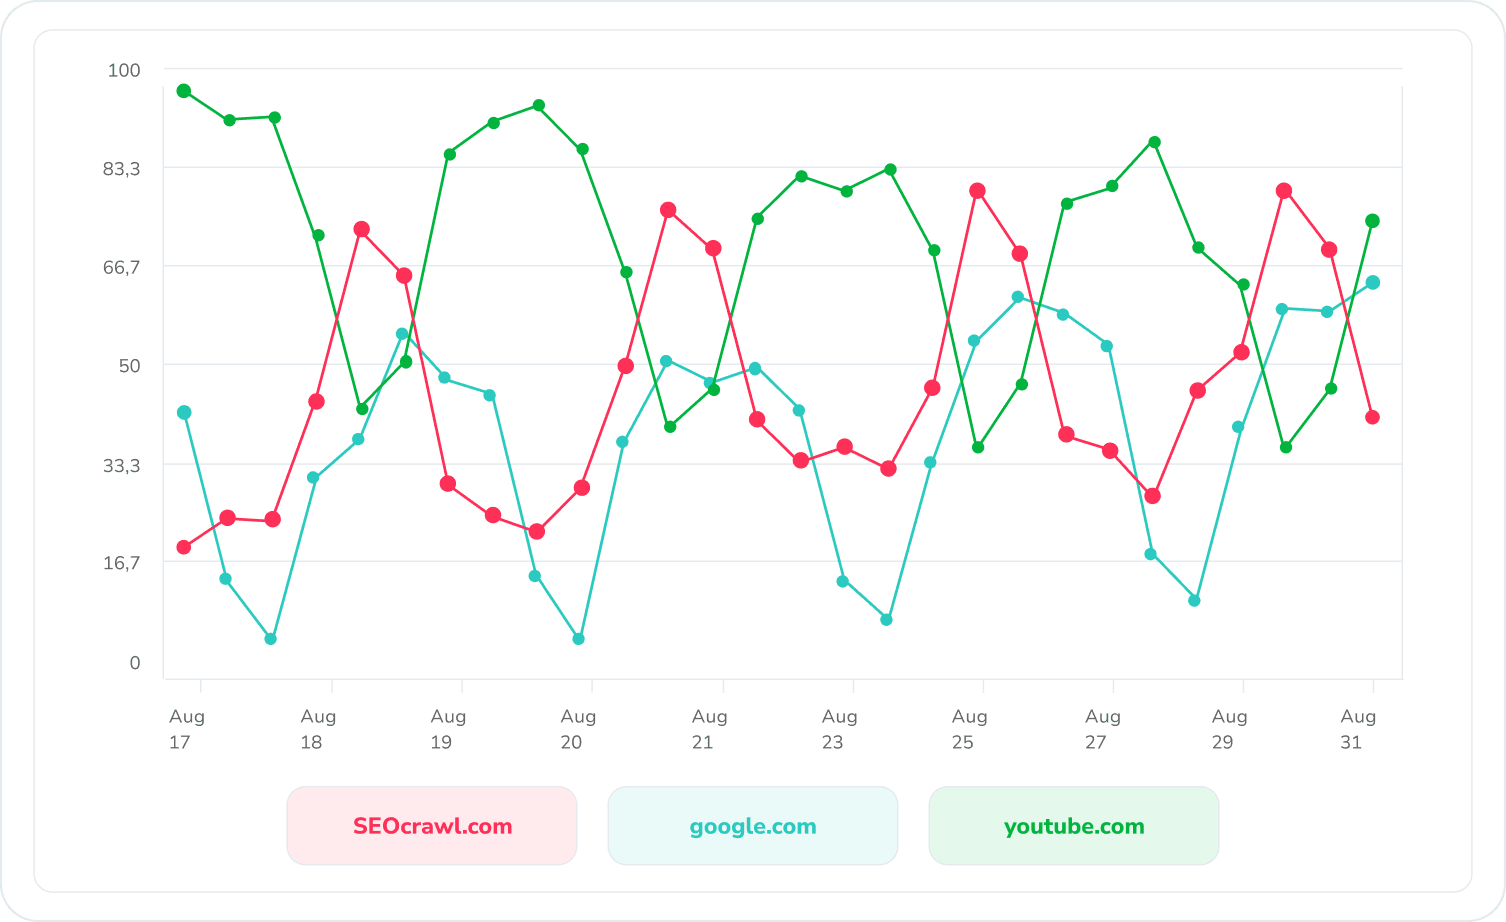
Nøgletal: share of voice i AI, henvisningstrafik fra AI-kilder
- Share of voice: hvor stor en andel af de relevante prompts der nævner dit brand, målt mod konkurrenterne.
- Citeringsfrekvens: hvor ofte dit brand optræder i et defineret sæt prompts over tid.
- Sentiment: om modellen beskriver dit brand positivt, neutralt eller med forbehold.
- Citerede URL'er: hvilke af dine sider modellen henviser til som kilder.
- Henvisningstrafik fra AI: sessioner tilskrevet ChatGPT, Perplexity og andre LLM'er i din analytics, som en retningsgivende indikator for effekten af citaterne.

Justér din strategi ud fra data om AI-synlighed
Optimering af AI-synlighed er ikke et engangsprojekt. Modellens associationer ændrer sig, efterhånden som nyt indhold bliver udgivet, træningsdata bliver opdateret, og din tilstedeværelse off-page udvikler sig.
Læg en baseline-måling, lav målrettede ændringer (en ny plads på en liste, en schema-opdatering, en rettelse af Bing-indekseringen), og mål effekten over 4-8 uger. Byg en feedback-løkke mellem de ændringer, du laver, og de synlighedsdata, du samler ind.
Almindelige fejl, der skader dine placeringer i ChatGPT
Tyndt AI-genereret indhold uden reel ekspertise
Indhold uden ægte ekspertise, original vinkel eller førstehåndserfaring opbygger ikke emneautoritet. Det lægger sider til uden at lægge signaler til. Værre endnu: har modellen set nok AI-genereret indhold af lav kvalitet, forbinder den generisk sprogbrug med kilder med lav autoritet — det modsatte af det, du vil.
At ignorere Bing Webmaster Tools
Ethvert SEO-team har et flow i Google Search Console. Næsten ingen har et tilsvarende Bing-flow. Med den direkte pipeline fra Bing til ChatGPT er det et af de huller, det betaler sig mest at lukke. Og det er også et af de nemmeste, for opsætningen tager minutter og koster ingenting. Behandl det med samme prioritet som Google Search Console.
Keyword stuffing vs. optimering til naturligt sprog
ChatGPT belønner ikke gentagelse af søgeord. Den foretrækker sider, der besvarer spørgsmålet fuldt ud. En side, der bruger målfrasen ti gange uden at give et komplet svar, der kan trækkes ud, bliver sprunget over til fordel for en side, der svarer direkte på spørgsmålet, selv om den bruger frasen færre gange.
At forsømme brandopbygning uden for eget site
On-page-optimering er nødvendig, men ikke nok. Har dit brand ingen tilstedeværelse off-page (redaktionelle omtaler, pladser på lister eller snak i communities), har modellen ingen grund til at nævne det, uanset hvor velstruktureret dit indhold er.
Utilsigtet blokering af AI-crawlere
En robots.txt-fil skrevet for år tilbage kan indeholde brede disallow-regler, der nu blokerer GPTBot (OpenAI), ClaudeBot (Anthropic) eller PerplexityBot. Gennemgå den eksplicit for hver AI-crawlers user agent. Det er den slags fejl, der er usynlig, indtil du tjekker, og den diskvalificerer dit indhold fra hele retrieval-pipelinen.
Tjek også, at dine sider ikke kræver login for at loade, at JavaScript-rendering ikke blokerer indholdet fra at blive læst, og at dine vigtigste sider returnerer rene 200-statuskoder til alle crawlere.
FAQs
Kan man overhovedet »rangere« i ChatGPT på samme måde som på Google?
Ikke i klassisk forstand. Google rangerer sider efter placering på en resultatside. ChatGPT genererer et svar og tager enten dit brand med i det eller lader være. Det, der svarer til en »placering«, er at blive citeret eller anbefalet. Det, der driver anbefalinger, er en kombination af autoritet off-page, hvor ofte brandet nævnes, og hvor let indholdet kan trækkes ud — ikke søgeordsplacering.
Hjælper Google-SEO dig med at blive nævnt i ChatGPT?
Delvist. Stærk Google-SEO opbygger autoritetssignaler (backlinks, E-E-A-T, brandets troværdighed), som AI-modeller også værdsætter. Men ChatGPT's live-søgning bruger Bing, ikke Google. Et site, der rangerer godt på Google, men ikke er indekseret i Bing, får begrænset synlighed i ChatGPT, når den henter i realtid.
Hvor lang tid går der, før man begynder at dukke op i ChatGPT's svar?
Når den henter i realtid, kan forbedringer af Bing-placeringen vise sig på uger. I træningsdata-tilstand afhænger tidshorisonten af modellens træningscyklus (typisk måneder). Den mest pålidelige vej er at opbygge tilstedeværelse off-page vedholdende: pladser på lister, redaktionelle omtaler og snak i communities skaber et signal, der påvirker begge tilstande over tid.
Hvad er generative engine optimization (GEO), og hvad har det med ChatGPT-placeringer at gøre?
GEO er arbejdet med at optimere indhold, så det bliver citeret i AI-genererede svar på platforme som ChatGPT, Perplexity og Googles AI Overviews. Det er paraplybetegnelsen for alt det, denne artikel dækker. Kerneprincipperne (semantisk fuldstændighed, autoritet off-page, struktureret indhold) gælder på tværs af alle store LLM'er, med forskelle i, hvordan den enkelte model vægter de forskellige signaler.
Hjælper en Wikipedia-side dig med at blive nævnt i ChatGPT?
Ja, mærkbart. Wikipedia er blandt de kilder, der vægter tungest i LLM'ers træningsdata. En Wikipedia-side om dit brand gør det lettere for modellen at forbinde dit navn med en bestemt kategori, og det øger direkte sandsynligheden for at blive citeret. Wikidata-poster har en tilsvarende effekt på optagelse i knowledge graph.
Hvad er llms.txt, og skal jeg lægge den på mit website?
llms.txt er en ny standard, der fungerer som robots.txt, bare for AI-crawlere. Den lader ejere af sites angive, hvilket indhold AI-systemer skal prioritere, når de indekserer deres domæne. Udbredelsen er stadig tidlig i 2026, men at lægge den ind nu er et fremadrettet signal med lav indsats og ingen ulemper.
Hvordan tjekker jeg, om ChatGPT allerede nævner mit brand?
Den manuelle metode: kør prompts på kategoriniveau i ChatGPT (for eksempel »hvilke [din kategori]-værktøjer er de førende?«) og notér, om dit brand dukker op, og hvordan det bliver beskrevet. Til systematisk måling på tværs af flere prompts og LLM'er overvåger SEOcrawl AI's AI Tracker brandomtaler, share of voice og sentiment i ChatGPT, Claude, Gemini, Perplexity og Copilot i ét dashboard.
Påvirker tilstedeværelse på sociale medier placeringer i ChatGPT?
Indirekte. Opslag på sociale medier er sjældent direkte kilder til citater. Men aktiviteten spreder indholdet. Opslag, der får fat, giver anledning til artikler, diskussioner og omtaler, som bliver indekseret. En stærk tilstedeværelse på sociale medier øger overfladen af dit brands fodaftryk off-page, og det er den primære driver bag, hvor ofte du bliver citeret.
Forfatter: David Kaufmann

Jeg har brugt de sidste 10+ år fuldstændig opslugt af SEO — og helt ærligt: jeg ville ikke have det anderledes.
Min karriere rykkede et niveau op, da jeg arbejdede som senior SEO-specialist for Chess.com — et af de 100 mest besøgte websites på hele internettet. At arbejde i den skala, på tværs af millioner af sider, snesevis af sprog og en af de mest konkurrenceprægede SERP'er der findes, lærte mig ting, som intet kursus og ingen certificering kunne have lært mig. Den erfaring ændrede mit syn på, hvordan rigtig godt SEO ser ud — og den blev fundamentet for alt, hvad jeg har bygget siden.
Ud af det grundlagde jeg SEO Alive — et bureau for brands, der mener det alvorligt med organisk vækst. Vi er ikke her for at sælge dashboards og månedsrapporter. Vi er her for at bygge strategier, der rent faktisk flytter noget, og vi kombinerer det bedste fra klassisk SEO med den spændende nye verden inden for Generative Engine Optimization (GEO) — så dit brand ikke kun dukker op i Googles blå links, men også inde i de AI-genererede svar, som ChatGPT, Perplexity og Google AI Overviews leverer til millioner af mennesker hver eneste dag.
Og fordi jeg ikke kunne finde et værktøj, der håndterede begge verdener ordentligt, byggede jeg selv et — SEOcrawl AI, en enterprise-platform til SEO-intelligens, der samler placeringer, tekniske audits, backlink-overvågning, crawl-sundhed og tracking af brandets synlighed i AI ét sted. Det er den platform, jeg altid ønskede fandtes.
Find mere indhold fra denne forfatter