Hvordan opdager og retter du duplikeret indhold?
Arbejder du med SEO, er du sikkert havnet i den situation, hvor du skulle tage dig af et af de mest almindelige problemer, der rammer placeringerne i søgemaskinerne og kan føre til straf: duplikeret indhold. Søgemaskiner som Google, Bing og Yahoo har som hovedformål at vise den mest relevante information til brugernes søgeintention. Det gør de ved at rangere faldende, belønne originalt indhold af høj kvalitet og straffe indhold, der er kopieret, duplikeret, irrelevant eller manipuleret for at rangere højere på resultatsiderne.
I denne artikel forklarer vi, hvad duplikeret indhold er, hvordan vi opdager og retter det, hvad det betyder for SEO, og hvilke værktøjer vi kan bruge til arbejdet. Er du med? Lad os komme i gang! ?
Hvad er duplikeret indhold?
Som nævnt straffer søgemaskiner som Google sider med duplikeret indhold, hvilket bliver tolket som to sider med forskellige URL'er, men samme indhold. Undgå derfor så vidt muligt at kopiere indhold fra et andet website og sætte det ind på dit eget (du sparer dig selv for masser af hovedpine med Google og for mulige retssager fra ejerne af de websites, du hentede det fra!?).
SEO Alive-tip**:** Som bureau specialiseret i søgemaskineoptimering anbefaler vi dig på det kraftigste at passe på indholdet på dit website og undgå den dårlige vane. Vær tålmodig og vedholdende, skriv originalt indhold, så kommer resultaterne før end siden. Google er meget klar i mælet om sin holdning, som vi kan se i deres officielle dokumentation om duplikeret indhold, så vi skal passe godt på med det indhold, vi skriver.
Inden for SEO-placeringer kan vi skelne mellem to slags duplikeret indhold: internt og eksternt.
Internt duplikeret indhold
Den type duplikeret indhold opstår typisk på grund af dårlig implementering af URL-parametre eller dårlig styring af taksonomier i kategorier og tags. De mulige årsager til internt duplikeret indhold er:
- Fejl i oprettelsen af kategorier og tags: Fejlen er almindelig på blogs med en lang liste af artikler, hvor kategorier og tags bliver oprettet uden orden eller logik. Lad os se et eksempel:
Forestil dig, at vi har en blog om digital markedsføring med flere kategorier:
https://myblogdigital.com/category-a/topic/
https://myblogdigital.com/category-b/topic/
https://myblogdigital.com/category-c/topic/
For at undgå duplikeret indhold skal vi markere, hvilken der er hovedsiden, og lade de to andre canonicalisere til hoved-URL'en.
- "Non-www" vs. "www" og "http" vs. "https"-domæner: Det er en anden fejl, vi skal være opmærksomme på. Har vi ikke fortalt søgemaskinerne, hvilket domæne der er det kanoniske, kan de tilgå de andre versioner og skabe duplikeret indhold. Derfor anbefaler vi hos SEO Alive at fastlægge, hvilket domæne der bliver dit kanoniske, og sætte 301-redirects op til den version, du vil have som den foretrukne.
- URL'er med parametre: Fejlen er almindelig på webshops, hvor URL'er med parametre giver filtrering, der viser information til brugerne. Lad os antage, at vi har et site, der sælger ure, og følgende URL:
https://www.mywatchstore.com/watches/garmin?color=black
Siden ville vise alle ure af mærket "Garmin" i sort.
Muligheden for at sætte filtre på siderne kan være et alvorligt problem, hvis den ikke bliver styret ordentligt, for søgemaskinerne kan vise flere URL-kombinationer:
https://www.mywatchstore.com/watches/garmin?color=black&type=sport
https://www.mywatchstore.com/watches/garmin?type=sport&color=black
Derfor anbefaler vi hos SEO Alive, at du sætter den kanoniske version til den ufiltrerede side, så resten af URL'erne med parametre beholder deres sideautoritet (URL Ratio).
Eksternt duplikeret indhold
Eksternt duplikeret indhold dækker over indhold, der er trukket ud eller helt eller delvist kopieret fra et eller flere websites, der har andre webmastere eller ejere.
Det er en praksis, søgemaskinerne regner for spam, og derfor bør den, som vi nævnte i begyndelsen af artiklen, undgås for enhver pris.
En anden årsag til eksternt duplikeret indhold kan være syndikeringsstrategier, hvor websites sender trafik til andre sites for at manipulere søgemaskinerne. Googles algoritme er i dag klog nok til at opdage den slags.
Hvordan tjekker vi, om vores website har duplikeret indhold?
At kunne opdage duplikeret indhold er helt afgørende i indholdsstrategien for et website. Styrer vi ikke den faktor, risikerer vi, at vores sider langsomt glider ud af topresultaterne på Google, for Google finpudser hele tiden søgeresultaterne i jagten på originalt indhold af høj kvalitet. Derfor giver vi et eksempel på, hvordan vi kunne opdage indhold på vores website, og nogle strategier til at undgå den slags indhold.
Lad os antage, at vi har en webshop (ecommerce), hvor vi har en printvenlig version af hver af produktsiderne. Det tæller som duplikeret, for der er to "versioner" af det samme indhold under forskellige URL'er:
Produktside:
https://mywebsite.com/product3560Printvenlig side:
https://mywebsite.com/product3560_printFor at undgå den type duplikeret indhold kan vi bruge følgende strategier:
Strategi #1: Brug af 301-redirects
Har vi lavet om på strukturen af vores website, kan vi sætte 301-redirects (permanente redirects) op via SEO-plugins fra de forskellige CMS'ers biblioteker, eller via .htaccess-filen, så brugere, søgemaskinernes bots og andre værktøjer med crawler-funktion bliver sendt det rigtige sted hen.
Strategi #2: Brug af canonical-tagget
Tagget rel="canonical" bruges til at fortælle søgemaskinerne, hvilken side der er originalen (den kanoniske version), og hvilke sider der er en kopi. På den måde bruger søgemaskinens spider sit crawl budget til indeksering på den side, der er markeret med det meta-tag.
For at bruge canonical-tagget skal vi først vælge, hvilken side vi vil have søgemaskinerne til at vise, og lægge følgende linje ind i HTML-koden i sektionen </head> (lad os se et eksempel på canonical på en produktside på Zalandos website):
<link rel="canonical" href="https://www.zalando.es/adidas-originals-stripe-circle-camiseta-estampada-white-ad121000k-a11.html"/>
Viser vi for eksempel detaljerne om et produkt på én URL og de samme detaljer med andre farver på en anden URL, kan vi fortælle Google, hvilken URL der er den kanoniske, som vi vil vise brugerne.
Strategi #3: Brug af robots.txt-filen
Ved at redigere filen kan vi bede søgemaskinernes bots om ikke at crawle bestemte sider eller sektioner af vores website. Forestil dig, at vi har følgende produktsider på vores website:
https://www.mywebsite.com/category/product-page.html/
https://www.mywebsite.com/category/product-page1.html/ (version med duplikeret indhold)
Med følgende direktiv i robots.txt-filen:
- Disallow /product-page.1html/
kan vi forhindre, at der opstår duplikeret indhold — ud over selvfølgelig at sætte den første URL som den kanoniske version.
Hvad duplikeret indhold betyder for placeringerne
Efter lanceringen af den første version af Googles Panda-algoritme tilbage i 2011, som straffede domæner med thin content og duplikeret indhold, udgav Matt Cutts i 2013 en video om, hvordan Google håndterer duplikeret indhold, og hvilke negative effekter det kan have på placeringerne set med SEO-briller:
Det, vi kan konkludere ud fra Matt Cutts' video, er, at selvom 25-30 % af nettet ifølge Google er duplikeret indhold, behandler søgemaskinen det ikke direkte som spam, medmindre hensigten er at skabe eller kopiere indhold i store mængder på svindelagtig vis eller direkte at manipulere placeringerne på resultatsiderne med "black hat"-taktikker.
Kort sagt kan den slags indhold sende signaler om dårlig kvalitet til søgemaskiner som Google og samtidig spærre for, at indholdets linkmetrikker (som autoritet, relevans eller tillid) bliver samlet ét sted, set fra de eksterne links (backlinks), der måtte linke til forskellige versioner af indholdet.
Værktøjer til at opdage duplikeret indhold
Når det gælder om at opdage duplikeret indhold, findes der utallige værktøjer på markedet, der kan gøre opgaven lettere. Lad os se på dem! ?
Værktøjer til at opdage duplikeret indhold på vores eget website
- Ahrefs: Med Ahrefs kan vi under funktionen "site audit", og så længe vi har oprettet et projekt til SEO-audit, se, om vores website har duplikeret indhold eller ej. Det gør vi under fanen "duplicate content". Derinde får vi vist en graf, hvor vi kan se de mulige fejl, vi skal rette:
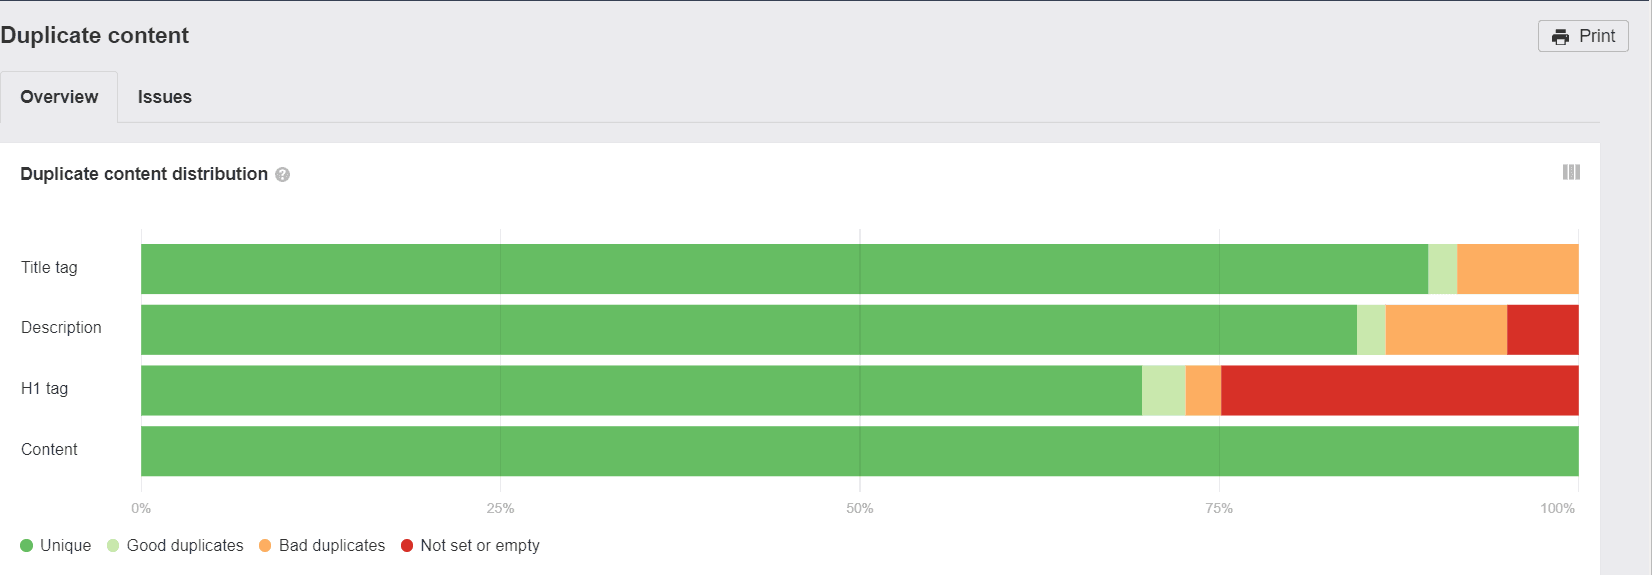
Udsnit af Ahrefs' funktion "Duplicate Content"
- Screaming Frog: Med den velkendte crawler-software er det også muligt at opdage duplikeret indhold. Vi skal indtaste et domæne, der skal scrapes, og eksportere "internal"-data til .csv-format. Når du er i regnearket, kan du se, sortere og filtrere, hvilke sider der har duplikerede titles, meta descriptions, overskrifter og så videre.
SEO Alive-tip: Brug betingede formateringsregler i dit regneark til at bestemme, hvilke URL'er du retter, ud fra hvor meget duplikeret indhold du har, og hvor vigtig og relevant hver side er.
- Safecont: Værktøjet er virkelig interessant, for det er udelukkende bygget til indholdsanalyse og bruger "machine learning" til at opdage og finde klynger og ligheder i indhold. Det er ret omfattende, og det kan give os mange fordele, hvis vi vil opdage duplikeret indhold på vores website.
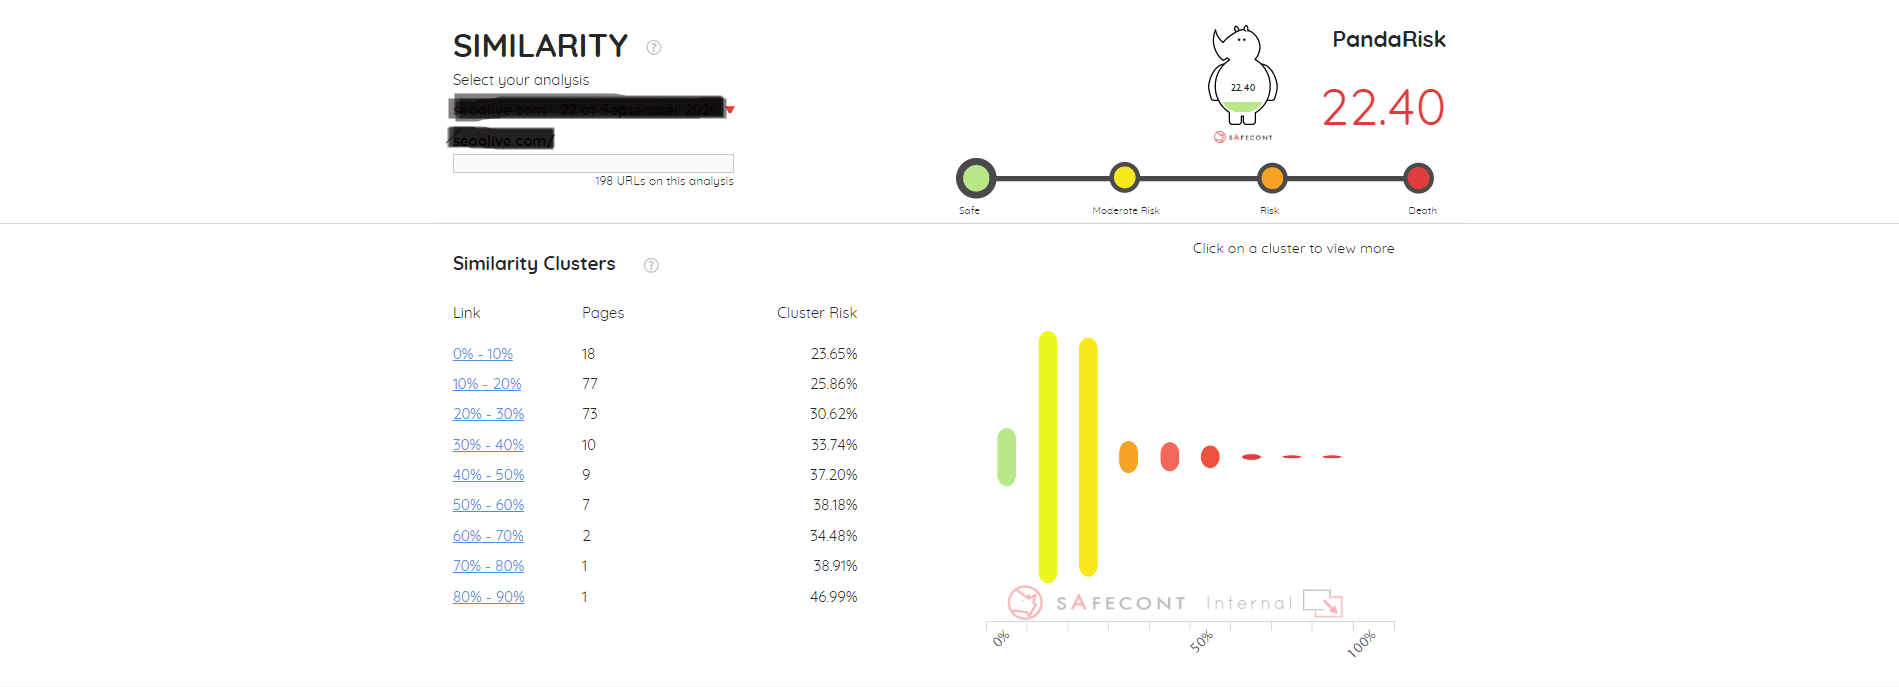
Udsnit af Safeconts funktion "Similarity"
Værktøjer til at opdage duplikeret indhold fra et andet website
- Copyscape: Vil vi vide, om et stykke indhold er duplikeret i forhold til et andet website, er Copyscape en søgemaskine, der er specialiseret i at finde websider, som plagierer indhold. I søgemaskinen skal du bare indtaste den URL, hvor indholdet, du vil tjekke, ligger, så giver værktøjet dig de sider, der deler indholdet, sorteret fra højeste til laveste grad.
- Plagium: Et andet værktøj, der minder meget om Copyscape, bortset fra at vi skal indtaste teksten, der skal tjekkes, i stedet for URL'en. Det skal siges, at det har en betalt version, så "gratis"-versionen har en grænse på op til 5.000 tegn pr. tjek.
Konklusioner
Hos SEO Alive er vi et 100 % "White Hat SEO"-bureau, så vores anbefaling til slut er at undgå duplikeret indhold hele vejen igennem. Opdager du den type indhold på dit website, så læn dig op ad alle de strategier og råd, vi har givet. ? Husk: Google kan lide originalt indhold af høj kvalitet!
Og du, har du haft en dårlig oplevelse med duplikeret indhold, eller er du blevet straffet på grund af det? Hvordan løste du det? Fortæl os om det i kommentarfeltet, hvis du har lyst! Vi svarer gerne. På gensyn!
Forfatter: David Kaufmann

Jeg har brugt de sidste 10+ år fuldstændig opslugt af SEO — og helt ærligt: jeg ville ikke have det anderledes.
Min karriere rykkede et niveau op, da jeg arbejdede som senior SEO-specialist for Chess.com — et af de 100 mest besøgte websites på hele internettet. At arbejde i den skala, på tværs af millioner af sider, snesevis af sprog og en af de mest konkurrenceprægede SERP'er der findes, lærte mig ting, som intet kursus og ingen certificering kunne have lært mig. Den erfaring ændrede mit syn på, hvordan rigtig godt SEO ser ud — og den blev fundamentet for alt, hvad jeg har bygget siden.
Ud af det grundlagde jeg SEO Alive — et bureau for brands, der mener det alvorligt med organisk vækst. Vi er ikke her for at sælge dashboards og månedsrapporter. Vi er her for at bygge strategier, der rent faktisk flytter noget, og vi kombinerer det bedste fra klassisk SEO med den spændende nye verden inden for Generative Engine Optimization (GEO) — så dit brand ikke kun dukker op i Googles blå links, men også inde i de AI-genererede svar, som ChatGPT, Perplexity og Google AI Overviews leverer til millioner af mennesker hver eneste dag.
Og fordi jeg ikke kunne finde et værktøj, der håndterede begge verdener ordentligt, byggede jeg selv et — SEOcrawl AI, en enterprise-platform til SEO-intelligens, der samler placeringer, tekniske audits, backlink-overvågning, crawl-sundhed og tracking af brandets synlighed i AI ét sted. Det er den platform, jeg altid ønskede fandtes.
Find mere indhold fra denne forfatter