Faser og elementer i crawl-processen
Crawling, spiders, bots — det er begreber, enhver SEO-person er vant til at have med at gøre i hverdagen, og de vejer tungt i enhver rankingstrategi, for hvis den her fase fejler, gør resten det også.
Lad os se i detaljer på, hvad en crawl-proces på nettet går ud på.
Hvad vil det sige at crawle et website?
Før vi går videre, så lad os definere processen med at crawle et website og vise, hvor vigtig den er i ethvert forsøg på at dukke op i Googles søgeresultater.
At crawle et website forstås som den proces, hvor spiders eller crawlere bevæger sig gennem de forskellige sider på et website, samler al den information, der er tilgængelig, for at gemme den, behandle den og senere klassificere den.
Et par grundlæggende begreber i den definition, vi lige har lagt frem, er værd at fremhæve:
-
Rejsen: Tænk faktisk på en edderkop. Det venlige insekt skal igennem så mange sider som muligt for at trække så meget information ud, det kan. For at komme fra én side til en anden gør den det gennem de interne links, der forbinder dem. Derfor er det vigtigt at have korrekt intern linkbuilding, som gør det muligt for de spiders at »opdage« — om ikke det hele — så i det mindste de sider, der er mest relevante for os.
-
Tilgængelighed: Informationen skal være tilgængelig for de spiders. Det vil sige, at hvis vi på en eller anden måde begrænser deres adgang med vilje eller ved en fejl, forhindrer vi dem i at kunne behandle alt indholdet og dermed i at forstå og i sidste ende klassificere det.
Den blokering eller begrænsning af sidens indhold kan ske på flere forskellige måder, som vi prøver at forklare længere nede i indlægget.
Crawlerne
Vi har talt om spiders, også kaldet crawlere eller bots. Vi kan definere dem som programmer, der analyserer dokumenterne på vores website, altså de er som »bibliotekarer«, der søger, klassificerer og organiserer. Deres hovedfunktion er derfor at bygge databaser. Der findes flere typer, alt efter hvilken slags information de samler. Lad os nævne nogle af de mest almindelige.
Googlebot: Den spider, der står for at crawle vores indhold og placere det i de organiske resultater (SERP'erne). For SEO-folk er den den vigtigste. Du kan følge præcis, hvordan den crawler dit site, i rapporten Crawlingstatistik i Google Search Console.
Inden for den type kan vi skelne mellem nogle undertyper:
-
Googlebot (smartphones): Mobilversionen
-
Googlebot (desktopversion): Desktopversionen
-
Googlebot Images: Står for at crawle billeder
-
Googlebot News: Til nyheder
-
Googlebot Video: Nu er det videoernes tur
Eksempel på en bot, vi har identificeret i vores logs:
Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/W.X.Y.Z‡ Mobile Safari/537.36 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
De er ikke de eneste — der er andre som Adsbot, Adsense og så videre. Nu hvor vi har nævnt dem, der er relevante for SEO-branchen, er det ikke den her artikels formål at skelne dem fra resten, men du kan finde mere information på følgende officielle link fra Google.
Faserne i Googles crawl- og indekseringsproces
Nu hvor vi ved, hvad crawling er, hvem der står for den funktion, og vi har gennemgået processen, så lad os se på den mere konkret.
Første fase: crawling og klassificering
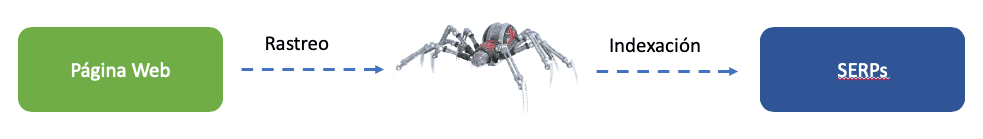
Processen, hvor vores sider dukker op i Googles resultater, går igennem en første fase med crawling, som vi har set, udført af de spiders (crawlere), så de læser, tolker, indekserer og klassificerer vores indhold.
Det er det nye ord, vi vil se nærmere på, klassificere. Google skal forstå vores indhold perfekt, enkelt og hurtigt, for som vi ser senere, bruger Google en bestemt mængde tid på vores website, og i den tid skal den »forstå« vores indhold og koble det til brugernes forskellige søgeintentioner.
Derfor hører man så ofte ordet »Search Intent« i moderne SEO, for Google tager det med i den klassificering, og det afgør den position, vores sider får i placeringerne i SERP'en.
Derfor skal crawl-processen være ren, enkel, hurtig, uden forhindringer og så videre, så alt er klart, og vi bliver klassificeret korrekt.
Anden fase: indeksering
Vi må ikke glemme indekseringsfasen, som kommer før klassificeringen og også spiller en grundlæggende rolle, for det er her, Google lægger vores indhold ind i sin database, altså indekserer det.
Sådan blokerer du Googles robotter
Vi nævnte tidligere, at der er måder, hvorpå vi kan komme til at begrænse de spiders' adgang til vores indhold. Til det findes der et element med afgørende vægt i SEO, kendt som robots.txt.
Filen robots.txt er en tekstfil, vi lægger op på vores server, hvor vi giver præcise instrukser til de forskellige spiders om at tillade eller blokere crawling af URL'er på vores site. Blokeringen kan lægges på:
-
hele domænet
-
en bestemt sti
-
en bestemt URL
-
eller en gruppe URL'er, der matcher et bestemt mønster.
Lad os se et eksempel på en opsætning af filen:
User-agent: *
Disallow: /wp-admin/
Allow: wp-admin/admin-ajax.php
Sitemap: /sitemap.xml
Som vi kan se, har den en første linje, hvor vi angiver user-agent (navnet på den crawler, vi vil blokere eller tillade, blandt dem vi så tidligere), efterfulgt af ordrerne »disallow« for at forbyde adgang eller »allow« for at tillade den.
I det konkrete tilfælde her siger vi med en * »alle crawlere«, uden undtagelse. Vi forbyder dem at gå ind i stien /wp-admin/, men inde i den sti vil vi gerne tillade dem at gå ind i /admin-ajax.php.
En forkert opsætning af filen kan gøre, at vi blokerer vigtige dele af vores indhold. Det er en klassisk fejl at have hele sitet blokeret, mens det bliver udviklet, og så glemme at fjerne blokeringen, når det sættes i produktion, så det bliver utilgængeligt for Google.
Et andet problem, Googles spiders kan løbe ind i, når de crawler vores indhold, er ikke at kunne følge de interne links, vi har på vores website, og dermed ikke få adgang til resten af URL'erne. Det sker, når vi bruger javascript-elementer i stedet for »href« i de links. Den praksis er meget udbredt, for JS har mange fordele for brugeren, men bruges det ikke korrekt og lægges oveni interne links, kan Google være ude af stand til at følge dem.
I SEO-verdenen kaldes det »link obfuscation«. Den dag i dag er det stadig til debat, om Google er i stand til at crawle og rendere sider lavet i JS korrekt.
Serverens svarkoder
For at blive ved med at forstå processen ordentligt kan vi ikke springe et begreb over, som SEO-folk har med at gøre dagligt, serverens svarkoder.
Tidligere så vi det kredsløb, hvor Google finder os, men hvordan sker det? En bruger laver en søgning (en forespørgsel) på Google. Søgemaskinen går i sin database og viser de mest relevante resultater (SERP'erne) ud fra den klassificering, der er lavet, for den søgning.
Når brugeren ser de forskellige resultater (visninger), klikker vedkommende på et af dem, det der efter vedkommendes vurdering passer bedst til behovet. I det øjeblik kommer Googles forespørgsel til den server, hvor sitet ligger, i spil, så den kan »servere« indholdet.
Når det sker, kommer serverens svar gennem den tilhørende kode. Lad os nævne de mest relevante, som vi som SEO-folk skal holde øje med:
-
200: Den svarkode er den, der fortæller Google, at siden findes, at den har indhold, og at der ikke er noget problem i at vise den. Den er den mest ønskede blandt SEO-folk, så længe indholdet på den side med kode 200 er optimalt.
-
30x: Familien af 30x-statuskoder dækker redirects. De vigtigste er 301 (permanent), 302 og 307 (midlertidige). Grundlæggende siger de til Google »hey, den URL A, du har bedt om, er ikke den her længere, det er den anden URL B«. Der er flere, men de hører ikke til det begreb, vi udfolder her. Det er vigtigt at vide, at vi som SEO-folk foretrækker 301, der overfører al autoriteten.
Anbefalet læsning: Guide til 301-redirects
-
40X: Fejlkoder. De mindst ønskede blandt SEO-folk. Den mest almindelige er den berømte 404. Når den kode dukker op, fortæller vi Google som svar på dens forespørgsel efter en URL, at den ikke findes længere og derfor er en fejl.
-
410: Den har vi villet trække frem fra 40x-familien for dens SEO-værdi. Når vi bruger den kode som svar på en forespørgsel fra Googles server efter en URL, fortæller vi den, at den er »væk for altid«. Det er interessant, fordi Google i modsætning til 404 forstår, at den aldrig kommer igen, og holder op med at prøve at crawle den, mens den med 404 crawler den igen i troen på, at vi måske vil rette op på det.
-
50x: Den type svar hænger sammen med serverfejl. Når vores maskine fejler af en eller anden grund, og Google prøver at bede os om indholdet på en URL, returnerer serveren en 505-statuskode, hvis den fejler.
Crawl budget
På det her sted i indlægget mangler vi stadig at tage fat på et begreb, der blev populært i SEO-verdenen for et par år siden, kendt som crawl budget.
Crawl budget er den tid, Googles spiders bruger på at crawle et website og alle dets URL'er. Det er, som vi sagde tidligere, en endelig mængde tid. Derfor er det vigtigt at have sit website optimeret, så det bliver lettere for den at nå de mest relevante sider på vores site i den tid.
Den tid, crawlerne bruger på at gå gennem vores website, er ikke en fast størrelse, den vokser eller falder alt efter ting som, hvor ofte vi opdaterer indholdet, hvor stor autoritet vores domæne har (popularitet) og så videre.
Jo højere kvalitet vores website har, jo større autoritet og jo mere friskt indhold, jo mere relevante regner Google os for, og jo mere budget afsætter den til at crawle os.
Med crawl-programmer som Screaming Frog laver vi crawls af vores website under ideelle forhold, altså som om de spiders havde al tid i verden til at gå gennem hver eneste af vores URL'er.
Men sådan fungerer det ikke, når vi taler om Googlebot — snarere vil Google hver gang, den besøger vores website, besøge nogle URL'er mere end andre. Faktisk kan der være nogle, den slet ikke besøger. Det analyserer vi med det, der kaldes serverlogs (registreringer af, hvilke URL'er Google har crawlet, hvor ofte den har gjort det og hvor mange gange i en given periode).
Så langt hele analysen af, hvad crawling er, og de forskellige elementer, der indgår i Googles crawl-system.
Spørgsmål eller forslag? Som altid... vi hører gerne fra dig!
Forfatter: David Kaufmann

Jeg har brugt de sidste 10+ år fuldstændig opslugt af SEO — og helt ærligt: jeg ville ikke have det anderledes.
Min karriere rykkede et niveau op, da jeg arbejdede som senior SEO-specialist for Chess.com — et af de 100 mest besøgte websites på hele internettet. At arbejde i den skala, på tværs af millioner af sider, snesevis af sprog og en af de mest konkurrenceprægede SERP'er der findes, lærte mig ting, som intet kursus og ingen certificering kunne have lært mig. Den erfaring ændrede mit syn på, hvordan rigtig godt SEO ser ud — og den blev fundamentet for alt, hvad jeg har bygget siden.
Ud af det grundlagde jeg SEO Alive — et bureau for brands, der mener det alvorligt med organisk vækst. Vi er ikke her for at sælge dashboards og månedsrapporter. Vi er her for at bygge strategier, der rent faktisk flytter noget, og vi kombinerer det bedste fra klassisk SEO med den spændende nye verden inden for Generative Engine Optimization (GEO) — så dit brand ikke kun dukker op i Googles blå links, men også inde i de AI-genererede svar, som ChatGPT, Perplexity og Google AI Overviews leverer til millioner af mennesker hver eneste dag.
Og fordi jeg ikke kunne finde et værktøj, der håndterede begge verdener ordentligt, byggede jeg selv et — SEOcrawl AI, en enterprise-platform til SEO-intelligens, der samler placeringer, tekniske audits, backlink-overvågning, crawl-sundhed og tracking af brandets synlighed i AI ét sted. Det er den platform, jeg altid ønskede fandtes.
Find mere indhold fra denne forfatter