Hvad er query fan-out? AI-søgeteknikken, der ændrer hvordan indhold bliver fundet
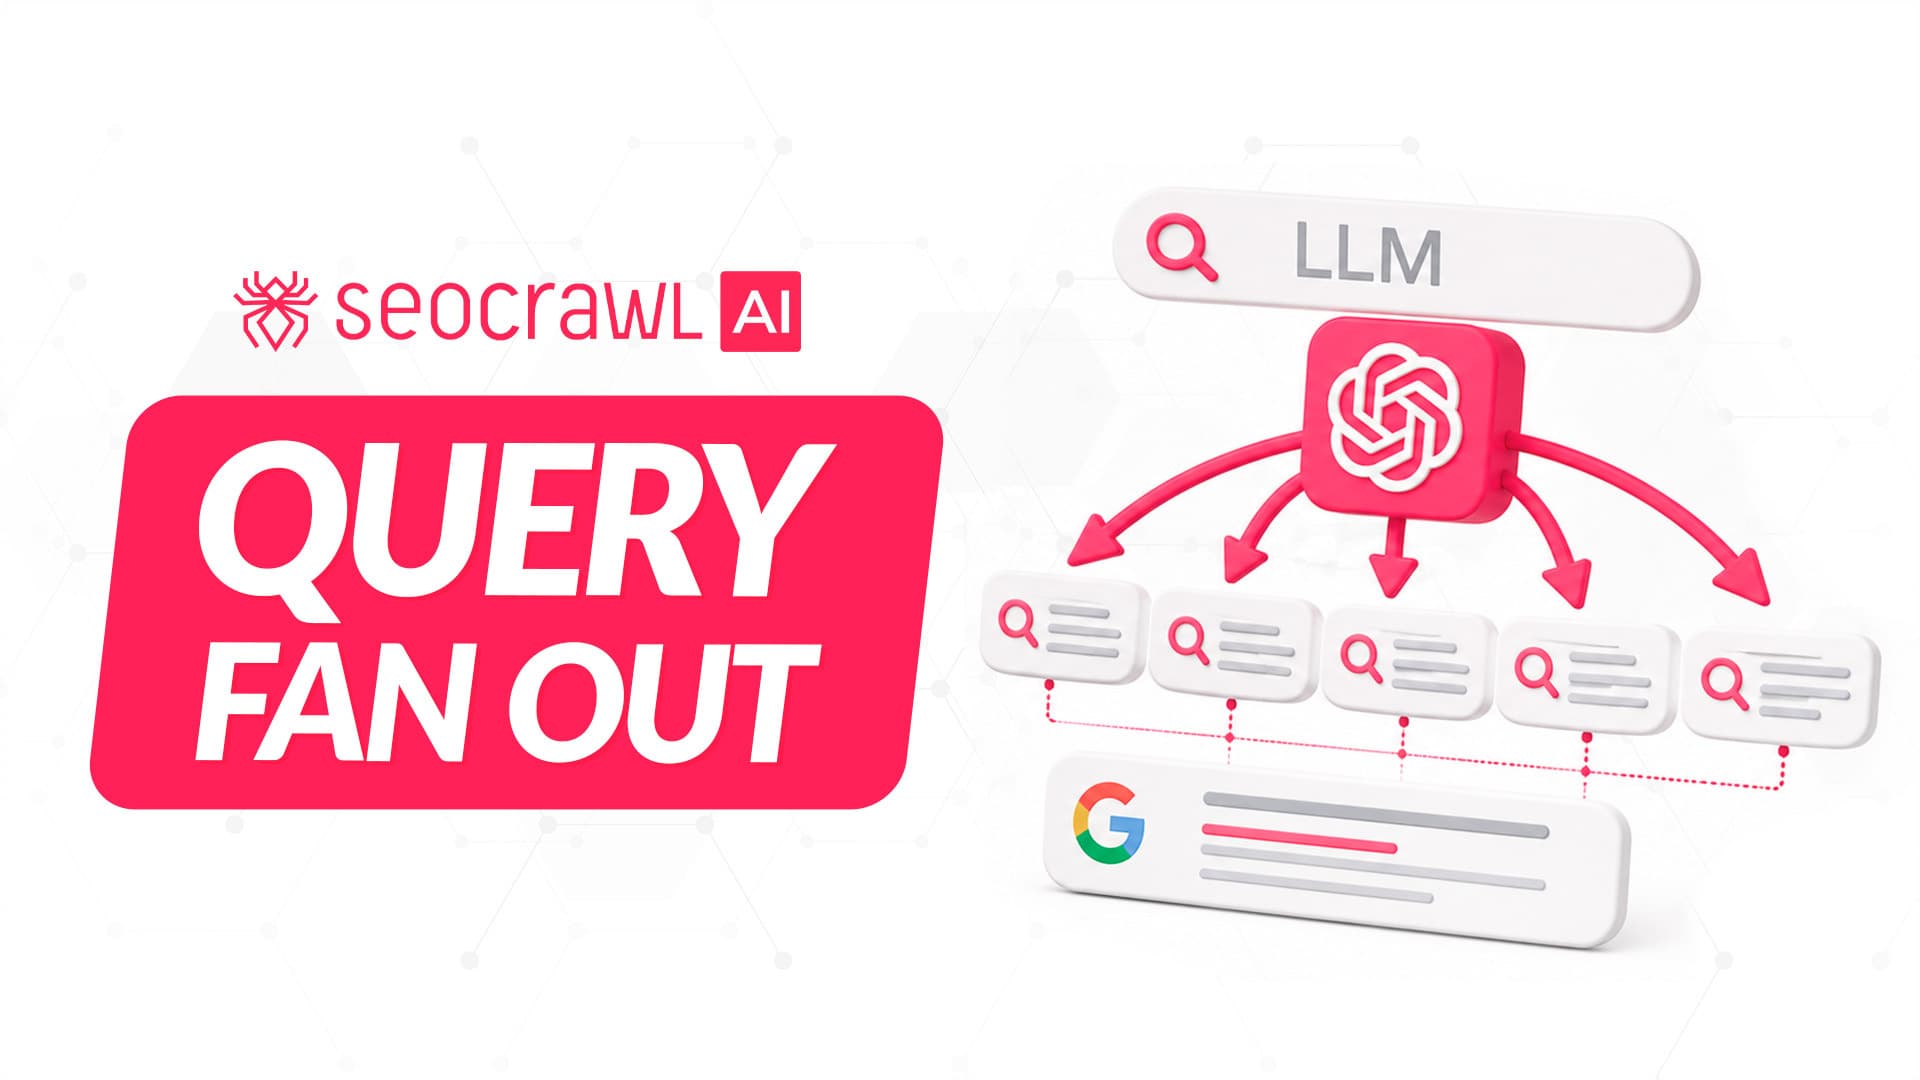
Query fan-out er den AI-søgeteknik, der gør én brugerprompt til snesevis (og nogle gange hundredvis) af parallelle delsøgninger, som hver henter forskellige facetter af et svar, før en LLM syntetiserer dem til ét svar.
Metoden driver Googles AI Mode, ChatGPT og Perplexity, og den afgør, hvilket indhold der bliver vist og citeret. At forstå, hvordan fan-out fungerer, er nu en forudsætning for enhver SEO- eller indholdsstrategi, der er bygget til AI-søgningens tid.
Hvad er query fan-out?
Når du stiller en model et spørgsmål, tager AI-søgesystemet det og udvider det til flere parallelle delsøgninger. Hvert af de spørgsmål går så ud og henter bestemt information, og det endelige svar, du ser, er en syntese af alt det, der kom tilbage.
Ordet vandt frem i 2024-2025, da Google begyndte at rulle AI Mode ud. Ingeniører og SEO'er gik i gang med at reverse-engineere, hvordan det virkede, og det, de fandt, var ikke helt nyt. Traditionel query expansion har eksisteret i årtier (at lægge synonymer eller beslægtede ord til én søgning), men query fan-out er kategorisk anderledes. Den ændrer ikke en søgning — den erstatter den med mange uafhængige, der kører samtidig.

Sådan virker det, trin for trin
Pipelinen bag query fan-out har fire klare trin. Hvert af dem betyder noget, for hvert af dem er et sted, hvor dit indhold enten kommer med eller bliver sprunget helt over.

Trin 1: Nedbrydning
AI'en læser brugerens prompt og finder hvert eneste eksplicitte og implicitte behov i den.
En prompt som »bedste projektstyringsværktøj til distribuerede teams« beder ikke bare om en produktanbefaling. Den spørger også implicit til samarbejdsfunktioner, priser, integrationer, brugeranmeldelser og sammenligninger med alternativer. Systemet trækker dem alle ud som separate hentemål.
Trin 2: Parallel hentning
Hver delsøgning går ud samtidig for at hente relevante kilder. Det er selve »fan-out«-øjeblikket: i stedet for en lineær søgning kører systemet mange søgninger parallelt. Det sker på millisekunder.
Trin 3: Samling af kilder
Resultaterne fra hver delsøgning kommer tilbage og bliver puljet. Systemet vurderer, hvilke kilder der har autoritet, hvilke der er overflødige, og hvilke der dækker vinkler, de andre missede.
Trin 4: Syntese
LLM'en tager den samlede pulje af kilder og sætter det endelige svar sammen. Det er her, dit indhold enten bliver citeret eller forsvinder. At blive udeladt betyder ikke, at dit indhold rangerede dårligt — det betyder, at det ikke dækkede nok af spektret af delsøgninger til at overleve samlingen.
Fan-out på tværs af platforme
Ikke alle platforme laver query fan-out på samme måde. Omfanget, hastigheden og typerne af delsøgninger er markant forskellige i Google, ChatGPT og Perplexity.
| Platform | Fan-out-omfang | Adfærd |
|---|---|---|
| Google AI Mode | Mest aggressiv — rapporteret at sætte snesevis til hundredvis af delsøgninger i gang | Bryder dybt ned i beslægtede, implicitte og sammenlignende vinkler og syntetiserer så med links |
| ChatGPT (search) | Moderat | Omformulerer og udvider prompten, kører websøgning og citerer et afgrænset sæt kilder |
| Perplexity | Fokuseret | Deler prompten op i et mindre sæt målrettede delsøgninger, optimeret til hurtige svar med mange citater |
Pointen er ikke det præcise antal på en given platform — de tal flytter sig. Pointen er, at de alle bryder din prompt ned, før de svarer, så en side, der kun tager fat i det bogstavelige spørgsmål, kæmper fra en dårlig position.
Typer af delsøgninger, der bliver genereret
At forstå, hvilke typer delsøgninger dit indhold dækker (og hvilke det ikke gør), er udgangspunktet for enhver fan-out-optimering.
| Type delsøgning | Hvad den henter | Eksempel (fra »bedste CRM til startups«) |
|---|---|---|
| Omformuleringer | Samme hensigt, skrevet om med synonymer | »bedste CRM-software til virksomheder i tidlig fase« |
| Beslægtede | Tilstødende emner, brugeren sandsynligvis går op i | »CRM-priser til små teams« |
| Sammenlignende | Head-to-head og alternative vinkler | »HubSpot vs. Pipedrive til startups« |
| Implicitte | Uudtalte behov, der ligger i prompten | »CRM med gratis niveau og nem onboarding« |
| Aktualitet | Frisk eller tidsfølsom information | »bedste startup-CRM'er i 2026« |
| Entitetsudvidelse | Bestemte produkter, funktioner eller navne | »CRM-integrationer med Slack og Gmail« |
De to, der oftest bliver misset, er sammenlignende og implicitte delsøgninger — de fleste indholdsteams optimerer til det stillede spørgsmål og ignorerer det uudtalte.
Hvorfor query fan-out betyder noget for SEO
Query fan-out påvirker ikke de traditionelle Google-placeringer direkte. Din placering blandt de blå links bliver afgjort af de samme signaler som altid. Det, fan-out ændrer, er, om du bliver citeret inde i et AI-genereret svar.
- Citatproblemet. En side kan ligge nr. 1 på et keyword og alligevel aldrig dukke op i et AI-svar, hvis den kun dækker én type delsøgning.
- LLM-usynlighed. Det er fænomenet, hvor en side rangerer i traditionel søgning, men aldrig bliver citeret i AI-svar. Fan-out øger risikoen: jo flere delsøgninger en prompt genererer, jo flere vinkler skal dit indhold dække.
- Trafikeffekten. AI Overviews og AI Mode-svar sænker klikraten på de søgninger, hvor de dukker op. Bliver dit indhold ikke citeret inde i de svar, mister du synlighed på begge niveauer — usynlig i AI-svaret og færre klik fra søgeresultaterne nedenunder.
Sådan måler du det
Almindelige rank trackere fanger slet ikke fan-out-visning. De kan måle din placering i søgeresultaterne, men de misser, om du kommer med i AI-syntetiserede svar.
Værktøjer, der er bygget specifikt til at overvåge AI-søgning — som SEOcrawl AI's AI Tracker og Prompt Tracking — måler brandomtaler, citatrate og share of voice på tværs af ChatGPT, Claude, Gemini og Perplexity. Det er de tal, der fortæller dig, om dit indhold overlever fan-out-samlingen.
Sådan optimerer du dit indhold til query fan-out (7 tips)
Traditionel SEO optimerer én side til ét keyword. Fan-out-optimering betyder, at du dækker hele det spektrum af delsøgninger, en prompt sandsynligvis genererer.
- Kortlæg indholdet mod hele spektret af delsøgninger. Før du skriver eller opdaterer noget, så spørg: hvad er alle de implicitte, beslægtede, sammenlignende og købsnære spørgsmål, en person med den prompt kan have? Det er de afsnit, du skal bygge.
- Byg dybde i emnet, ikke kun bredde. En AI, der samler resultater, foretrækker en kilde, der går i dybden med én vinkel, frem for en, der rører overfladisk ved alle vinkler.
- Strukturér indholdet, så AI kan trække selvstændige svar ud. Hvert afsnit skal kunne stå alene som svar på et bestemt spørgsmål. Tydelige H2'er og H3'er, korte åbningssætninger i hvert afsnit og FAQ-agtig opsætning hjælper alle AI-systemerne med at hente rene uddrag under samlingen.
- Styrk dine E-E-A-T-signaler. Under samlingen vurderer AI'en autoritet. Forfatterens kvalifikationer, originale data, primære kilder og klare redaktionelle standarder er alle med til at afgøre, om dit indhold overlever.
- Brug FAQ og strukturerede data. FAQ-schema er et af de klareste signaler om, at et stykke indhold er lavet til at svare på bestemte spørgsmål — præcis det, fan-out-hentningen leder efter.
- Forudse sammenlignende og implicitte delsøgninger. De bliver oftest misset. Byg sammenligningsafsnit ind, også på sider der ikke udtrykkeligt handler om sammenligninger, og tag fat i indvendinger, alternativer og grænsetilfælde.
- Brug det også på dine egne prompts. Bygger du AI-agenter eller agentiske workflows, ændrer forståelsen af fan-out måden, du skriver master-prompts på. En prompt, der forudser sin egen nedbrydning (og selv deler opgaven op i delopgaver på forhånd), henter bedre resultater end en, der overlader al nedbrydning til modellen.
Vil du have den større ramme omkring det hele, dækker vores guide til generative engine optimization, hvordan fan-out passer ind i det bredere skift fra SEO til GEO.
FAQ
Hvad er query fan-out i AI-søgning?
Query fan-out er den proces, hvor et AI-system udvider én brugerprompt til flere parallelle delsøgninger for at hente omfattende information. Det bruges af Google AI Mode, ChatGPT og Perplexity.
Hvor mange delsøgninger genererer query fan-out?
Det varierer med platform og promptens kompleksitet, fra en håndfuld til snesevis eller hundredvis, der kører samtidig. Google AI Mode er bredt rapporteret at have den mest aggressive fan-out af de store AI-systemer.
Påvirker query fan-out de traditionelle SEO-placeringer?
Ikke direkte. Fan-out påvirker, om du kommer med og bliver citeret i AI-svar, ikke de klassiske blå links. Men færre klik fra AI-svar rammer den organiske trafik på de berørte søgninger.
Hvordan optimerer jeg mit indhold til query fan-out?
Byg omfattende dækning af emnet, forudse implicitte og sammenlignende delsøgninger, brug strukturerede data og styrk dine E-E-A-T-signaler, så dit indhold bliver citeret på tværs af flere typer delsøgninger.
Hvad er LLM-usynlighed?
Fænomenet, hvor en side rangerer godt i traditionel søgning, men aldrig bliver citeret i AI-genererede svar. Fan-out øger risikoen, fordi indholdet skal dække et bredere spænd af delsøgninger for at komme med i det syntetiserede svar.
Er query fan-out det samme som query expansion?
Nej. Traditionel query expansion lægger synonymer eller beslægtede ord til én søgning. Query fan-out laver helt separate, parallelle delsøgninger, der hver især hentes og syntetiseres uafhængigt.
Gælder query fan-out uden for søgning?
Ja. I agentiske AI-workflows bliver en master-prompt på samme måde delt op i delopgaver. At forstå fan-out er relevant for udviklere og AI-produktteams, ikke kun for SEO'er.
Forfatter: David Kaufmann

Jeg har brugt de sidste 10+ år fuldstændig opslugt af SEO — og helt ærligt: jeg ville ikke have det anderledes.
Min karriere rykkede et niveau op, da jeg arbejdede som senior SEO-specialist for Chess.com — et af de 100 mest besøgte websites på hele internettet. At arbejde i den skala, på tværs af millioner af sider, snesevis af sprog og en af de mest konkurrenceprægede SERP'er der findes, lærte mig ting, som intet kursus og ingen certificering kunne have lært mig. Den erfaring ændrede mit syn på, hvordan rigtig godt SEO ser ud — og den blev fundamentet for alt, hvad jeg har bygget siden.
Ud af det grundlagde jeg SEO Alive — et bureau for brands, der mener det alvorligt med organisk vækst. Vi er ikke her for at sælge dashboards og månedsrapporter. Vi er her for at bygge strategier, der rent faktisk flytter noget, og vi kombinerer det bedste fra klassisk SEO med den spændende nye verden inden for Generative Engine Optimization (GEO) — så dit brand ikke kun dukker op i Googles blå links, men også inde i de AI-genererede svar, som ChatGPT, Perplexity og Google AI Overviews leverer til millioner af mennesker hver eneste dag.
Og fordi jeg ikke kunne finde et værktøj, der håndterede begge verdener ordentligt, byggede jeg selv et — SEOcrawl AI, en enterprise-platform til SEO-intelligens, der samler placeringer, tekniske audits, backlink-overvågning, crawl-sundhed og tracking af brandets synlighed i AI ét sted. Det er den platform, jeg altid ønskede fandtes.
Find mere indhold fra denne forfatter