Sådan bliver du citeret i Perplexity (det virker ikke som Google)
At »rangere« i Perplexity er et umuligt mål, for Perplexity rangerer i virkeligheden ikke noget. Modellen besvarer et spørgsmål og viser dig derefter den håndfuld sider, den har hentet svaret fra.
Det er citeringerne, og at komme med på den korte liste er hele spillet. De fleste svar viser tre til otte af dem, og hver enkelt er et klikbart link.
Så det at »rangere i Perplexity« er grundlæggende noget andet end at kravle op ad en resultatside, og råd, der lyder som genbrugte Google-taktikker fra 2019, hjælper dig ikke med at rykke noget. Denne guide gennemgår, hvordan Perplexity vælger sine kilder, de indholdsmæssige og tekniske ændringer der flytter din andel af citeringer, og hvordan du tjekker, om noget af det virker.
Sådan fungerer Perplexity reelt (og hvorfor Google-vaner kun bringer dig halvvejs)
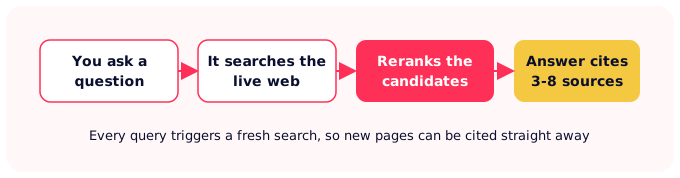
Perplexity kører på retrieval-augmented generation. I stedet for at svare ud fra et frosset træningssnapshot søger den på det levende web ved hver forespørgsel, samler kandidatsider og skriver først derefter et svar, der citerer de sider, den brugte. Derfor kan friskt, velstruktureret indhold dukke op i dens svar næsten med det samme, uden nogen træningscyklus at vente på.
Hvem bliver citeret?
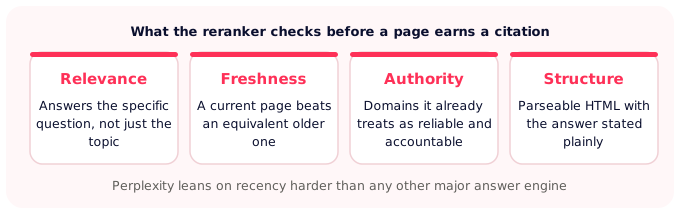
Retrieval er ikke ét trin. Kandidatsiderne går gennem en reranking-pipeline, der tjekker et par ting, før nogen af dem fortjener en citering:
- Relevans: besvarer siden det konkrete spørgsmål, ikke bare nævner emnet.
- Friskhed: Perplexity læner sig hårdere op ad friskhed end nogen anden større svarmotor, så en aktuel side slår typisk en tilsvarende ældre på samme forespørgsel.
- Autoritet: den favoriserer domæner, den allerede behandler som pålidelige, den slags med navngivne forfattere og redaktionelt ansvar.
- Struktur: ren, parsebar HTML med svaret sagt ligeud, ikke begravet tre skærmbilleder nede.
Hvad leder Perplexity efter?
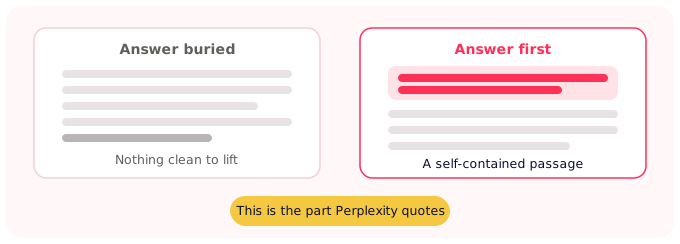
Perplexity jagter den konkrete sætning eller det afsnit, der besvarer spørgsmålet, og krediterer det derefter. Optimerer du en hel side som én udifferentieret klump, giver du modellen ikke noget rent at løfte. Skriv i selvbærende afsnit, der hver især giver mening alene.
Trin til at omarbejde dit indhold til Perplexity
Den klart mest nyttige vane er at lægge svaret i den første sætning eller to og så forklare.
1. Start med svaret
Sig det ligeud i toppen: definitionen, tallet, ja eller nej. Gem konteksten, forbeholdene og farven til bagefter. Kan en læser (eller en model) fange pointen af dine første linjer, har du klaret den sværeste del.
2. Giv den en struktur, den kan parse
Beskrivende overskrifter, korte afsnit, lister hvor en liste giver mening, og tabeller til sammenligninger. En ryddelig FAQ-blok eller en definition på én linje er præcis den form, Perplexity kan lide at citere. Struktur er ikke pynt her; det er sådan, modellen finder svaret inde i din side.
3. Gå efter long tail-forespørgsler formet som spørgsmål
Perplexitys brugere hælder mod konkrete spørgsmål i researchstil frem for enkeltord. Skriv dine overskrifter som de spørgsmål, folk faktisk taster.
Tekniske grundregler (så PerplexityBot kan læse dig)
Intet af indholdsarbejdet betyder noget, hvis Perplexity slet ikke kan hente dine sider.
Luk de rigtige crawlere ind
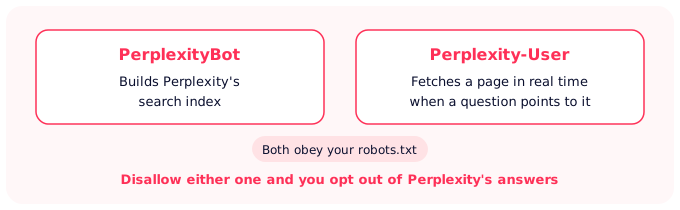
Perplexity bruger to user agents: PerplexityBot, der bygger dens søgeindeks, og Perplexity-User, der henter en side i realtid, når nogens spørgsmål peger på den. Begge læser de robots.txt-regler, du sætter, og Perplexity lister de præcise tags i sin officielle crawlerdokumentation.
Disallower du bare den ene, melder du dig ud af dens svar, så en hurtig gennemgang af din robots.txt for en forvildet regel er værd at tage, før du gør noget andet.
Gør siderne hurtige og crawlbare
Almindelig teknisk SEO tæller stadig. En side, der er indekseret, hurtig at loade og fri for forvirring om dubleret indhold, er lettere for enhver crawler at behandle og lettere for Perplexity at stole på. Hold dit sitemap opdateret, så nye sider bliver fundet hurtigt i stedet for at ligge uset i ugevis.
Tilføj strukturerede data
Schema markup (Article, FAQPage, HowTo) hjælper Perplexity med at parse, hvad hver del af din side skal. Det er et støttende signal snarere end en magisk kontakt, men det er billigt at tilføje, og det fjerner tvetydighed. Starter du fra bunden, dækker vores guide til strukturerede data til SEO, hvilke typer der er indsatsen værd.
Hold indholdet friskt
Perplexity vægter friskhed, så at opdatere og genudgive sider, der stadig er relevante, er noget af det, der giver mest. En reelt opdateret guide, ikke en ændret dato, kan komme ind i svarene igen hurtigt, og det belønner teams, der vedligeholder deres bedste indhold i stedet for at udgive og glemme.
Byg den autoritet, Perplexity allerede stoler på
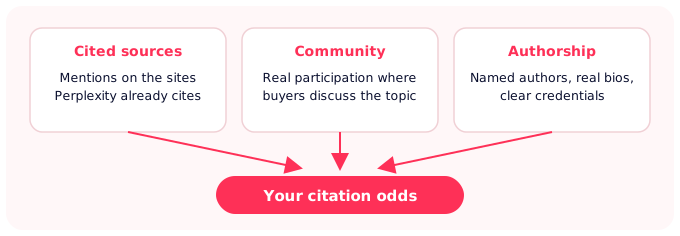
Perplexity griber efter domæner, den genkender som troværdige, så en god del af dine odds for at blive citeret afgøres uden for dit eget site. Det aftryk uden for sitet er det samme, der driver AI-brandsynlighed på tværs af alle svarmotorer, ikke kun denne.
Fortjen omtaler på kilder, den allerede citerer
Henvisninger og placeringer på etablerede sites med redaktionelt ansvar løfter din status hos rerankeren. At blive citeret af de sider, Perplexity citerer, går langsommere end arbejdet på siden, men det akkumulerer, og det er svært for en konkurrent at kopiere hurtigt.
Vær med i samtalen i communitet
Communityplatforme, Reddit i særdeleshed, dukker ofte op i Perplexitys svar på spørgsmål om holdninger og anbefalinger. Reel, ikke-promoverende deltagelse de steder, hvor dine købere allerede diskuterer emnet, kan placere dig foran retrieveren på en måde, en landingsside aldrig kan.
Gør dit forfatterskab synligt
Navngivne forfattere, rigtige bios og klare meritter giver rerankeren de signaler om erfaring og ekspertise, den leder efter. En anonym side, der konkurrerer mod en med en krediteret ekspert, taber typisk pladsen.
De fejl, der holder dig ude af svaret
Vi har været inde på nogle af dem undervejs i artiklen, men her er en hurtig liste til at skimme, før du taber flere citeringer:
- At blokere PerplexityBot eller Perplexity-User i robots.txt, som regel ved et uheld.
- At begrave svaret under en lang intro eller bag en betalingsmur, crawleren ikke kommer forbi.
- Tyndt eller generisk indhold, der ikke tilføjer noget, de allerede citerede kilder ikke siger.
- Ingen reel struktur: ingen klare overskrifter, ingen lister, én lang mur af tekst.
- At jagte brede termer i stedet for de konkrete spørgsmål, Perplexitys brugere faktisk stiller.
Sådan finder du ud af, om Perplexity rent faktisk citerer dig
Du kan køre dine spørgsmål i Perplexity, læse kildepanelet og se, om dit domæne dukker op. Tjek derefter GA4 for henvisningstrafik fra perplexity.ai. Den manuelle metode virker, men den giver et øjebliksbillede, der ikke skalerer, og den overser de omtaler, der aldrig får et klik. Det er det samme hul, der gør monitorering af AI-søgning til en tilbagevendende opgave frem for en engangsaudit.
SEOcrawl AI gør den engangsaudit til et levende signal. Vores Perplexity prompt tracking kører dine prompts efter en tidsplan og logger hver eneste URL, Perplexity citerer, hver enkelt gemt med sin fulde prompt og et tidsstempel, så du kan afspille et svar fra uger tilbage og se, hvordan kilderne har flyttet sig.
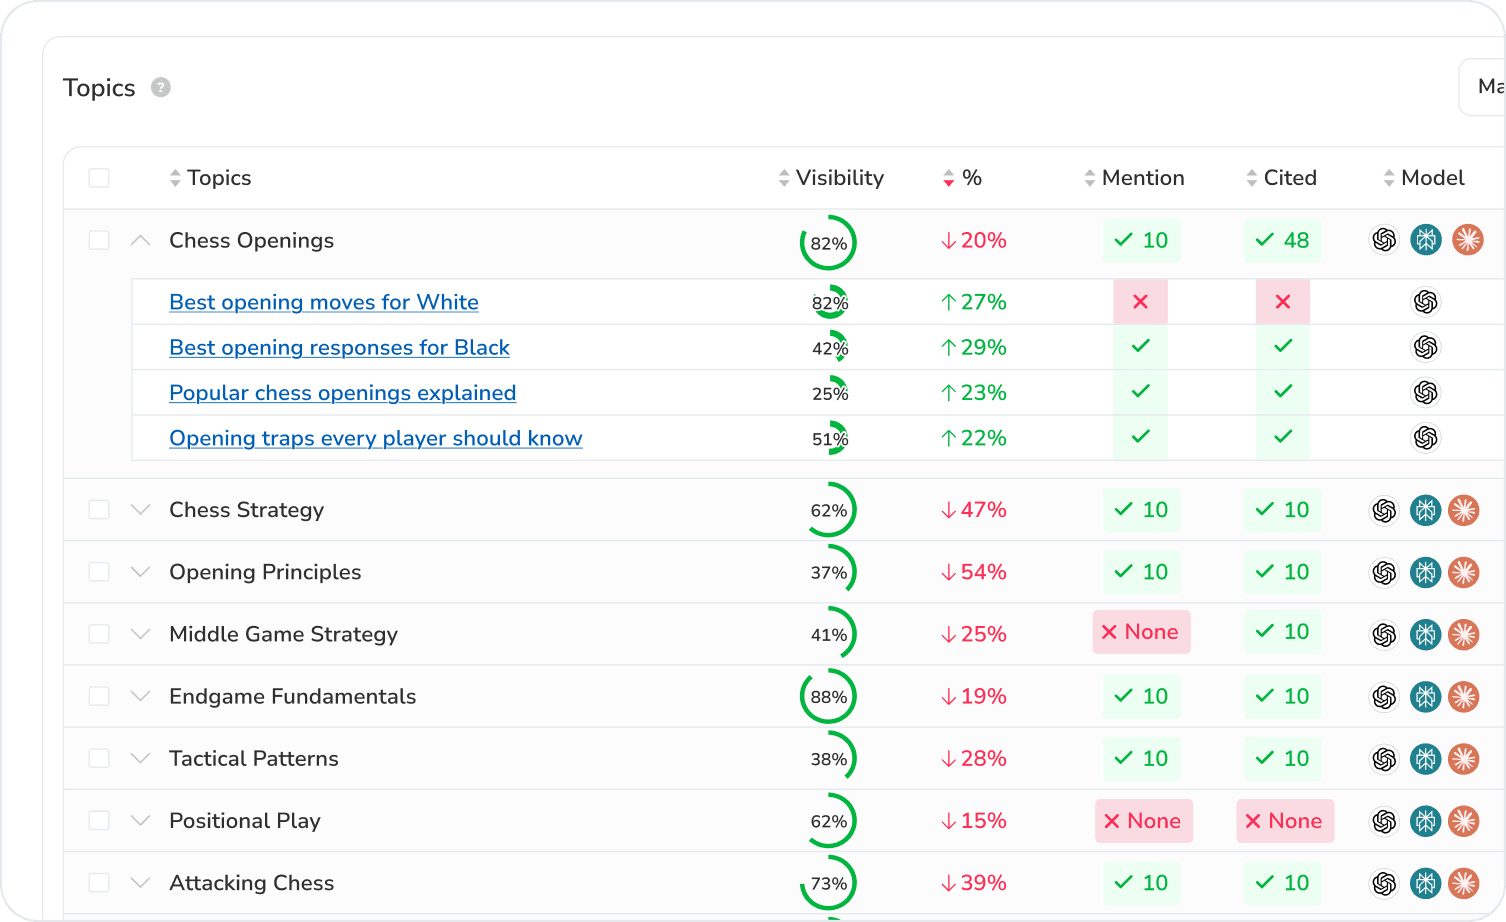
På samme skærm ser du din andel af citeringer op mod de konkurrenter, der betyder noget, og præcis hvilke konkurrent-URL'er Perplexity sender dine købere til i stedet for til dig.
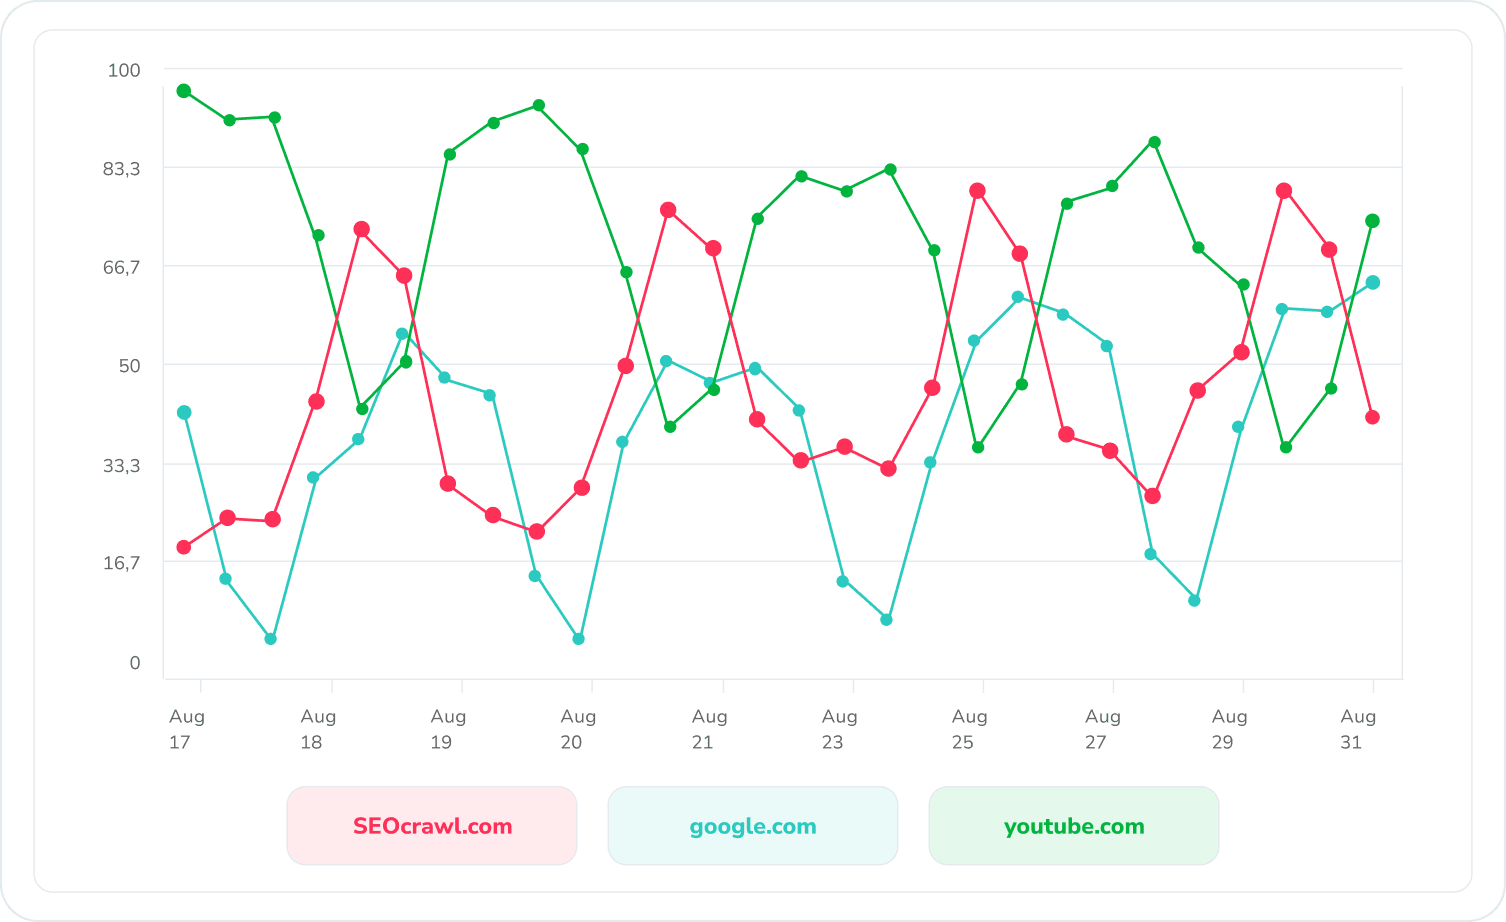
I det øjeblik dit brand falder ud af et svar, eller en konkurrents andel af citeringer stiger, får du en alarm samme dag, det sker, ikke ved månedens gennemgang.
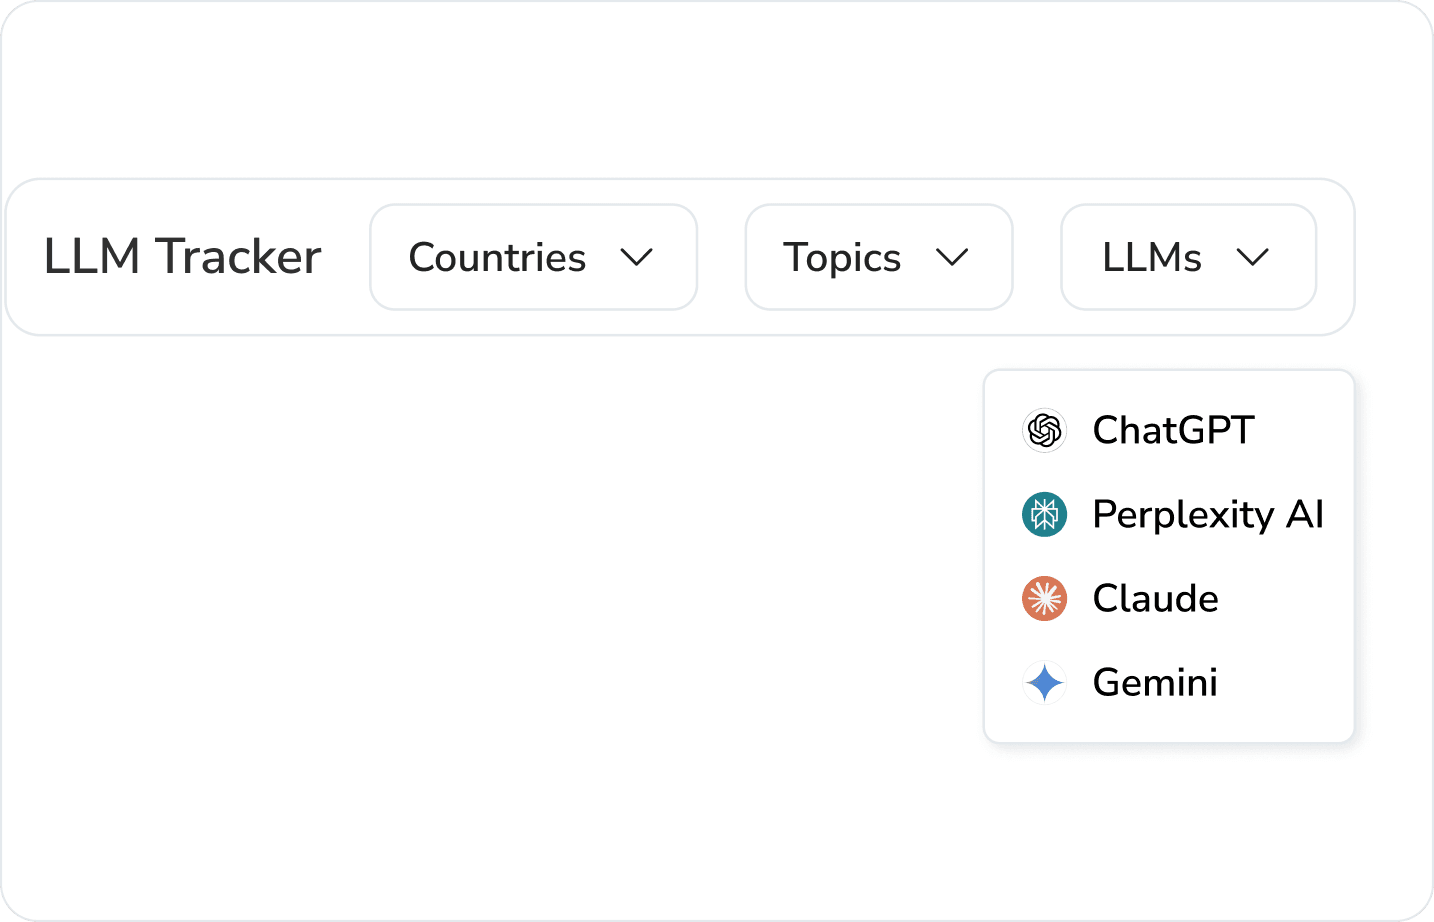
Slå det samme promptsæt til på tværs af Perplexity, ChatGPT, Claude og Gemini for at finde de svar, hvor den ene motor allerede citerer dig, og den anden ikke gør.
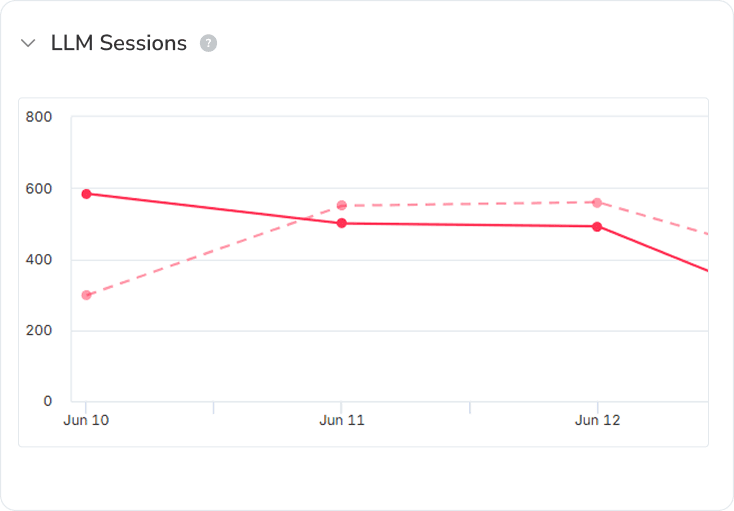
AI Tracker kobler derefter de omtaler til rigtige GA4-sessioner og konverteringer, så du besvarer begge spørgsmål på én gang: er jeg med i svaret, og sender det trafik?
FAQ
Hjælper traditionel SEO stadig med at rangere i Perplexity?
Delvist. Crawlbarhed, domæneautoritet og backlinks tæller stadig, for Perplexity henter fra det levende web. Det nye er vægten på svaret først, struktur den kan udtrække, og friskhed. Betragt solid SEO som fundamentet, og læg GEO-taktikker oven på.
Hvordan beslutter Perplexity, hvilke kilder den citerer?
Den henter kandidatsider til dit spørgsmål og rangerer dem derefter på relevans, friskhed, autoritet og struktur, før den skriver et svar, der citerer dem, den brugte. Sider, der siger svaret ligeud og kommer fra betroede domæner, har de bedste odds.
Kan jeg forhindre Perplexity i at crawle mit site?
Ja. Du kan disallowe PerplexityBot og Perplexity-User i robots.txt efter de tags, der står på Perplexitys officielle crawlerside. Prisen er, at du samtidig fjerner dig selv fra dens svar.
Hvor lang tid går der, før man bliver citeret efter udgivelsen?
Der er ingen fast tidsplan. Det afhænger af, hvor hurtigt Perplexity crawler siden, og om dit indhold slår de kilder, den citerer i dag. Et opdateret sitemap plus reelt friskt, velstruktureret indhold forkorter ventetiden.
Hjælper schema markup?
Det hjælper Perplexity med at parse dit indholds struktur og hensigt, og det understøtter citering, selvom det ikke i sig selv er en garanteret rangeringsfaktor. FAQPage, Article og HowTo er de brugbare typer for de fleste sider.
Er det at rangere i Perplexity det samme som i ChatGPT eller Googles AI Overviews?
Principperne overlapper (autoritet, struktur, troværdigt forfatterskab), men hver motor henter kilder forskelligt. ChatGPT læner sig for eksempel op ad Bings indeks, og derfor har det at rangere i ChatGPT sin egen tjekliste. Én samlet GEO-tilgang forbedrer dine odds på tværs af dem alle, og det er mere effektivt end at optimere til én motor ad gangen.
Hvilken slags indhold bliver citeret mest i Perplexity?
Direkte how-to-guides, klare definitioner, sammenligningssider og FAQ-rigt indhold, især alt der besvarer et konkret spørgsmål i de første linjer.
Hvordan tjekker jeg, om Perplexity citerer mig?
Søg på dine målspørgsmål i Perplexity, og se efter dit domæne i kildepanelet, og bekræft derefter henvisningstrafikken i GA4. Vil du følge det løbende på tværs af prompts og konkurrenter, så brug et prompt tracking-værktøj som SEOcrawl AI's Perplexity-tracker. Den samme tilgang virker for ChatGPT-brandomtaler og enhver anden motor, du går op i.
Forfatter: David Kaufmann

Jeg har brugt de sidste 10+ år fuldstændig opslugt af SEO — og helt ærligt: jeg ville ikke have det anderledes.
Min karriere rykkede et niveau op, da jeg arbejdede som senior SEO-specialist for Chess.com — et af de 100 mest besøgte websites på hele internettet. At arbejde i den skala, på tværs af millioner af sider, snesevis af sprog og en af de mest konkurrenceprægede SERP'er der findes, lærte mig ting, som intet kursus og ingen certificering kunne have lært mig. Den erfaring ændrede mit syn på, hvordan rigtig godt SEO ser ud — og den blev fundamentet for alt, hvad jeg har bygget siden.
Ud af det grundlagde jeg SEO Alive — et bureau for brands, der mener det alvorligt med organisk vækst. Vi er ikke her for at sælge dashboards og månedsrapporter. Vi er her for at bygge strategier, der rent faktisk flytter noget, og vi kombinerer det bedste fra klassisk SEO med den spændende nye verden inden for Generative Engine Optimization (GEO) — så dit brand ikke kun dukker op i Googles blå links, men også inde i de AI-genererede svar, som ChatGPT, Perplexity og Google AI Overviews leverer til millioner af mennesker hver eneste dag.
Og fordi jeg ikke kunne finde et værktøj, der håndterede begge verdener ordentligt, byggede jeg selv et — SEOcrawl AI, en enterprise-platform til SEO-intelligens, der samler placeringer, tekniske audits, backlink-overvågning, crawl-sundhed og tracking af brandets synlighed i AI ét sted. Det er den platform, jeg altid ønskede fandtes.
Find mere indhold fra denne forfatter