'noindex' etiketiyle hariç tutuldu: Ne anlama gelir ve nasıl düzeltilir?
Google Search Console'u açtınız, "'noindex' etiketiyle hariç tutuldu" olarak işaretlenmiş bir grup URL gördünüz ve şimdi bu sayfalar aramada görünmüyor.
Google Search Console'da "'noindex' etiketiyle hariç tutuldu" olarak etiketlenmiş bir grup URL gördüyseniz, sayfalarınız bilerek Google dizininin dışında tutuluyor ve çözüm genellikle göründüğünden daha basittir: yönergeyi bulun, kaldırın ve Google'dan yeniden taramasını isteyin.
Bu rehber, bu duruma tam olarak neyin yol açtığını, buna neden olan noindex yönergesini nasıl tespit edeceğinizi ve sayfalarınızın yeniden sıralanabilmesi için bu yönergeyi tüm büyük CMS'lerde kaldırmanın adımlarını açıklıyor. Aynı kontrol, SEOcrawl AI Crawler içinde otomatik olarak çalışır ve URL'leri tek tek kontrol etmeden sitenizin tamamındaki noindex yönergelerini işaretler.
Google Search Console'da "'noindex' etiketiyle hariç tutuldu" ne anlama gelir?
"'noindex' etiketiyle hariç tutuldu" durumu, Googlebot'un sayfanızı taradığı, bir noindex yönergesi bulduğu ve buna uyduğu anlamına gelir; yani sayfayı Google dizininin dışında tutar. Bu yönerge kaldığı sürece sayfanız arama sonuçlarında görünmez.
Bu durum GSC'de nerede görünür?
Eski Kapsam raporunda (2022'de Sayfa dizine ekleme raporuyla değiştirildi) bu durum "Hariç tutuldu" altında yer alıyordu. Güncel Sayfa dizine ekleme raporunda (Dizine ekleme › Sayfalar) bunu "Dizine eklenmedi" altında, "Sayfaların neden dizine eklenmediği" tablosunda, "'noindex' etiketiyle hariç tutuldu" nedeniyle bulursunuz. Google etkilenen tüm URL'leri bu etiket altında gruplar; böylece bunları toplu olarak dışa aktarıp inceleyebilirsiniz.
Google noindex yönergesini nasıl keşfeder ve uygular?
Google'ın noindex ile dizine eklemeyi engelleme belgesi iki iletim yöntemi tanımlar: sayfanın HTML <head> bölümünde bir <meta name="robots" content="noindex"> etiketi ya da HTTP yanıt başlıklarında bir X-Robots-Tag: noindex yönergesi. Googlebot bunlardan herhangi biriyle karşılaştığında, sayfa daha önce dizine eklenmiş olsa bile onu dizinden tamamen çıkarır. Etiketin temelleri için noindex meta etiketi rehberimize göz atın.
Bu her zaman bir sorun mu? Hariç tutma ne zaman bilinçlidir?
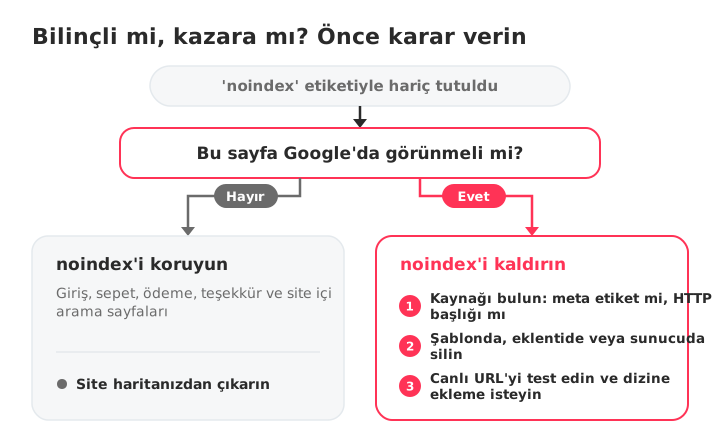
"'noindex' etiketiyle hariç tutuldu" durumundaki her URL bir hata değildir. Yönetim sayfaları, giriş ekranları, sepet ve ödeme akışları, teşekkür sayfaları ve site içi arama sonuçları bilerek Google dizininin dışında tutulur. Bu sayfalar bu durumu gösteriyorsa sistem tasarlandığı gibi çalışıyordur. Asıl sorun, sıralanmasını istediğiniz sayfalar bu etiketi aldığında başlar.
"'noindex' etiketiyle hariç tutuldu" durumunun yaygın nedenleri
Bir noindex yönergesi sayfanıza birkaç farklı yoldan ulaşabilir. Sitenizde hangisinin etkin olduğunu bilmek, çözümü belirler.
<head> içinde "noindex" içeren meta robots etiketi
En yaygın kaynaktır. Sayfanızın HTML'indeki <meta name="robots" content="noindex"> gibi bir satır, Googlebot'a sayfayı dizine eklememesini söyler. Şablona sabit olarak yazılmış olabilir ya da bir CMS, eklenti veya tema işlevi tarafından dinamik olarak eklenebilir.
HTTP yanıt başlıklarında X-Robots-Tag
X-Robots-Tag, meta etiketle tamamen aynı şekilde çalışır, ancak HTML'de değil HTTP yanıt başlığında bulunur. Sunucu yapılandırmaları, CDN kuralları veya .htaccess yönergeleri bunu ekleyebilir. Örneğin:
Header set X-Robots-Tag "noindex"
Bu, kurala uyan her dosyayı etkiler; HTML <head> bölümü olmayan PDF'ler ve görseller de buna dahildir. Yönerge sayfa kaynağında görünmediği için birçok site sahibi bu yolu tamamen gözden kaçırır.
Dizine eklemeyi yanlışlıkla engelleyen CMS ayarları
WordPress'te Ayarlar › Okuma altında "Arama motorlarının bu siteyi dizine eklemesini engelle" adlı bir onay kutusu bulunur. İşaretlendiğinde WordPress sitenin her sayfasına bir robots noindex etiketi ekler. Birçok site sahibi bunu geliştirme sırasında etkinleştirir ve yayına aldıktan sonra kaldırmayı unutur.
Shopify, tema kodu veya uygulamalar aracılığıyla noindex uygulayabilir. Bazı hesap ve sistem sayfaları Shopify tarafından zaten dizin dışında tutulur ve bu doğrudur; ancak bir tema düzenlemesi veya bir SEO uygulaması ürün, koleksiyon ya da blog sayfalarına yanlışlıkla noindex ekleyebilir.
Wix, SEO ayarları arama motorlarının dizine eklemesini engelleyen her sayfaya noindex uygular. Yaygın bir tetikleyici, bir sayfayı çoğaltıp farkında olmadan orijinalin noindex ayarını devralmaktır.
noindex ekleyen eklenti veya tema çakışmaları
SEO eklentileri, noindex'i yazı, sayfa veya içerik türü bazında ayarlamanıza olanak tanır. Yanlış yapılandırılmış bir genel kural, ayarları sıfırlayan bir eklenti güncellemesi veya eklenti yönergelerini geçersiz kılan bir tema, noindex'i tek seferde onlarca sayfaya yayabilir. Yakın zamanda bir eklentiyi güncellediyseniz veya tema değiştirdiyseniz önce bunu kontrol edin.
Canlıya aktarılan staging ortamı ayarları
Kazara eklenen noindex etiketlerinin şaşırtıcı derecede yaygın bir kaynağıdır. Staging siteniz, Google'ın dışında kalmak için noindex kullanır. Derleme süreci staging yapılandırmasını canlı ortama aktardığında noindex yönergesi de onunla birlikte gider. Bu genellikle sitenin bütün bölümlerini aynı anda etkiler ve yalnızca tek tek sayfaları kontrol ediyorsanız teşhis edilmesi en zor nedenlerden biridir.
Hangi sayfaların etkilendiği nasıl teşhis edilir?
Tekrarlanabilir bir teşhis süreci, tahmine gerek kalmadan etkilenen tüm URL'leri yakalar. Liste için Search Console ile başlayın, ardından kaynağı bulmak için tek tek sayfalara inin.
Etkilenen URL'leri dışa aktarmak için Sayfa dizine ekleme raporunu kullanma
Google Search Console'u açın ve Dizine ekleme › Sayfalar bölümüne gidin. "Sayfaların neden dizine eklenmediği" tablosunda "'noindex' etiketiyle hariç tutuldu" satırına tıklayın. Search Console etkilenen URL'lerden bir örnek gösterir; listeyi işlemek üzere indirmek için Dışa aktar düğmesini kullanın.
URL Denetimi aracıyla tek bir URL'yi inceleme
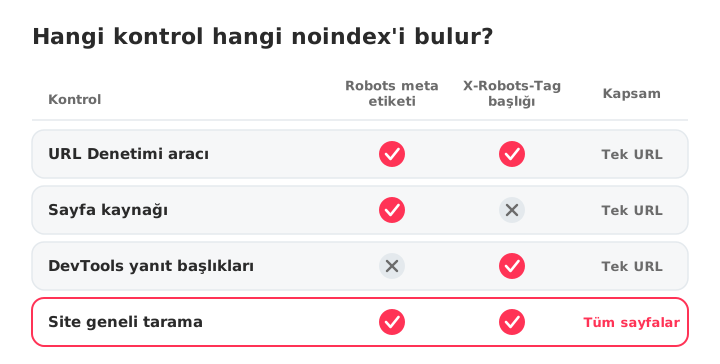
Herhangi bir URL'yi Search Console'un üst kısmındaki arama çubuğuna yapıştırın. URL Denetimi aracı, Google'ın bir noindex yönergesi görüp görmediğini ve onu nerede bulduğunu gösterir: "Dizine eklemeye izin veriliyor mu?" altında noindex'in robots meta etiketinden mi yoksa X-Robots-Tag HTTP başlığından mı geldiğini bildirir. Googlebot'un aldığı HTML'yi tam olarak görmek için Taranan sayfayı görüntüle seçeneğine tıklayın. Bu, tek bir sayfa için mevcut en hızlı kontroldür.
Sayfa kaynağında noindex meta etiketlerini kontrol etme
Sayfayı tarayıcınızda açın, sağ tıklayıp Sayfa kaynağını görüntüle seçeneğini seçin, ardından "noindex" araması yapın (Ctrl+F veya Cmd+F). <meta name="robots" content="noindex"> veya benzerini bulursanız suçlu meta etikettir. Kaynakta bulamazsanız yönerge HTTP başlığından geliyor olabilir.
HTTP başlıklarını kontrol etmek için tarayıcı DevTools'u kullanma
DevTools'u açın (F12 ya da sağ tık › İncele), Network sekmesine gidin, sayfayı yeniden yükleyin ve ana belge isteğine tıklayın. Response Headers bölümünde X-Robots-Tag: noindex arayın. HTML'de görünmeyen, başlık tabanlı noindex yönergelerini tarayıcı içinde yakalamanın tek yolu budur.
Sitenizi Screaming Frog veya SEOcrawl AI ile tarama
Site genelinde teşhis için bir crawler, etkilenen her sayfayı tek seferde yakalar. Screaming Frog SEO Spider, sayfaları meta etiketler ve başlıklar üzerinden dizine eklenebilirliğe göre filtreleyebilir. SEOcrawl AI Crawler her sayfayı tarar, noindex yönergesi olan her sayfayı Dizine eklenebilirlik altında işaretler ve bir Audit Health Score döndürür; böylece elle dışa aktarma ve filtreleme yapmadan tüm kapsamı görürsünüz.
"'noindex' etiketiyle hariç tutuldu" nasıl düzeltilir: adım adım
Bu, en uygulanabilir bölümdür. Önceki bölümdeki teşhisinize uyan çözümü uygulayın.
noindex meta etiketini sayfa kaynağından kaldırma
HTML <head> bölümünden <meta name="robots" content="noindex"> etiketini kaldırmak için sayfa şablonunu veya içeriğini düzenleyin. Özel olarak geliştirilmiş sitelerde şablon dosyalarını doğrudan kontrol edin. Etiket JavaScript ile ekleniyorsa sorumlu betiği bulun ve kaldırın ya da bir koşula bağlayın.
Önce:
<meta name="robots" content="noindex">
Sonra:
<meta name="robots" content="index, follow">
Ya da etiketi tamamen kaldırın. Google, noindex yönergesinin olmamasını "dizine eklemeye izin veriliyor" olarak değerlendirir.
Sunucu veya CDN yapılandırmanızdaki X-Robots-Tag'i düzeltme
.htaccess (Apache), nginx.conf (Nginx) dosyanızı veya CDN kurallarınızı X-Robots-Tag: noindex yönergeleri açısından kontrol edin. Bunları kaldırın ya da dizine eklenmesini istediğiniz sayfalar yerine yalnızca hariç tutulması gereken belirli yollarla sınırlandırın. Örneğin /staging/ üzerinde noindex'i koruyup /blog/ üzerinden kaldırabilirsiniz.
WordPress'te nasıl düzeltilir?
Sırasıyla iki kontrol:
- Site geneli ayar: Ayarlar › Okuma bölümüne gidin ve "Arama motorlarının bu siteyi dizine eklemesini engelle" seçeneğinin işaretini kaldırın. Bu, WordPress'te site genelindeki noindex sorunlarının en yaygın nedenidir.
- SEO eklentilerinde sayfa bazında ayarlar:
- Yoast SEO: yazıyı veya sayfayı açın, Yoast meta kutusuna inin, Advanced sekmesine tıklayın ve "Allow search engines to show this content in search results?" ayarını "Yes" yapın.
- Rank Math: yazıyı açın, Rank Math meta kutusuna gidin, Advanced sekmesine tıklayın ve "Robots Meta" ayarını "Index" yapın.
- All in One SEO: yazıyı düzenleyin, AIOSEO ayarlarının Advanced sekmesini açın ve robots ayarlarında "No Index" seçeneğinin işaretli olmadığından emin olun.
Ayrıca her eklentinin genel ayarlarında noindex olarak ayarlanmış tüm içerik türlerini (etiketler, kategoriler, özel yazı türleri) kontrol edin. WordPress kurulumunun geri kalanı için WordPress'i Google Search Console'a bağlama rehberimize göz atın.
Shopify'da nasıl düzeltilir?
Shopify'da noindex genellikle tema kodundan veya bir uygulamadan gelir. Online Store › Themes › Edit code yolunu açın ve theme.liquid ile sayfa şablonlarında noindex içeren bir robots meta etiketi arayın. Ardından SEO uygulamalarınızda ürünleri, koleksiyonları veya blog yazılarını gizleyen kuralları ve seo.hidden meta alanını kullanan tüm ürün ya da sayfaları kontrol edin. Hesap ve diğer sistem sayfaları Shopify tarafından dizin dışında tutulur ve öyle kalmalıdır.
Wix, Squarespace ve diğer site oluşturucularda nasıl düzeltilir?
Wix: sayfanın SEO ayarlarını (sayfa menüsünden) açın ve "Let search engines index this page" seçeneğini etkinleştirin. Bir sayfayı çoğalttıysanız kopya, orijinalden bir noindex ayarı devralmış olabilir.
Squarespace: site geneli SEO ayarlarında siteyi arama motorlarından gizleyen herhangi bir seçenek olup olmadığını kontrol edin. Tek tek sayfalar için sayfa ayarlarını açın ve SEO sekmesinde "Hide page from search results" seçeneğine bakın. Squarespace, sepet gibi bazı sistem sayfalarını da varsayılan olarak arama sonuçlarının dışında tutar.
Düzeltmeden sonra: Google Search Console'da yeniden dizine ekleme isteme
noindex etiketini kaldırmak Google'a sayfayı dizine ekleyebileceğini söyler, ancak değişikliğin onaylanması için Googlebot'un sayfayı yeniden taraması gerekir.
Dizine ekleme istemek için URL Denetimi aracını kullanma
Düzeltilen URL'yi Search Console arama çubuğuna yapıştırın. Dizine eklemeye artık izin verildiğini doğrulamak için Canlı URL'yi test et seçeneğine, ardından Dizine eklenmesini iste seçeneğine tıklayın. Google URL'yi yeniden tarama kuyruğuna alır. Bu şekilde birden fazla URL gönderebilirsiniz, ancak Search Console günlük istek sayısını sınırlar.
Google'ın bir sayfayı yeniden dizine eklemesi ne kadar sürer?
Genellikle birkaç gün ile birkaç hafta arasında, Googlebot'un sitenizi ne sıklıkla taradığına bağlı olarak. Yüksek trafikli ve sık güncellenen siteler daha hızlı yeniden taranır; yeni veya düşük trafikli siteler haftalarca bekleyebilir. Dizine ekleme istemek gönderebileceğiniz en hızlı sinyaldir ama bir garanti değildir: URL'nizi tarama kuyruğuna koyar, anında yeniden taramayı zorlamaz.
Taramayı hızlandırmak için güncellenmiş bir XML site haritası gönderme
Aynı anda çok sayıda sayfayı düzelttiyseniz Search Console'un Site haritaları bölümünde güncellenmiş bir XML site haritası gönderin. Bu, sitenizin değiştiğini bildirir ve daha kapsamlı bir yeniden taramayı teşvik eder. noindex içeren URL'lerden arındırılmış temiz bir site haritası, bir sonraki bölümde ele aldığımız çelişkili sinyalleri de önler.
noindex etiketini ne zaman korumalısınız (bilinçli hariç tutmalar)
Her noindex etiketinin kaldırılması gerekmez. Bazı sayfalar asla arama sonuçlarında görünmemelidir; bunları dizine eklemek Google'ın sitenize bakışına zayıf veya yinelenen sayfalar ekler ve tarama dikkatini boşa harcar.
Asla dizine eklenmemesi gereken sayfalar
- Giriş ve kayıt sayfaları
- Sepet, ödeme ve sipariş onay sayfaları
- Site içi arama sonuç sayfaları (yinelenen içeriği önlemek için)
- Teşekkür sayfaları (lead magnet'ler, form gönderimleri)
- Yönetim ve arka uç sayfaları
- Staging ve geliştirme ortamları
- Yinelenen URL'ler üreten filtre ve parametre sayfaları
noindex ve robots.txt: temel farklar
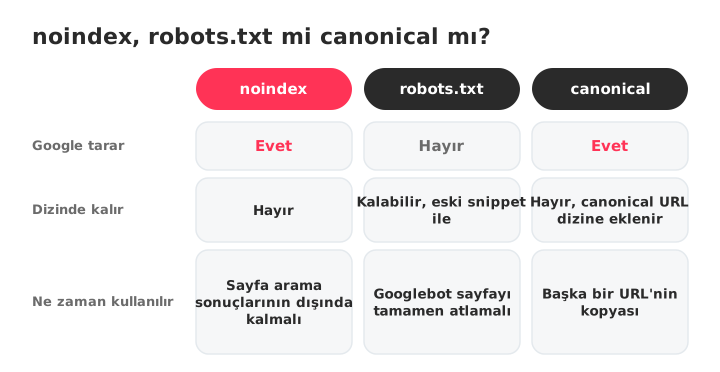
robots.txt taramayı engeller. noindex taramaya izin verir ama dizine eklemeyi engeller. Bir sayfayı robots.txt içinde engellerseniz Googlebot onu hiç okumaz; bu da noindex etiketini de hiç görmeyeceği anlamına gelir. Bir sayfanın dizin dışında kalmasını istiyorsanız noindex kullanın. Googlebot'un sayfayı tamamen atlamasını istiyorsanız (tarama bütçesinden tasarruf etmek için) robots.txt kullanın.
Yaygın bir hata: zaten dizine eklenmiş bir sayfayı engellemek için robots.txt kullanmak. Google sayfayı tarayamıyorsa noindex etiketini göremez; bu yüzden URL eski bir başlık ve snippet ile dizinde kalabilir. Doğru yaklaşım, taramaya izin vermek ve sayfayı dizinden çıkarmak için noindex kullanmaktır.
Canonical etiketleri ve noindex: doğru yönergeyi seçmek
Bir canonical etiketi (rel="canonical") Google'a "bu sayfa şu diğer URL'nin bir kopyası, onun yerine onu sırala" der. Bir noindex etiketi ise Google'a "bu sayfayı hiç dizine ekleme" der. Farklı amaçlara hizmet ederler:
- Yinelenen veya neredeyse yinelenen içeriğiniz varsa ve sıralama sinyallerini tek bir URL'de birleştirmek istiyorsanız canonical kullanın.
- Sayfa hiçbir koşulda arama sonuçlarında görünmemeliyse noindex kullanın.
İkisini aynı sayfada birleştirmek çelişkili sinyaller gönderir: biri "bu sayfayı başka bir URL'ye kat" derken diğeri "onu dizinden çıkar" der. İstediğiniz sonuca uyanı seçin.
Gelecekte kazara eklenen noindex etiketlerini önleme
noindex sorunlarını sonradan düzeltmek gereklidir, ancak onları önlemek saatlerce süren teşhisten ve trafik kaybından kurtarır.
Dizine ekleme düşüşleri için Search Console uyarılarını ayarlama
Google Search Console, bir mülkte yeni dizine ekleme sorunları tespit ettiğinde doğrulanmış sahiplere ve kullanıcılara e-posta gönderir. Search Console e-posta tercihlerinizde e-posta bildirimlerinin açık olduğundan emin olun. Dizine eklenen sayfa sayısı aniden düşerse uyarı, trafik düşmeden önce size zaman kazandırır.
Yayın öncesi QA kontrol listenize noindex kontrolleri ekleme
Herhangi bir siteyi yayına almadan veya staging'i canlı ortama aktarmadan önce noindex yönergelerini kontrol edin. "Sayfa kaynağını görüntüle" ile yapılan ve "noindex" araması içeren 30 saniyelik bir kontrol, en yaygın dağıtım hatasını yakalar. Büyük sitelerde dağıtımdan önce ve sonra tarama yapın ve noindex içeren sayfa sayısını karşılaştırın. Kimsenin atlamaması için bunu teknik SEO kontrol listenize ekleyin.
İstenmeyen noindex yönergelerini yakalamak için zamanlanmış taramalar
İstenmeyen noindex etiketlerini size trafik kaybettirmeden önce yakalamak için düzenli aralıklarla ve her eklenti güncellemesi, tema değişikliği veya taşımadan sonra tam bir tarama çalıştırın. SEOcrawl AI Crawler taramaları karşılaştırmanıza olanak tanır; böylece hangi sayfaların noindex'e geçtiğini ve ne zaman geçtiğini görürsünüz. SEO Monitor ise önemli sayfalarınızdan biri noindex etiketi aldığı anda sizi uyarır.
Sıkça Sorulan Sorular
Google Search Console'da "'noindex' etiketiyle hariç tutuldu" ne anlama gelir?
Google'ın sayfanızda bir noindex yönergesi bulduğu ve buna uyduğu anlamına gelir; bu nedenle sayfa arama sonuçlarında görünmez. Bu durum, Search Console'daki Sayfa dizine ekleme raporunda "Dizine eklenmedi" bölümünde yer alır.
Her zaman bir hata değildir: giriş veya ödeme sayfaları gibi bilerek hariç tuttuğunuz sayfaların bu durumu göstermesi gerekir.
WordPress'te "'noindex' etiketiyle hariç tutuldu" sorununu nasıl düzeltirim?
İki yeri sırasıyla kontrol edin. Önce Ayarlar › Okuma bölümüne gidin ve "Arama motorlarının bu siteyi dizine eklemesini engelle" seçeneğinin işaretli olmadığından emin olun. Ardından etkilenen her yazıyı veya sayfayı SEO eklentinizde (Yoast, Rank Math, All in One SEO) açın ve sayfa bazındaki robots ayarının dizine eklemeye izin verdiğini doğrulayın.
noindex kaldırıldıktan sonra Google'ın sayfayı dizine eklemesi ne kadar sürer?
Genellikle birkaç gün ile birkaç hafta arasında, Googlebot'un sitenizi ne sıklıkla taradığına bağlı olarak. Yönergeyi kaldırdıktan sonra URL Denetimi aracıyla dizine ekleme isteğinde bulunun ve süreci hızlandırmak için güncellenmiş bir XML site haritası gönderin. Yüksek trafikli siteler, yeni veya düşük trafikli sitelere göre daha hızlı yeniden taranır.
Bir sayfa site haritamda olsa bile noindex nedeniyle hariç tutulabilir mi?
Evet. noindex yönergesi site haritasına dahil edilmekten önce gelir. Google URL'yi site haritanızdan taramaya devam edebilir, ancak noindex varken onu dizine eklemez.
Sayfanın dizine eklenebilmesi için noindex'i kaldırın ya da hariç tutma bilinçliyse URL'yi site haritasından çıkarın. noindex içeren URL'leri site haritasında listelemek çelişkili sinyaller gönderir.
noindex ile bir sayfayı robots.txt'de engellemek arasındaki fark nedir?
robots.txt, Googlebot'un sayfayı taramasını engeller; noindex taramaya izin verir ancak dizine eklemeyi engeller. Bir sayfayı robots.txt ile engellerseniz Google noindex etiketini okuyamaz; bu yüzden zaten dizinde olan bir sayfa eski içerikle dizinde kalabilir. Bir sayfayı dizinden çıkarmak için noindex'i, taramayı tamamen engellemek istediğinizde ise yalnızca robots.txt'yi kullanın.
Bir sayfada noindex etiketi olup olmadığını nasıl kontrol ederim?
En hızlıdan en kapsamlıya üç yöntem: Search Console'daki URL Denetimi aracını kullanın, sayfa kaynağını görüntüleyip "noindex" araması yapın (Ctrl+F) ya da tarayıcınızın DevTools aracında HTTP yanıt başlıklarını kontrol edin (Network sekmesi, X-Robots-Tag'e bakın). Başlıkta gönderilen bir noindex'i yalnızca URL Denetimi aracı ve DevTools yakalar.
Birçok sayfa "'noindex' etiketiyle hariç tutuldu" gösteriyorsa endişelenmeli miyim?
Yalnızca bu sayfaların dizine eklenmesi gerekiyorsa. Listeyi Search Console'dan dışa aktarın, bilinçli hariç tutmalarınızla (giriş, sepet, yönetim, teşekkür sayfaları) karşılaştırın ve yalnızca aramada sıralanması gereken sayfaları düzeltin. Etkilenen sayfaların hepsi bilerek hariç tuttuğunuz sayfalarsa durum doğru çalışıyor demektir.
Yazar: David Kaufmann

Son 10 yılı aşkın süredir tamamen SEO'ya kafayı takmış durumdayım — ve açıkçası, başka türlü olmasını da istemezdim.
Kariyerim, internetin tamamında en çok ziyaret edilen ilk 100 site arasında yer alan Chess.com'da Senior SEO Specialist olarak çalıştığım dönemde yeni bir seviyeye ulaştı. Milyonlarca sayfa, onlarca dil ve var olan en rekabetçi SERPs içinde, o ölçekte çalışmak, bana hiçbir kursun ya da sertifikanın öğretemeyeceği şeyler öğretti. Bu deneyim, gerçekten iyi bir SEO'nun nasıl göründüğüne dair bakış açımı kökten değiştirdi — ve o günden sonra kurduğum her şeyin temeli oldu.
Bu deneyimden yola çıkarak SEO Alive'ı kurdum — organik büyüme konusunda ciddi olan markalar için bir ajans. Biz dashboards ve aylık raporlar satmak için burada değiliz. Gerçekten fark yaratan stratejiler kurmak için buradayız; klasik SEO'nun en iyi yanlarını Generative Engine Optimization (GEO) denen heyecan verici yeni dünyayla birleştirerek — markanızın yalnızca Google'ın mavi linklerinde değil, aynı zamanda ChatGPT, Perplexity ve Google AI Overviews'un her gün milyonlarca insana sunduğu AI tarafından üretilen cevapların içinde de görünmesini sağlayarak.
Ve bu iki dünyayı düzgün şekilde ele alan bir araç bulamadığım için, kendim bir tane geliştirdim — SEOcrawl AI, rankings, teknik denetimler, backlinks izleme, crawl sağlığı ve AI marka görünürlüğü takibini tek bir yerde bir araya getiren kurumsal bir SEO intelligence platformu. Hep var olmasını dilediğim platform.
Bu yazarın diğer içeriklerini keşfedin