


«Discovered – currently not indexed»: หมายความว่าอะไรและแก้ไขอย่างไร
Google รู้ว่า URL ของคุณมีอยู่ แต่ยังไม่ได้เข้าไปดู นี่คือวิธีตัดสินว่าควรรอหรือลงมือ และควรลองแก้อะไรก่อนในเว็บไซต์เล็กและใหญ่
Discovered – currently not indexed หมายความว่า Google พบ URL แล้วแต่ ยังไม่ได้รวบรวมข้อมูล นี่คือคำอธิบายจากวิธีใช้รายงานการจัดทำดัชนีหน้าเว็บของ Google โดยทั่วไป Google วางแผนจะรวบรวมข้อมูลแล้วเลื่อนออกไปเพื่อไม่ให้เว็บไซต์ของคุณทำงานหนักเกินไป จึงทำให้ วันที่รวบรวมข้อมูลล่าสุดว่างเปล่า ในรายงาน
นี่คือ สถานะด้านลำดับความสำคัญของการรวบรวมข้อมูล ไม่ใช่คำตัดสินเนื้อหาของคุณ เพราะ Google ยังไม่ได้อ่านหน้าเว็บ ด้านล่างนี้คุณจะเห็นว่ามันต่างจาก «Crawled» อย่างไร สิ่งที่เราพบเมื่อตรวจเว็บไซต์ของตัวเอง และรายการวิธีแก้ที่เรียงตามขนาดเว็บไซต์ เพิ่งเริ่มใช้รายงานนี้ใช่ไหม เริ่มจากคู่มือ Google Search Console นี้ได้เลย
«Discovered – currently not indexed» หมายความว่าอะไร
Google พา URL ผ่านสี่ขั้น: ค้นพบ รวบรวมข้อมูล จัดทำดัชนี แล้วจึงอาจแสดงในผลการค้นหา สถานะสองอย่างใน Search Console อธิบาย URL ที่ติดอยู่กลางทาง
URL เข้าสู่ขั้น «ค้นพบแล้ว» ผ่าน sitemap หรือลิงก์จากหน้าอื่น จากนั้น Google ตัดสินใจว่า เมื่อไร จะรวบรวมข้อมูล «Discovered» หมายความว่าการตัดสินใจนั้นยังไม่เกิดขึ้น
ต่างจาก «Crawled – currently not indexed» อย่างไร
สถานะสองอย่างนี้ดูคล้ายกันแต่ต้องแก้ต่างกัน
| Discovered – currently not indexed | Crawled – currently not indexed | |
|---|---|---|
| Google รวบรวมข้อมูลแล้วหรือไม่ | ยังไม่ | แล้ว |
| วันที่รวบรวมข้อมูลล่าสุด | ว่าง | มีวันที่ |
| Google อ่านหน้าเว็บแล้วหรือไม่ | ยังไม่ | แล้ว |
| เหตุผลที่พบบ่อย | เลื่อนการรวบรวมข้อมูลหรือลำดับความสำคัญต่ำ | Google อ่านหน้าแล้วข้ามไป |
| ดูอะไรก่อน | ลิงก์ภายใน sitemap ความสามารถในการรวบรวมข้อมูล | คุณภาพเนื้อหา เนื้อหาซ้ำ canonical |
การวินิจฉัยสถานะที่สองฉบับเต็มอยู่ในคู่มือ Crawled – currently not indexed
รายการหน้าตาเป็นอย่างไรในเว็บไซต์จริง
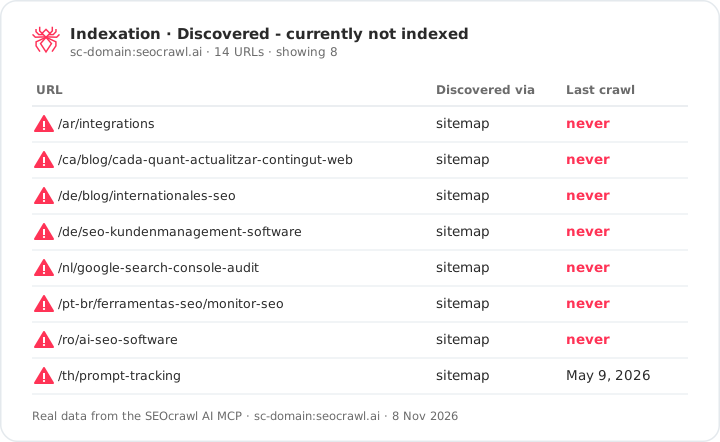
เราตรวจ seocrawl.ai ในรายงานการจัดทำดัชนีของ SEOcrawl จาก 1,000 URL ที่ SEOcrawl ติดตาม (sitemap ของเราระบุไว้ 6,310) มี 823 รายการที่จัดทำดัชนีแล้ว หรือ 82.3% อีก 128 รายการอยู่ใน «Crawled – currently not indexed» และ 14 รายการอยู่ใน «Discovered – currently not indexed»
สิ่งที่ทั้ง 14 รายการมีร่วมกันคือส่วนที่เป็นประโยชน์:
- ทั้งหมดเป็นหน้าที่แปลแล้ว: อาหรับ คาตาลัน เยอรมัน เอสโตเนีย ลิทัวเนีย ดัตช์ โปรตุเกส (บราซิล) โรมาเนีย และไทย ไม่มีหน้าใดเป็นภาษาอังกฤษ
- Google พบทั้ง 14 รายการผ่าน sitemap ไม่ใช่ผ่านลิงก์จากหน้าอื่น
- มีหนึ่งรายการที่แสดงวันที่รวบรวมข้อมูลก่อนหน้า (9 พฤษภาคม 2026) ดังนั้นสถานะนี้บอกว่า URL อยู่ตรงไหนในตอนนี้ ไม่ได้แปลว่า Google ไม่เคยเข้ามาเลย
นี่คือรูปแบบที่ต้องตรวจสอบ ไม่ใช่การวินิจฉัย หน้าที่มีอยู่ใน 26 ภาษาและเข้าถึงได้ส่วนใหญ่ผ่าน sitemap เป็นตัวเลือกตามธรรมชาติของลิงก์ภายในที่อ่อน ลิงก์ภายในจึงเป็นสิ่งแรกที่ควรดู บทเรียนนี้ใช้ได้กับทุกเว็บไซต์: อย่าอ่านรายการทีละ URL เมื่อจัดกลุ่มตามภาษา 14 URL กลายเป็นคำถามเดียว
ตัวเลขครอบคลุม 1,000 URL ที่ SEOcrawl ติดตาม ซึ่งเป็นตัวอย่างของ sitemap ทั้งหมด กลุ่มที่ใหญ่กว่า 128 URL เป็นอีกสถานะหนึ่งและมีคู่มือของตัวเอง
ทำไม Google จึงเลื่อนการรวบรวมข้อมูล
คู่มือ crawl budget ของ Google อธิบายว่า Google ตัดสินใจรวบรวมข้อมูลมากน้อยแค่ไหน: ขีดจำกัดความสามารถ ที่เซิร์ฟเวอร์ของคุณรับไหว และ ความต้องการ สำหรับ URL ของคุณ URL ที่ค้นพบส่วนใหญ่สืบกลับไปได้ที่หนึ่งในห้าสาเหตุนี้
- ความสามารถในการรวบรวมข้อมูล Google ระบุว่าขีดจำกัดลดลงเมื่อเว็บไซต์ช้าลงหรือส่งข้อผิดพลาดของเซิร์ฟเวอร์ เซิร์ฟเวอร์ช้าหมายถึงการรวบรวมข้อมูลน้อยลง
- ความต้องการรวบรวมข้อมูลต่ำ ความต้องการขึ้นอยู่กับขนาดเว็บไซต์ ความถี่ในการอัปเดต และคุณภาพกับความเกี่ยวข้องของหน้า URL ที่มีลิงก์ภายในน้อยหรือไม่มีเลยทำให้ Google มีเหตุผลน้อยที่จะกลับมาเร็ว ๆ
- การรวบรวมข้อมูลที่สูญเปล่า URL ซ้ำ พารามิเตอร์ ฟาเซต เชนการเปลี่ยนเส้นทางยาว ๆ และ soft 404 แย่งกับหน้าจริงของคุณ Google ระบุว่า soft 404 ยังคงถูกรวบรวมข้อมูลและสิ้นเปลืองงบ และหน้าที่มี noindex ก็ยังถูกร้องขอก่อนจะถูกทิ้ง
- พบผ่าน sitemap เท่านั้น sitemap บอก Google ว่ามี URL อยู่ แต่ไม่ได้ทำให้เป็นเรื่องสำคัญ และ Google ถือว่า sitemap เป็นเพียงคำใบ้ หน้าที่พบที่นั่นที่เดียวคือหน้าแรกที่ต้องรอ
- เว็บไซต์หรือส่วนใหม่ ทุกเว็บไซต์เริ่มด้วยขีดจำกัดความสามารถเริ่มต้นที่ระมัดระวังเท่ากัน ซึ่งจะเพิ่มขึ้นเมื่อเว็บไซต์พิสูจน์ว่าแข็งแรง
ตัว crawl budget เองควรค่าแก่ความสนใจของคุณเฉพาะใน เว็บไซต์ขนาดใหญ่มาก ค่าประมาณคร่าว ๆ ของ Google: 1,000,000+ หน้าที่ไม่ซ้ำกัน ซึ่งอัปเดตราวสัปดาห์ละครั้ง หรือ 10,000+ หน้า ที่เปลี่ยนแปลงทุกวัน ในเว็บไซต์ขนาดเล็ก สาเหตุข้อ 2 และ 4 พบบ่อยกว่ามาก
เป็นปัญหาหรือไม่ สามคำถามก่อนแก้อะไร
- URL นี้ควรได้รับการจัดทำดัชนีจริงหรือไม่ หากเป็นมุมมองที่กรองแล้ว หน้าค้นหาภายใน หรือ URL ทดสอบ การที่ไม่อยู่ในดัชนีเป็นเรื่องปกติ หากต้องการระบุให้ชัดเจน ให้ใช้ noindex หรือส่งรหัส 404 หรือ 410 (ดู Excluded by 'noindex' tag)
- มีกี่ URL และเป็นรูปแบบใด Google ระบุว่าหากมี น้อยกว่า 500 หน้า คุณอาจไม่จำเป็นต้องใช้รายงานนี้เลย รายการยัง จำกัดที่ 1,000 แถว ดังนั้นในเว็บไซต์ขนาดใหญ่จึงเป็นเพียงตัวอย่าง
- เป็น URL ใหม่หรือไม่ URL ที่เผยแพร่เมื่อสัปดาห์ที่แล้วยังไม่ใช่ปัญหา ช่วงเวลาของ Google เองอยู่ในตารางด้านล่าง
วิธีแก้ตามขนาดเว็บไซต์
มาตรการแรกที่ถูกต้องขึ้นอยู่กับขนาดเว็บไซต์ของคุณ ดังนั้นเริ่มจากคอลัมน์ที่ใช่
เว็บไซต์ส่วนใหญ่: ไม่เกินราว 10,000 URL
- ยืนยันว่า URL สมควรได้รับการจัดทำดัชนี หากไม่ ให้ใช้ noindex หรือลบออกแล้วขีดฆ่าจากรายการของคุณ
- ใส่ลิงก์จากหน้าที่ Google รวบรวมข้อมูลอยู่แล้ว เพิ่มลิงก์ตามบริบทพร้อมข้อความลิงก์ที่สื่อความหมายจากหน้าที่จัดทำดัชนีแล้วและมีทราฟฟิก ตัวรวบรวมข้อมูลทุกตัวแสดงหน้าเว็บกำพร้าของคุณได้โดยกรองหน้าที่ไม่มีลิงก์ภายใน และคู่มือลิงก์ภายในนี้มีวิธีการครบถ้วน
- รักษา sitemap ให้สะอาด ใส่เฉพาะ URL ที่ส่งรหัส 200 จัดทำดัชนีได้ และเป็นเวอร์ชัน canonical พร้อม
lastmodที่ถูกต้อง Google ไม่สนใจ priority และ changefreq หากยังต้องการไฟล์ก่อน ให้หา sitemap ของคุณ หาก Search Console แจ้งว่าไม่พบเลย ดู No referring sitemaps detected - ขอให้จัดทำดัชนี URL สำคัญเพียงไม่กี่รายการ เปิดเครื่องมือตรวจสอบ URL แล้วคลิก ขอให้จัดทำดัชนี Google กำหนดโควต้าและระบุว่าการร้องขอซ้ำไม่ได้ทำให้เร็วขึ้น จึงควรเก็บไว้สำหรับหน้าที่สำคัญที่สุด
เว็บไซต์ใหญ่หรือเปลี่ยนแปลงเร็ว: URL เปลี่ยน 10,000+ รายการต่อวัน หรือ 1 ล้าน+ ต่อสัปดาห์
- ลดการรวบรวมข้อมูลที่สูญเปล่า บล็อกใน robots.txt พื้นที่ URL ที่ไม่มีคุณค่าต่อการค้นหา (พารามิเตอร์ ฟาเซต การค้นหาภายในเว็บ) และรวมหน้าซ้ำด้วย canonical และการเปลี่ยนเส้นทาง 301 อย่าคาดหวังว่า noindex จะประหยัดงบ: Google ยังคงร้องขอหน้าเหล่านั้น
- ส่งรหัส 404 หรือ 410 สำหรับหน้าที่ลบและแก้ soft 404 Google เรียก 404 ว่าเป็นสัญญาณที่แข็งแรงว่าไม่ควรรวบรวมข้อมูล URL ซ้ำ ขณะที่ URL ที่ถูกบล็อกจะอยู่ในคิวนานกว่า ลดเชนการเปลี่ยนเส้นทางที่ยาวทุกเชน
- ตรวจสถิติการรวบรวมข้อมูล ในการตั้งค่า รายงานสถิติการรวบรวมข้อมูลแสดงเวลาตอบสนองและข้อผิดพลาดของเซิร์ฟเวอร์ หากสูง Google จะลดขีดจำกัดความสามารถของคุณ และไม่มีการแก้เนื้อหาใดช่วยได้จนกว่าเซิร์ฟเวอร์จะดีขึ้น
- แก้ตามโฟลเดอร์หรือเทมเพลต แล้วตรวจสอบกลุ่ม ตัดสินใจหนึ่งครั้งต่อหนึ่งรูปแบบ สร้าง sitemap เฉพาะ URL ที่แก้แล้ว และคลิก ตรวจสอบการแก้ไข อ่านเพิ่มเติมเกี่ยวกับ crawl budget หากเว็บไซต์ของคุณอยู่ในกลุ่มนี้
รอหรือลงมือ
ส่วนที่ยากที่สุดไม่ใช่การแก้ไข แต่คือการรู้ว่าเมื่อไรควรเลิกรอ ใช้ช่วงเวลาของ Google เองและแนวโน้มของคุณเอง
| สิ่งที่คุณทำ | สิ่งที่ Google ระบุ | แหล่งที่มา |
|---|---|---|
| ขอให้ Google รวบรวมข้อมูลอีกครั้ง | ไม่กี่วันถึงไม่กี่สัปดาห์ | ขอให้ Google รวบรวมข้อมูลอีกครั้ง |
| ขอให้จัดทำดัชนี | โดยปกติราวหนึ่งวัน นานสุดหนึ่งถึงสองสัปดาห์ มีโควต้ารายวัน | วิธีใช้การตรวจสอบ URL |
| ตรวจสอบการแก้ไข | ถึงราวสองสัปดาห์ บางครั้งนานกว่ามาก | วิธีใช้การจัดทำดัชนีหน้าเว็บ |
ช่วงเวลาเป็นของ Google กฎการรอหรือลงมือเป็นของเรา: รอ ตราบที่ URL เป็นของใหม่และกลุ่มคงที่หรือหดลง และ ลงมือ เมื่อกลุ่มเพิ่มขึ้นเรื่อย ๆ หรือหน้าสำคัญของคุณยังติดอยู่หลังผ่านช่วงสัปดาห์เหล่านั้น
วิธีติดตามต่อเนื่อง
Search Console แสดง สถานะล่าสุด ของแต่ละ URL และรายการที่จำกัดที่ 1,000 แถว ดังนั้นควรสร้างกิจวัตรของคุณเอง:
- ส่งออกรายการเดือนละครั้ง แล้วเทียบกับครั้งก่อน กลุ่มเพิ่มขึ้น คงที่ หรือหดลง
- จัดกลุ่มตามรูปแบบ (ภาษา โฟลเดอร์ เทมเพลต) ก่อนดู URL ทีละรายการ
- ดูว่า Google พบแต่ละ URL อย่างไร รายการที่เป็น «sitemap» ทั้งหมดและไม่มี «หน้าอ้างอิง» เลย เหมือน 14 URL ของเรา ชี้ตรงไปที่ลิงก์ภายใน
มุมมอง การจัดทำดัชนี ของ SEOcrawl AI ให้รายการนั้นแบบพร้อมใช้: กรองตามสถานะความครอบคลุมเพื่อดู URL ในสถานะนั้น พร้อมวันที่รวบรวมข้อมูลล่าสุด คลิก และการแสดงผล เมื่อใช้ผ่าน MCP แต่ละ URL จะมี canonical ที่ Google เลือกเทียบกับที่ประกาศไว้ และข้อมูลว่าพบผ่าน sitemap หรือหน้าอ้างอิง Crawler ตรวจสอบหน้าเว็บของคุณเอง คุณจึงเห็นว่า URL อ่อนตรงไหนก่อนจะขอให้ Google มาดูอีกครั้ง และ SEO Monitor แจ้งเตือนเมื่อหน้าสำคัญมี noindex เปลี่ยน canonical ส่งรหัส 404 หรือหายไปจาก sitemap
นี่คือรายการนั้นสำหรับเว็บไซต์ของเราเอง ตรงจากมุมมองการจัดทำดัชนี:
คุณจะข้ามแดชบอร์ดไปเลยก็ได้ เมื่อเชื่อม SEOcrawl AI MCP กับ Claude หรือ ChatGPT ให้ถามว่า: «แสดง URL ในสถานะ Discovered – currently not indexed และจัดกลุ่มตามโฟลเดอร์» นี่คือขั้นตอนเชื่อม Search Console กับ Claude และ ChatGPT
คำถามที่พบบ่อย
«Discovered – currently not indexed» หมายความว่าอะไร
หมายความว่า Google พบ URL ของคุณแล้วแต่ยังไม่ได้รวบรวมข้อมูล โดยทั่วไป Google วางแผนจะรวบรวมข้อมูลแล้วเลื่อนออกไป จึงทำให้วันที่รวบรวมข้อมูลล่าสุดว่างเปล่า (วิธีใช้การจัดทำดัชนีหน้าเว็บ) Google ยังไม่ได้อ่านหน้าเว็บ ดังนั้น สถานะนี้ไม่ได้บอกอะไรเกี่ยวกับคุณภาพของหน้า และไม่ใช่การลงโทษ
«Discovered – currently not indexed» ใช้เวลานานแค่ไหน
Google ไม่ได้เผยแพร่กรอบเวลาสำหรับสถานะนี้ Google ระบุว่าการรวบรวมข้อมูลซ้ำที่ร้องขอใช้เวลาไม่กี่วันถึงไม่กี่สัปดาห์ และการตรวจสอบการแก้ไขใช้เวลาถึงราวสองสัปดาห์ บางครั้งนานกว่ามาก URL ใหม่อาจต้องการเวลาช่วงนั้นเท่านั้น หากกลุ่มเพิ่มขึ้นเรื่อย ๆ เมื่อคุณเผยแพร่ ให้เลิกรอและลงมือ
การขอให้จัดทำดัชนีแก้ได้ไหม
ช่วยได้กับ URL สำคัญไม่กี่รายการ เพราะเป็นการขอให้ Google เอาหน้าเข้าคิว แต่ไม่ได้กำจัดสาเหตุ หน้าจึงอาจกลับไปสู่สถานะเดิม คำขอมีโควต้ารายวัน และ Google ระบุว่าการส่ง URL เดิมซ้ำหลายครั้งไม่ได้ทำให้เร็วขึ้น ใช้ หลังจากปรับปรุงลิงก์ภายในแล้ว และอย่าใช้เป็นเครื่องมือจำนวนมากเด็ดขาด
เป็นการลงโทษหรือไม่
ไม่ใช่ การดำเนินการด้วยตนเองมีรายงานแยกต่างหาก สถานะนี้หมายความว่า Google พบ URL แล้วแต่ยังไม่ได้รวบรวมข้อมูล จึงยังไม่ได้ประเมินหน้าเว็บ สาเหตุมักเป็นลำดับความสำคัญของการรวบรวมข้อมูล: ลิงก์ภายในอ่อน เซิร์ฟเวอร์ช้า หรือ URL คุณค่าต่ำจำนวนมากที่แย่งกันรวบรวมข้อมูล
ทำไมหน้าของฉันจำนวนมากจึงถูกค้นพบแต่ยังไม่ได้จัดทำดัชนี
จำนวนที่สูงมักชี้ไปที่ รูปแบบ ไม่ใช่หน้าเดี่ยว ๆ: พารามิเตอร์ของ URL หรือฟาเซต หน้าซ้ำ sitemap ที่มี URL ที่ไม่ควรอยู่ ลิงก์ภายในที่อ่อนไปยังทั้งส่วน หรือเซิร์ฟเวอร์ที่ทำให้ Googlebot ช้าลง จัดกลุ่ม URL ตามโฟลเดอร์ ภาษา หรือเทมเพลต ก่อนดูรายการใดรายการหนึ่งเดี่ยว ๆ
ควรกังวลในเว็บไซต์เล็กหรือไม่
โดยปกติไม่ Google ระบุว่าหากเว็บไซต์ของคุณมี น้อยกว่า 500 หน้า คุณอาจไม่จำเป็นต้องใช้รายงานการจัดทำดัชนีหน้าเว็บเลย URL ใหม่ไม่กี่รายการในสถานะนี้ส่วนใหญ่แค่ต้องการเวลาและลิงก์ภายในจากหน้าที่ Google รวบรวมข้อมูลอยู่แล้วสักสองสามลิงก์
SEOcrawl AI ช่วยเรื่อง URL ที่ค้นพบได้อย่างไร
มุมมอง การจัดทำดัชนี ของ SEOcrawl AI แสดงรายการ URL ที่ติดอยู่ในแต่ละสถานะความครอบคลุมของ Google พร้อม วันที่รวบรวมข้อมูลล่าสุด คลิก และการแสดงผล ผ่าน SEOcrawl AI MCP คุณยังขอให้ Claude หรือ ChatGPT สร้างรายการนั้นพร้อม canonical ของ Google เทียบกับที่ประกาศไว้ และข้อมูลว่า Google พบแต่ละ URL ผ่าน sitemap หรือหน้าอ้างอิง โดยจัดกลุ่มตามโฟลเดอร์ได้ด้วย
ดู SEOcrawl AI เพิ่มเติมบน Google
เลือกเราเป็นแหล่งที่มาที่ต้องการ แล้วคุณจะเห็นบทความของเรามากขึ้นในเรื่องเด่นของ Google
โดย: David Kaufmann
ในช่วง 10+ ปีที่ผ่านมา ผมหมกมุ่นกับ SEO อย่างสมบูรณ์ — และพูดตรง ๆ ก็ไม่อยากให้เป็นแบบอื่น
อาชีพของผมก้าวขึ้นไปอีกระดับเมื่อทำงานเป็นผู้เชี่ยวชาญ SEO อาวุโสที่ Chess.com — หนึ่งใน 100 เว็บไซต์ที่มีผู้เข้าชมมากที่สุดในอินเทอร์เน็ต การทำงานในระดับนี้สอนสิ่งที่ไม่มีหลักสูตรหรือประกาศนียบัตรใดสอนได้
จากประสบการณ์นี้ ผมก่อตั้ง SEO Alive — เอเจนซีสำหรับแบรนด์ที่จริงจังกับการเติบโตแบบออร์แกนิก และเพราะหาเครื่องมือที่จัดการทั้งโลกคลาสสิกและยุค AI ได้ดีไม่ได้ ผมจึงสร้าง SEOcrawl AI ขึ้น หากคุณกำลังมองหาพาร์ตเนอร์ SEO มากประสบการณ์ที่รักสาขานี้ — ยินดีพูดคุยครับ!
ค้นพบเนื้อหาเพิ่มเติมของผู้เขียนคนนี้
เราวัดคลิกจาก Google และทราฟฟิกที่ผู้ช่วย AI ส่งต่อมาจากกว่า 16,000 เว็บไซต์ใน 15 อุตสาหกรรม ทราฟฟิกจาก AI เพิ่มขึ้น 45% ต่อปี แต่ยังเท่ากับราว 1 การเข้าชมต่อทุก 100 ครั้งจาก Google ขณะที่คลิกจาก Google ลดลง 15%

ถึงวันที่ 30 พฤศจิกายน ปีแรกของแพ็กเกจรายปี SEOcrawl AI ทุกแพ็กเกจลดครึ่งราคาด้วยโค้ด BLACKFRIDAY2026 คุณจะได้อะไร พรอมต์ในแต่ละแพ็กเกจครอบคลุมอะไร และดูได้ใน 15 นาทีว่า ChatGPT, Gemini, Claude และ Perplexity พูดถึงคุณที่ไหน